Inventárne tímy
Zhromažďovanie identifikátorov produktov
Čítajte hodnoty čiarových kódov z baliacich listov PDF a produktových dokumentov.
Prečítajte kódy. Nájdite ich strany. Exportujte užitočné údaje.
Nájdite čiarové kódy na kontrolu údajov. Štart pred exportom aj skenuje.
Súbor obsahuje kódy, ktoré zodpovedajú vašim aktuálnym filtrom.
Otvorte digitálne alebo naskenované PDF, alebo vyskúšajte vzorku so zmiešanými čiarovými kódmi.
Kliknite na Nájsť čiarové kódy. Porovnajte obrázky s dekódovanými hodnotami, filtrujte výsledky a kliknite na obrázok alebo číslo strany, aby ste našli jeho zdroj.
Vyberte formát údajov alebo PDF s obrázkami čiarových kódov, potom kliknite na Štart. Štart v prípade potreby aj skenuje.
Nástroj Extrahovať čiarové kódy z PDF dekóduje viditeľné 1D a 2D symboly, vrátane QR kódov, v celom dokumente. Porovnajte každú hodnotu s jej zdrojovým obrázkom, lokalizujte jej stranu a exportujte do CSV, JSON alebo textu. Môžete tiež zhromaždiť orezané obrázky čiarových kódov do nového PDF. Všetko prebieha vo vašom zariadení.
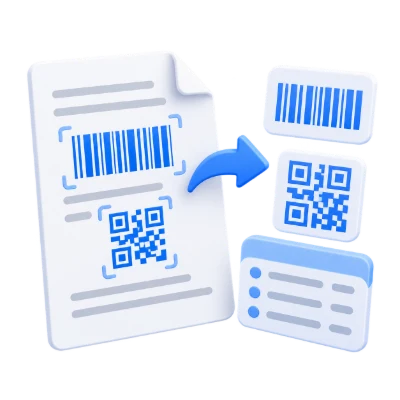
Čítajte hodnoty čiarových kódov z baliacich listov PDF a produktových dokumentov.
Zhromažďujte identifikátory sledovania alebo balíkov a ponechajte si ich zdrojové čísla strán.
Exportujte JSON s umiestneniami alebo zoznam CSV na kontrolu v tabuľkovom procesore.
Zbierajte viditeľné čiarové kódy bez potreby vrstvy s voliteľným textom.
Nástroj číta rodiny Code 128, Code 39, Code 93, Codabar, EAN/UPC, ITF, DataBar, QR, Data Matrix, PDF417 a Aztec. Použiť možno skenované aj digitálne PDF.
„Nájsť čiarové kódy“ alebo „Štart“ spustí skenovanie celého dokumentu. Detekcia využíva lokálne obrázky strán pri rozlíšení do 200 dpi s obmedzenými rozmermi. Najlepšie fungujú jasné, dostatočne veľké kódy; poškodené, zakryté alebo veľmi malé symboly môžu byť vynechané.
Nájdite akýkoľvek výsledok na jeho pôvodnej strane PDF.
Údaje uvádzajú každý výskyt s číslom strany, typom čiarového kódu a dekódovaným textom. Kliknutím na číslo strany prepnete na Ukážku a zvýrazníte jej umiestnenie. Zodpovedajúce miniatúry sú zafarbené na žlto. Opakované hodnoty zostávajú samostatnými výskytmi.
Vyhľadávanie filtruje dekódovaný text bez ohľadu na veľkosť písmen. Filter typu čiarového kódu oddeľuje 1D a 2D kódy. Tieto filtre aktualizujú zoznam a stiahnutie bez opätovného skenovania PDF.
Vyberte CSV, JSON, text alebo PDF obsahujúce zistené obrázky čiarových kódov.
CSV má stĺpce Strana, Typ a Hodnota a značku poradia bajtov UTF-8. Importujte Hodnotu ako Text v Exceli, aby ste zachovali úvodné nuly a dlhé čísla. Hodnoty pripomínajúce vzorce majú pre bezpečnosť tabuliek predponu apostrof.
JSON zachováva dekódované hodnoty s číslami strán, formátmi a normalizovanými hranicami x/y/šírka/výška. TXT uvádza každú hodnotu s jej stranou a typom. „Kopírovať“ skopíruje iba aktuálne filtrované hodnoty. Dekódované odkazy sa nikdy neotvárajú automaticky.
PDF s obrázkami čiarových kódov oreže zistené symboly z pôvodného vykreslenia strany, ponechá malý okraj a umiestni štyri obrázky na stranu A4 s číslami zdrojových strán. Nasleduje aktuálne filtre a podporuje až 400 kódov / 50 MB obrázkov. Ide o rastrové obrázky, nie o regenerované vektory čiarových kódov. Export PDF bez zhody vás vyzve na úpravu filtrov alebo zdroja.
Ponechajte zdrojové PDF a dekódovaný obsah vo svojom zariadení.
Nástroj akceptuje jedno PDF do 100 MB a 750 strán. Neexistuje žiadna služba nahrávania ani vzdialeného dekódovania. Text správne kódovaný ako arabčina v QR kódoch je zachovaný v rozhraní a exportoch UTF-8.
Detekcia je obmedzená na menej ako 100 kódov na stranu a najviac 5 000 na dokument, s maximálne 8 192 znakmi na hodnotu. Exporty CSV a JSON bez zhody sú prázdne reporty. PDF súbory chránené heslom musia byť najprv odomknuté.
Otvorte jeden PDF súbor do 100 MB a 750 strán. Pre zložité dokumenty môžu platiť dodatočné limity pre výstup, pamäť a spracovanie.
Spracovanie prebieha vo vašom zariadení bez nahratia dokumentu. Výsledok si stiahnite pred zatvorením stránky; originál si ponechajte oddelene.
Vedzte, čo môžete očakávať, skôr než začnete.
Súkromné spracovanieÁno. Otvorte PDF a kliknite na Nájsť čiarové kódy. Hodnoty QR sa zobrazia v časti Údaje s odkazom na zdrojovú stranu.
Áno. Číta obrázky strán a nevyžaduje OCR ani vyberateľný text. Čiarový kód musí byť dostatočne jasný na dekódovanie.
Zvoľte CSV. Importujte stĺpec Hodnota ako Text v Exceli, aby ste zachovali úvodné nuly a dlhé číselné identifikátory. CSV nie je zošit XLSX.
Nie. Každý zistený výskyt je uvedený s číslom strany. Filtre určujú, ktoré výsledky sa skopírujú alebo stiahnu.
Nie. Hodnoty sa zobrazujú iba ako text. Hodnoty typu skript alebo URL sa nespúšťajú ani neotvárajú.
Áno, ak QR kód používa podporované kódovanie textu. Arabský text zostáva neporušený v exportoch UTF-8 CSV, JSON a text.
Skúste jasnejší dokument alebo upravte filtre. CSV a JSON možno stále stiahnuť ako prázdne prehľady; výsledky bez zhody nedokazujú, že dokument neobsahuje žiadne čiarové kódy.
Áno. Zvoľte PDF s obrázkami čiarových kódov pod možnosťou CSV. Aktuálne zhodné kódy sa orežú zo zdrojových strán a umiestnia do nového PDF, štyri na stranu s odkazmi na zdrojové strany. Týmto spôsobom možno exportovať až 400 kódov.