ინვენტარიზაციის გუნდები
პროდუქტის იდენტიფიკატორების შეგროვება
წაიკითხეთ შტრიხკოდის მნიშვნელობები PDF შეფუთვის სიებიდან და პროდუქტის დოკუმენტებიდან.


წაიკითხეთ კოდები. იპოვეთ მათი გვერდები. გააკეთეთ სასარგებლო მონაცემების ექსპორტი.
იპოვეთ შტრიხკოდები მონაცემების შესამოწმებლად. „დაწყება“ ასევე ასკანერებს ექსპორტამდე.
ფაილი შეიცავს კოდებს, რომლებიც შეესაბამება თქვენს მიმდინარე ფილტრებს.
გახსენით ციფრული ან დასკანერებული PDF, ან სცადეთ შერეული შტრიხკოდების ნიმუში.
დააწკაპუნეთ „შტრიხკოდების პოვნა“-ზე. შეადარეთ გამოსახულებები გაშიფრულ მნიშვნელობებს, გაფილტრეთ შედეგები და დააწკაპუნეთ გამოსახულებაზე ან გვერდის ნომერზე მისი წყაროს საპოვნელად.
აირჩიეთ მონაცემთა ფორმატი ან PDF შტრიხკოდების გამოსახულებებით, შემდეგ დააწკაპუნეთ „დაწყება“-ზე. „დაწყება“ ასევე ასკანერებს საჭიროების შემთხვევაში.
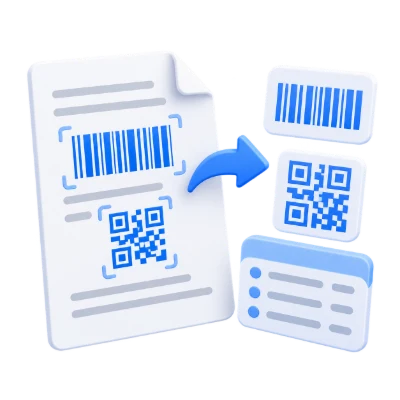
Extract Barcodes from PDF ახდენს თქვენს დოკუმენტში არსებული ხილული 1D და 2D სიმბოლოების, მათ შორის QR კოდების დეკოდირებას. შეადარეთ თითოეული მნიშვნელობა მის წყარო გამოსახულებას, იპოვეთ მისი გვერდი და გააკეთეთ ექსპორტი CSV, JSON ან ტექსტურ ფორმატში. თქვენ ასევე შეგიძლიათ შეაგროვოთ ამოჭრილი შტრიხკოდების გამოსახულებები ახალ PDF-ში. ყველაფერი მუშაობს თქვენს მოწყობილობაზე.
წაიკითხეთ შტრიხკოდის მნიშვნელობები PDF შეფუთვის სიებიდან და პროდუქტის დოკუმენტებიდან.
შეაგროვეთ თრექინგის ან პაკეტის იდენტიფიკატორები და შეინახეთ მათი წყარო გვერდის ნომრები.
გააკეთეთ JSON ექსპორტი მდებარეობებით ან CSV სია განსახილველად ცხრილებში.
შეაგროვეთ ხილული შტრიხკოდები არჩევითი ტექსტური ფენის საჭიროების გარეშე.
ინსტრუმენტი კითხულობს Code 128, Code 39, Code 93, Codabar, EAN/UPC, ITF, DataBar, QR, Data Matrix, PDF417 და Aztec ოჯახებს. შესაძლებელია როგორც დასკანირებული, ისე ციფრული PDF-ების გამოყენება.
„შტრიხკოდების პოვნა“ ან „დაწყება“ იწყებს მთელი დოკუმენტის სკანირებას. აღმოჩენა იყენებს ლოკალურ გვერდის სურათებს 200 dpi-მდე შეზღუდული ზომებით. მკაფიო, ადეკვატური ზომის კოდები საუკეთესოდ მუშაობს; დაზიანებული, დაფარული ან ძალიან პატარა სიმბოლოები შეიძლება გამოგვრჩეს.
იპოვეთ ნებისმიერი შედეგი მის ორიგინალ PDF გვერდზე.
მონაცემები ჩამოთვლის თითოეულ შემთხვევას გვერდის ნომრით, შტრიხკოდის ტიპით და დეკოდირებული ტექსტით. დააწკაპუნეთ გვერდის ნომერზე გადახედვაზე გადასასვლელად და მისი მდებარეობის გამოსაკვეთად. შესაბამისი ესკიზები შეღებილია ყვითლად. განმეორებადი მნიშვნელობები რჩება ცალკეულ შემთხვევებად.
ძიება ფილტრავს დეკოდირებულ ტექსტს ასოების რეგისტრის განსხვავებების გარეშე. შტრიხკოდის ტიპის ფილტრი ჰყოფს 1D და 2D კოდებს. ეს ფილტრები ანახლებს სიას და ჩამოტვირთვას PDF-ის ხელახალი სკანირების გარეშე.
აირჩიეთ CSV, JSON, ტექსტი ან PDF, რომელიც შეიცავს აღმოჩენილ შტრიხკოდის სურათებს.
CSV-ს აქვს გვერდის, ტიპის და მნიშვნელობის სვეტები და UTF-8 ბაიტის თანმიმდევრობის ნიშანი. იმპორტირეთ „მნიშვნელობა“ როგორც ტექსტი Excel-ში, რათა შეინარჩუნოთ წამყვანი ნულები და გრძელი რიცხვები. ფორმულის მსგავსი მნიშვნელობები წინ უსწრებს აპოსტროფს ცხრილების უსაფრთხოებისთვის.
JSON ინახავს დეკოდირებულ მნიშვნელობებს გვერდის ნომრებით, ფორმატებით და ნორმალიზებული x/y/სიგანე/სიმაღლის საზღვრებით. TXT ჩამოთვლის თითოეულ მნიშვნელობას თავისი გვერდით და ტიპით. „კოპირება“ აკოპირებს მხოლოდ ამჟამად გაფილტრულ მნიშვნელობებს. დეკოდირებული ბმულები არასოდეს იხსნება ავტომატურად.
შტრიხკოდის სურათების მქონე PDF ჭრის აღმოჩენილ სიმბოლოებს ორიგინალი გვერდის რენდერიდან, ინარჩუნებს მცირე მიმდებარე ზღვარს და ათავსებს ოთხ სურათს A4 გვერდზე მათი წყარო გვერდის ნომრებით. ის მიჰყვება მიმდინარე ფილტრებს და მხარს უჭერს 400-მდე კოდს / 50 მბ სურათებს. ეს არის რასტრული სურათები და არა რეგენერირებული შტრიხკოდის ვექტორები. „შესაბამისობის გარეშე“ PDF ექსპორტი გთხოვთ დაარეგულიროთ ფილტრები ან წყარო.
შეინახეთ წყარო PDF და დეკოდირებული შიგთავსი თქვენს მოწყობილობაზე.
ინსტრუმენტი იღებს ერთ PDF-ს 100 მბ-მდე და 750 გვერდამდე. არ არსებობს ატვირთვის ან დისტანციური დეკოდირების სერვისი. QR კოდებში არაბულად სწორად დაშიფრული ტექსტი შენარჩუნებულია ინტერფეისში და UTF-8 ექსპორტებში.
აღმოჩენა შეზღუდულია 100-ზე ნაკლები კოდით თითო გვერდზე და მაქსიმუმ 5,000-ით თითო დოკუმენტზე, თითო მნიშვნელობაზე მაქსიმუმ 8,192 სიმბოლოთი. CSV და JSON ექსპორტები დამთხვევის გარეშე ცარიელი ანგარიშებია. პაროლით დაცული PDF-ები ჯერ უნდა განბლოკოთ.
გახსენით ერთი PDF ფაილი 100 მბ-მდე და 750 გვერდამდე. რთული დოკუმენტებისთვის შესაძლოა დაწესდეს დამატებითი შეზღუდვები გამომავალ ფაილზე, მეხსიერებასა და დამუშავებაზე.
დამუშავება ხდება თქვენს მოწყობილობაზე, დოკუმენტის ატვირთვის გარეშე. ჩამოტვირთეთ შედეგი გვერდის დახურვამდე; ორიგინალი შეინახეთ ცალკე.
იცოდეთ რას უნდა ელოდოთ დაწყებამდე.
კონფიდენციალური დამუშავებადიახ. გახსენით PDF და დააწკაპუნეთ „შტრიხკოდების პოვნა“-ზე. QR მნიშვნელობები გამოჩნდება მონაცემებში წყარო გვერდის ბმულთან ერთად.
დიახ. ის კითხულობს გვერდის სურათებს და არ საჭიროებს OCR-ს ან ამოსარჩევ ტექსტს. შტრიხკოდი უნდა იყოს საკმარისად მკაფიო დეკოდირებისთვის.
აირჩიეთ CSV. Excel-ში „Value“ სვეტი შეიტანეთ როგორც „Text“, რათა შეინარჩუნოთ წამძღვარებული ნულები და გრძელი ციფრული იდენტიფიკატორები. CSV არ არის XLSX სამუშაო წიგნი.
არა. ყოველი აღმოჩენილი შემთხვევა ჩამოთვლილია თავისი გვერდის ნომრით. ფილტრები წყვეტს, რომელი შედეგები იქნება კოპირებული ან ჩამოტვირთული.
არა. მნიშვნელობები ნაჩვენებია მხოლოდ ტექსტის სახით. სკრიპტის მსგავსი ან URL მნიშვნელობები არ სრულდება და არ იხსნება.
დიახ, როდესაც QR კოდი იყენებს მხარდაჭერილ ტექსტურ კოდირებას. არაბული ტექსტი უცვლელი რჩება UTF-8 CSV, JSON და ტექსტურ ექსპორტებში.
სცადეთ უფრო მკაფიო დოკუმენტი ან დაარეგულირეთ ფილტრები. CSV და JSON ფაილების ჩამოტვირთვა მაინც შესაძლებელია როგორც ცარიელი ანგარიშები; უშედეგო ძიება არ ნიშნავს, რომ დოკუმენტს არ აქვს შტრიხკოდები.
დიახ. აირჩიეთ „PDF შტრიხკოდის სურათებით“ CSV ოფციის ქვემოთ. მიმდინარე შესაბამისი კოდები იჭრება წყარო გვერდებიდან და თავსდება ახალ PDF-ში, ოთხი თითო გვერდზე, წყარო გვერდის მითითებებით. ამ გზით შესაძლებელია 400-მდე კოდის ექსპორტი.