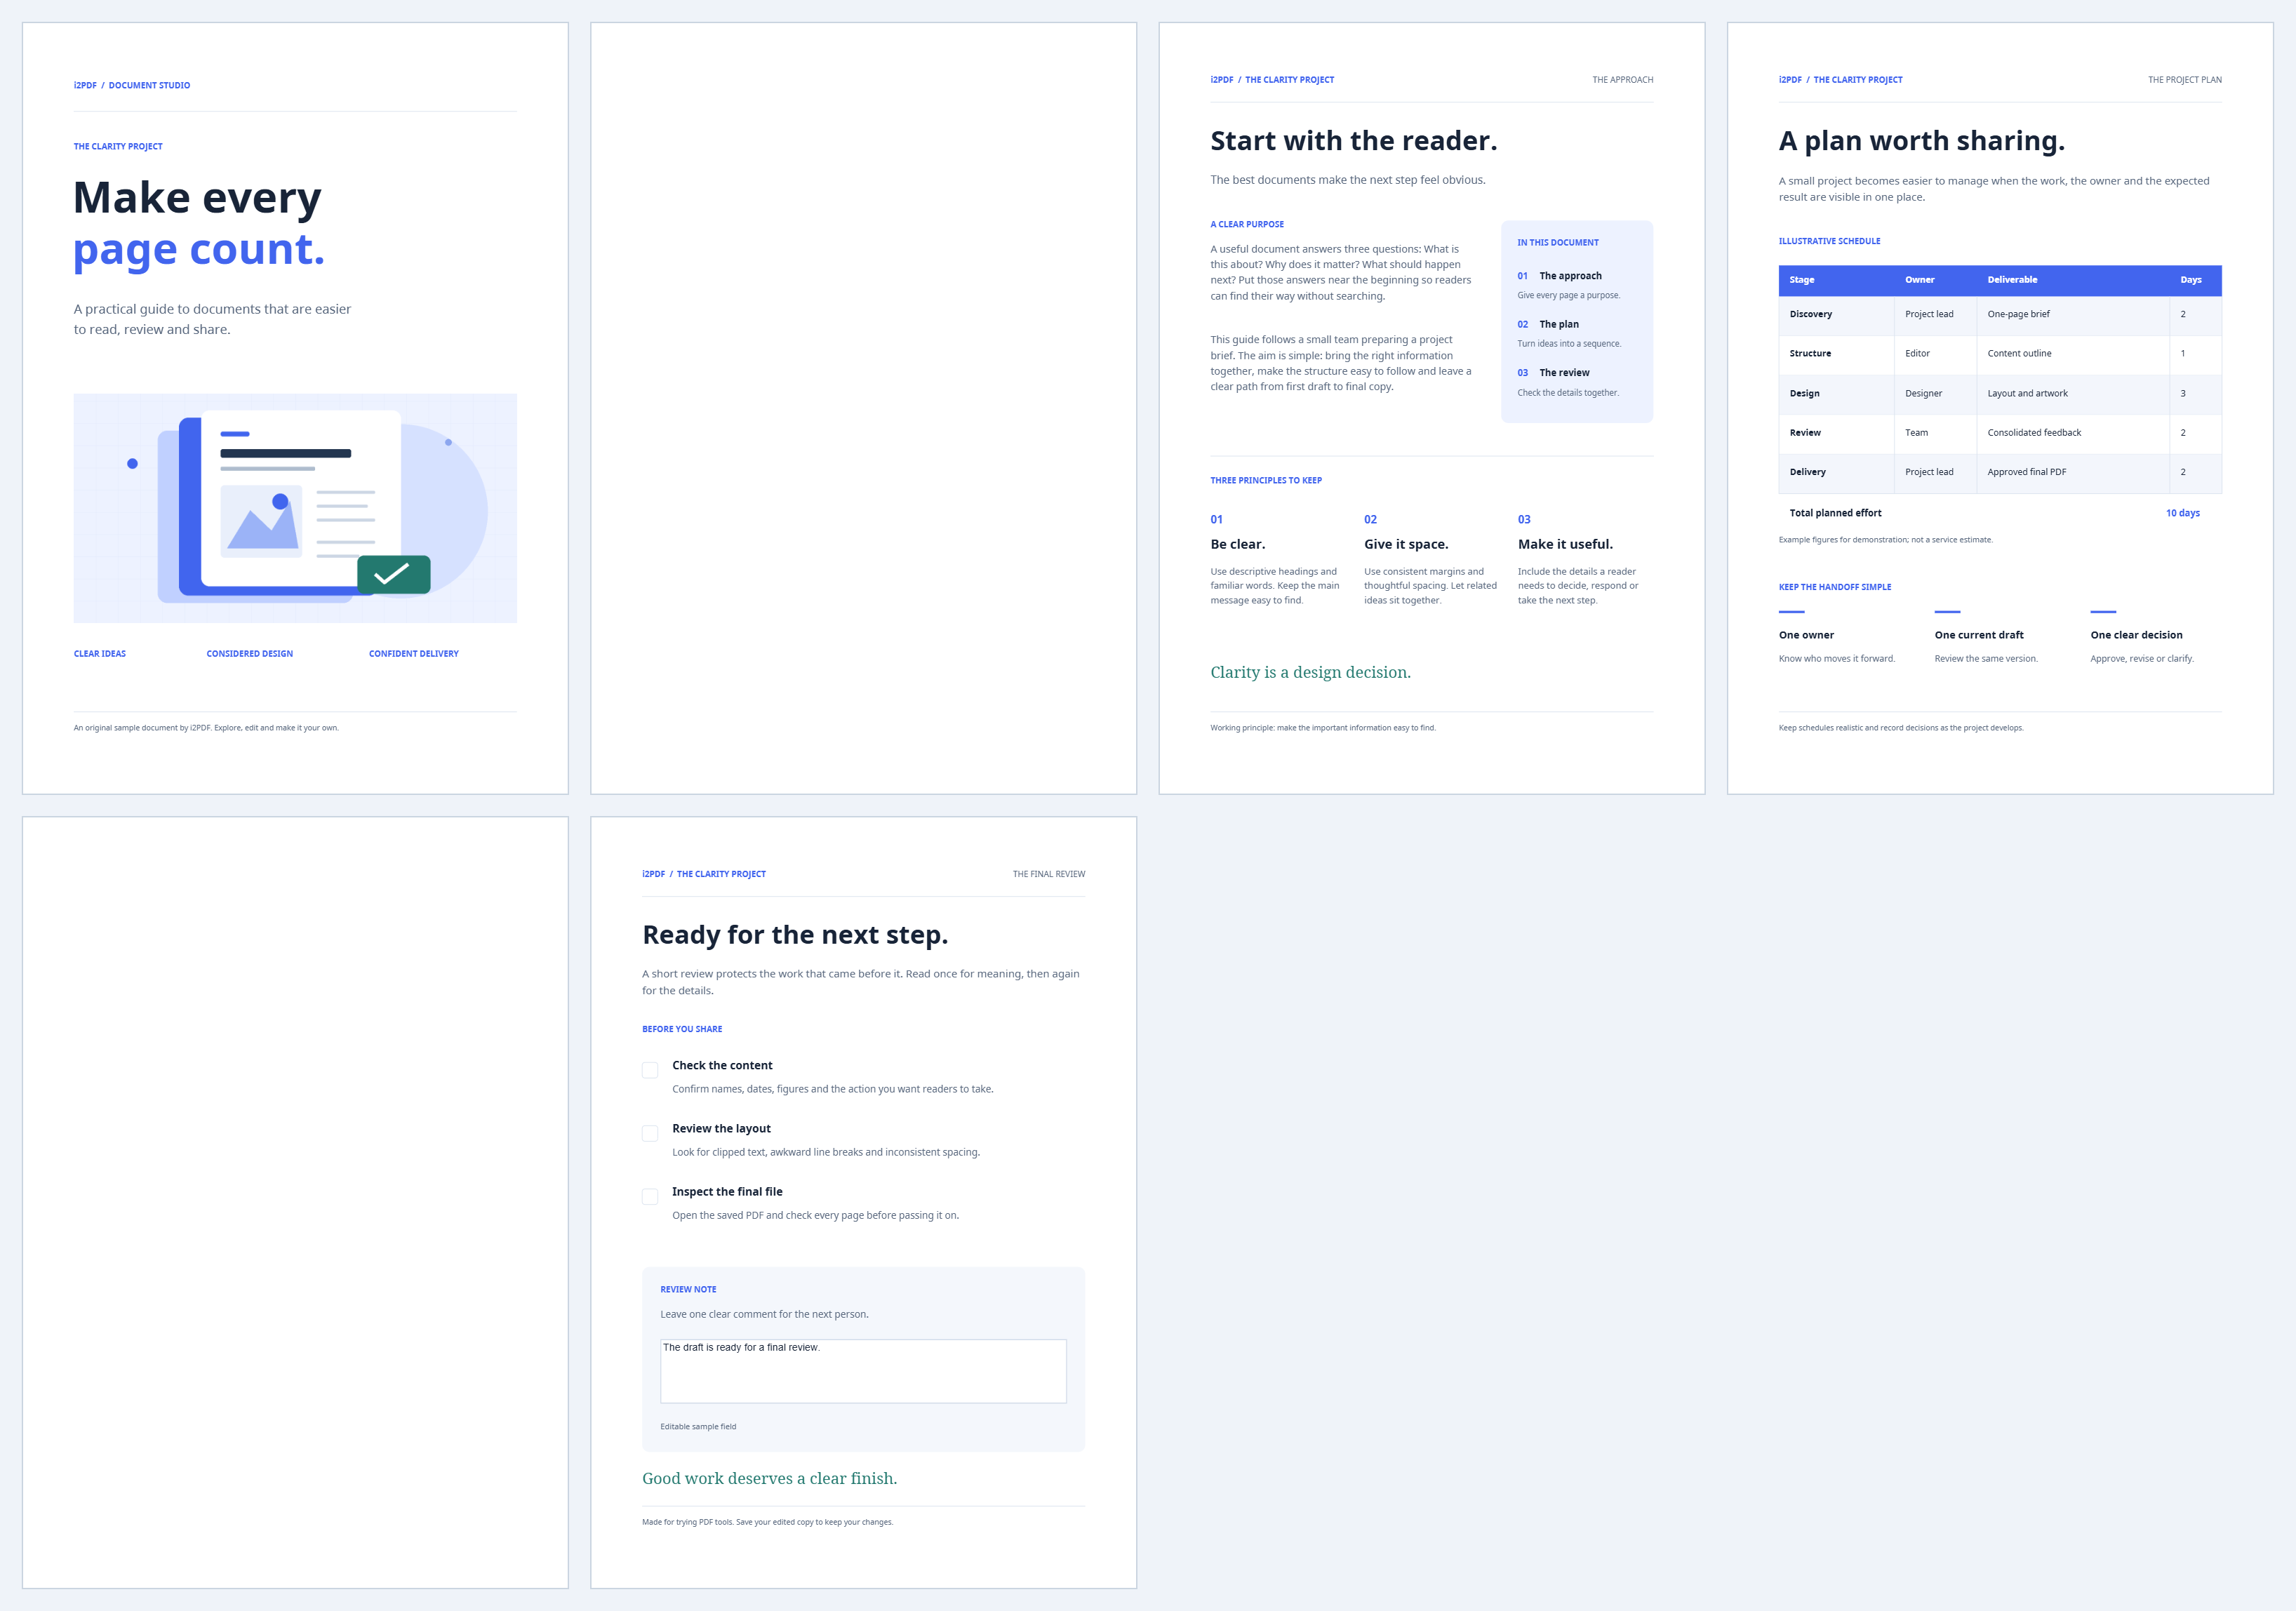
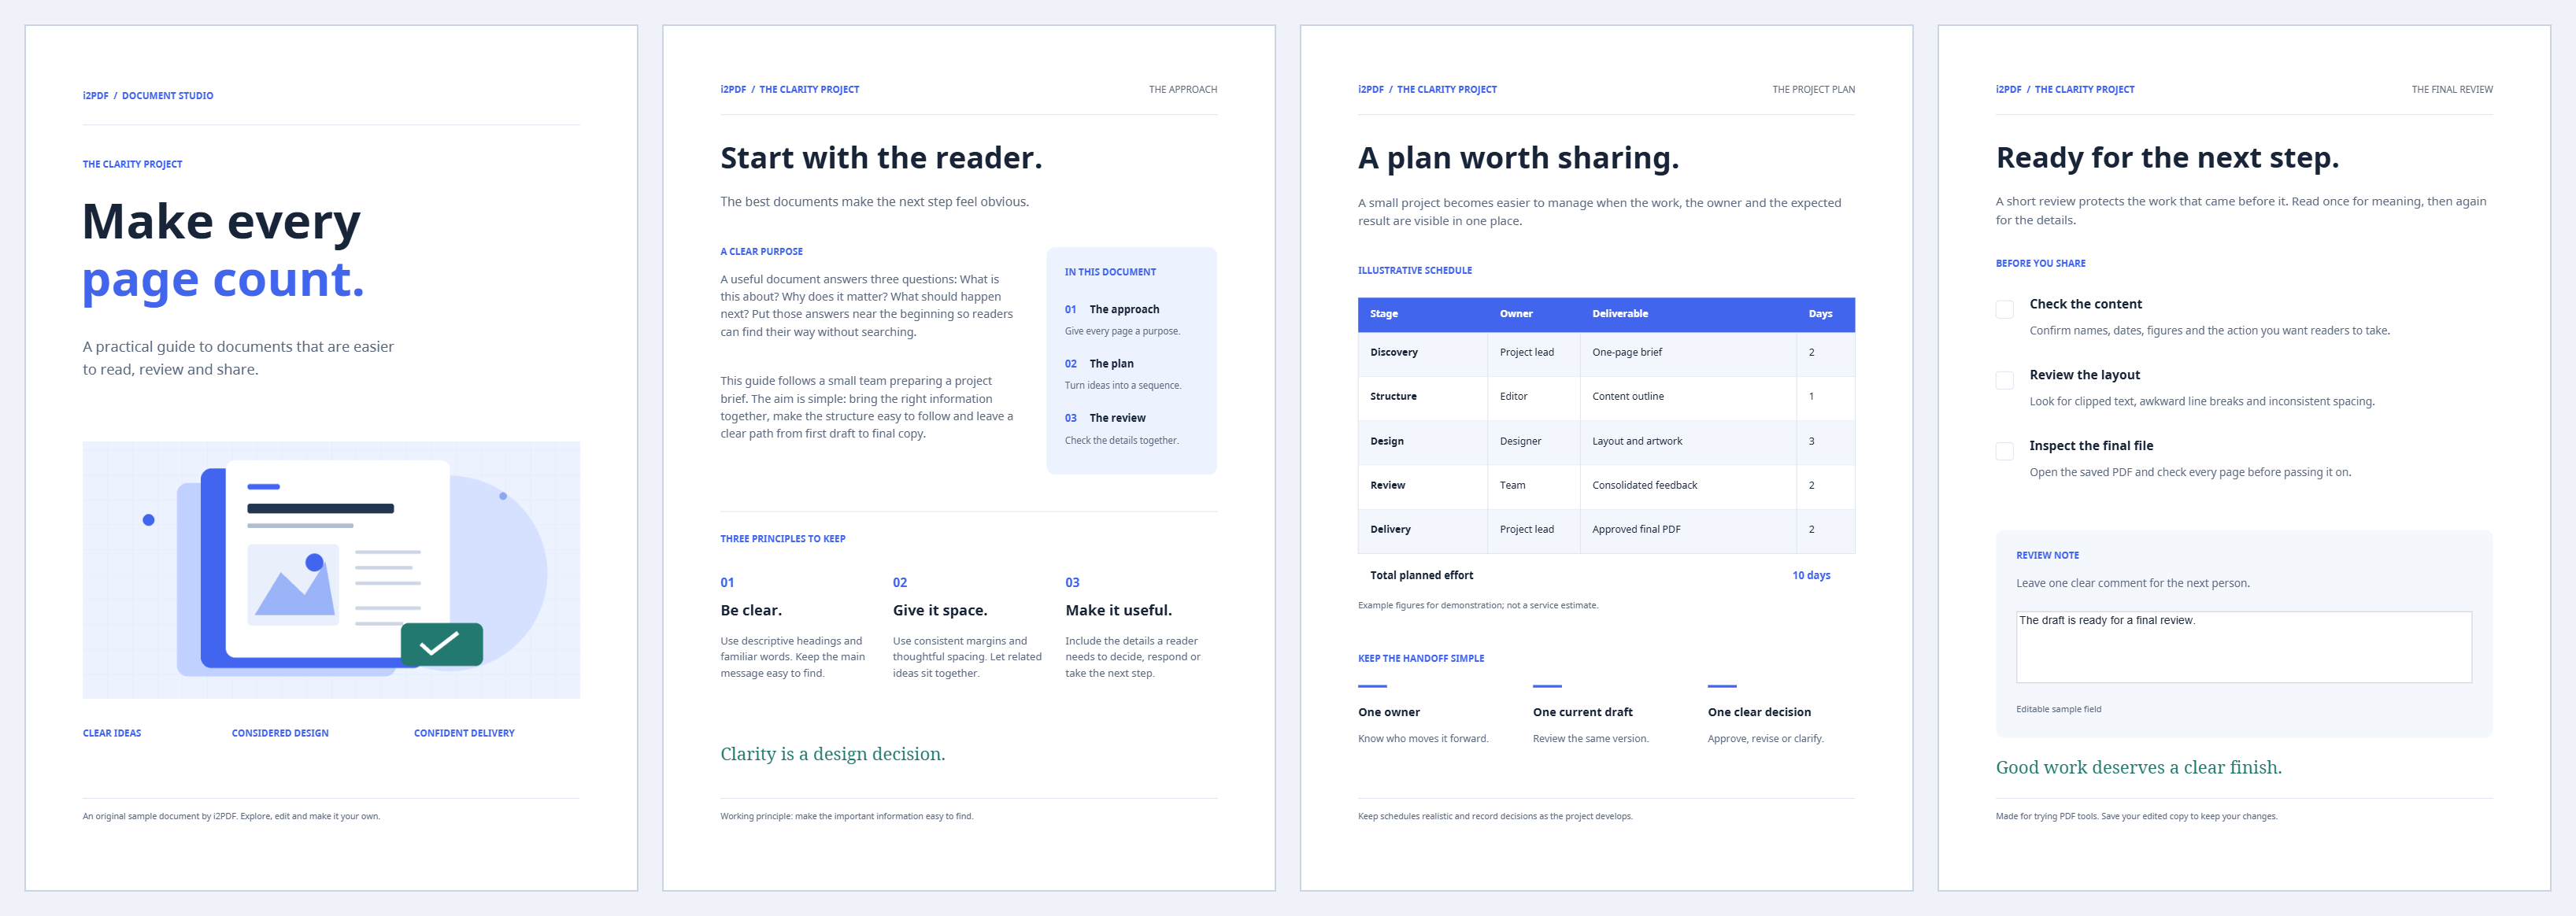

Remove Blank Pages from PDF खोलें और सेव करने से पहले पहचाने गए पेजों की जांच करें। नमूने में, पेज दो और पांच खाली हैं; उन्हें हटाने से छह पेज घटकर चार रह जाते हैं।
लोड करें और खाली पेजों के लिए स्कैन करें
PDF चुनें या नमूना आज़माएं। 'Allow small scan specks' के अंतर्गत Strict — completely blank रखें, फिर Find blank pages चुनें।
सुझाए गए हटाए जाने वाले पेजों की समीक्षा करें
फ्लैग किए गए थंबनेल चुनें और उनके प्रीव्यू की जांच करें। दस्तावेज़ में शामिल खाली विभाजक के लिए Keep का उपयोग करें, या जिसे आप हटाना चाहते हैं उस पेज के लिए Remove चुनें। उदाहरण में सोर्स पेज दो और पांच हटा दिए गए हैं।
यदि छोटे स्कैनर निशान खाली पेजों की पहचान होने से रोकते हैं, तो लाइट-नॉइज़ या स्कैन-नॉइज़ विकल्प आज़माएं और फिर से विश्लेषण करें। उच्च सहनशीलता (tolerance) के लिए धुंधली सामग्री की बारीकी से समीक्षा की आवश्यकता होती है।
साफ किए गए दस्तावेज़ को सेव करें
Start चुनें और डाउनलोड करें। यदि आपने अभी तक विश्लेषण नहीं किया है, तो एक्सपोर्ट प्रक्रिया पहचान शुरू कर देगी, लेकिन पहले समीक्षा करने से चयन की जांच करना आसान हो जाता है।
हमारे आउटपुट में चार पेज हैं, जो सोर्स पेज 1, 3, 4 और 6 के समान क्रम में हैं। सोर्स कॉपी को बदलने से पहले उन ट्रांज़िशन की जांच करें जहां से खाली पेज हटाए गए थे।
सामान्य प्रश्न
क्या टेक्स्ट या फॉर्म फ़ील्ड को खाली माना जाएगा?
डिटेक्टर रेंडर किए गए स्वरूप, एक्सट्रैक्ट किए गए टेक्स्ट और फॉर्म विजेट्स की जांच करता है। यह टेक्स्ट या फॉर्म विजेट वाले पेजों को खाली के रूप में वर्गीकृत करने से बचता है।
क्या होगा यदि हर पेज खाली हो?
यह टूल कम से कम एक पेज बनाए रखता है ताकि सेव की गई PDF खाली न रहे। यदि किसी पेज को हटाने की आवश्यकता नहीं है, तो यह मूल दस्तावेज़ वापस कर सकता है।
इसे अपने दस्तावेज़ के साथ आज़माएं
परिणाम की समीक्षा करें, फिर अपनी ज़रूरत का वर्ज़न सेव करें।