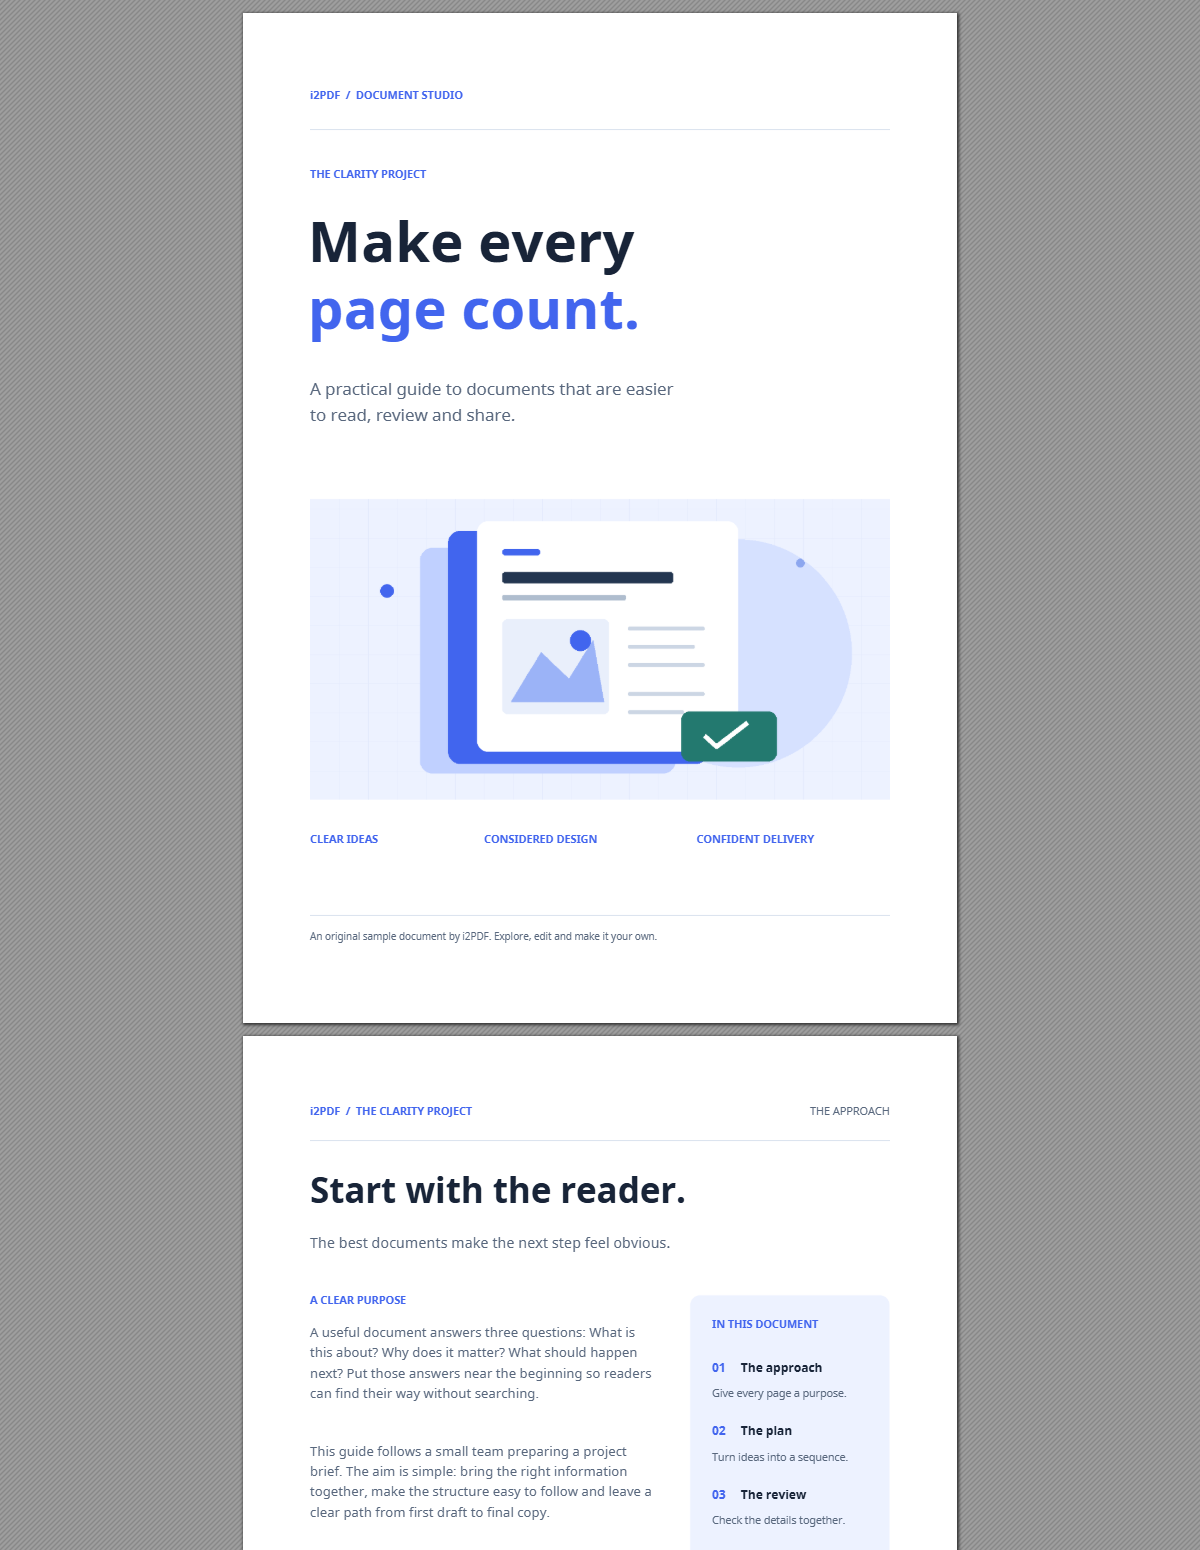

Använd PDF till HTML för att konvertera valda sidor till en HTML-representation. Granska resultatet i en webbläsare, särskilt typsnitt, bilder och placerad text.
Öppna PDF:en och välj sidor
Lägg till PDF:en och inspektera sidorna som ska inkluderas. Lämna sidintervallet tomt för hela dokumentet eller ange önskade sidnummer och intervall.
Behåll käll-PDF:en för att jämföra den exporterade layouten. Komplexa typsnitt, lagerdelad grafik och tätt placerade etiketter kräver särskild uppmärksamhet.
Välj bildinbäddning och format
Behåll "Bädda in bilder i HTML" aktiverat för det första exemplet. Om externa bilder väljs istället, paketerar verktyget HTML-filen och tillhörande filer i en ZIP-fil.
Välj PNG eller JPG för de genererade bakgrundsbilderna. PNG är ett bra val för skarp grafik; kontrollera det faktiska resultatet och filstorleken innan du väljer ett annat format.
Exportera och öppna resultatet
Välj konverteringsåtgärd och ladda ner resultatet. Öppna HTML-filen i en webbläsare; om du får en ZIP-fil, extrahera den och behåll dess mappstruktur.
Jämför varje vald sida med PDF:en. Kontrollera textplacering, typsnitt, bilder och eventuella nödvändiga tillhörande resurser innan du lägger upp de genererade filerna på en webbplats.
Vanliga frågor
Varför får jag en ZIP-fil istället för HTML?
När bilder är externa behöver HTML-filen sina tillhörande filer. ZIP-filen håller dessa genererade resurser samlade.
Kommer detta att återskapa min ursprungliga webbplats från en PDF?
Det skapar en HTML-representation av PDF-sidor. Det återställer inte de ursprungliga webbplatsmallarna, applikationslogiken eller den responsiva designen.
Prova med ditt dokument
Granska resultatet och spara sedan den version du behöver.