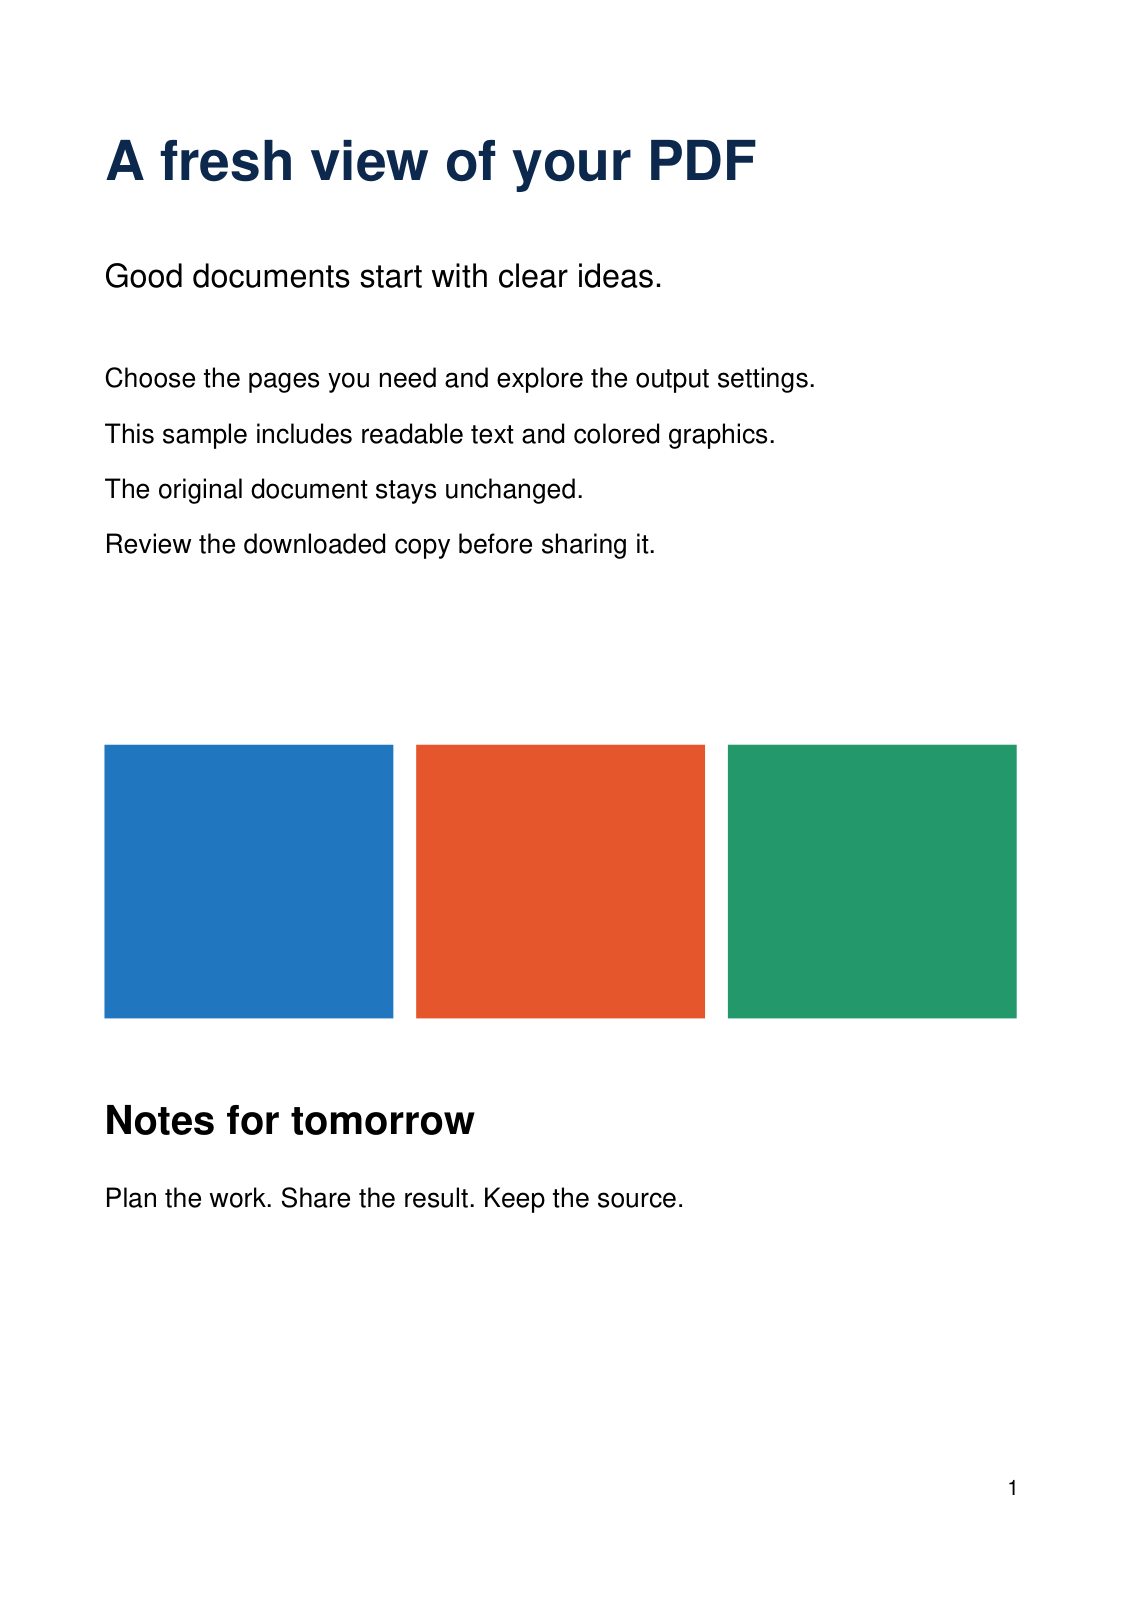
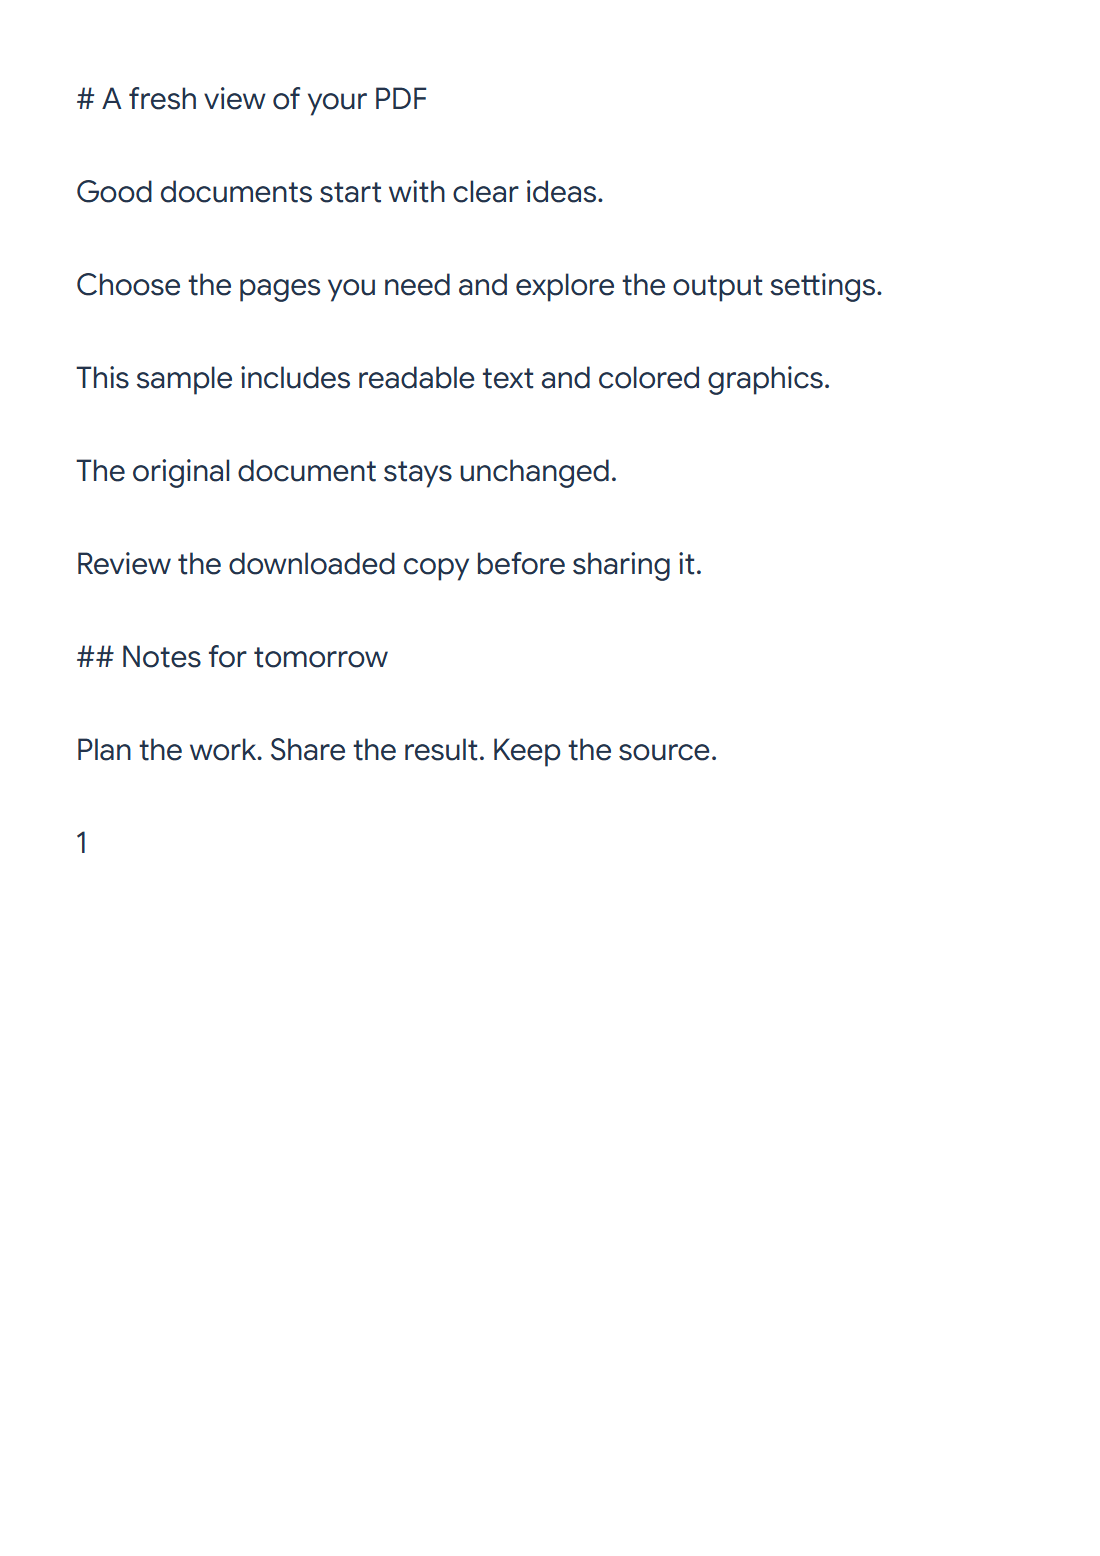

Använd PDF till Markdown för att extrahera text och troliga rubriker, och granska sedan den redigerbara källan. Vårt exempel på två sidor exporterar ett 700-byte Markdown-dokument.
Välj källsidor
Ladda PDF-filen och lämna Sidor att bearbeta tomt för båda exempelsidorna, eller ange ett intervall. Skannade bilder behöver OCR före denna textbaserade konvertering.
Konvertera och granska Markdown
Välj Start. Resultaten visar redigerbar Markdown och en renderad Förhandsgranskning. På en smal skärm kan du växla mellan flikarna.
Exemplets huvudtitel blir en rubrik på nivå ett, och "Notes for tomorrow" blir en rubrik på nivå två. Detekteringen använder textstorlek, så en stor dekorativ etikett kan behöva korrigeras.
Redigera strukturen och ladda ner
Korrigera rubriknivåer, avstånd, listor och läsordning i källan. Förhandsgranskningen uppdateras medan du redigerar. Formateringskontroller hjälper till att lägga till betoning, listor och explicita länkar.
Kopiera eller ladda ner .md när källan och förhandsgranskningen stämmer överens. Dessa åtgärder använder den redigerade källan; den ursprungliga PDF-filen förblir oförändrad.
Vanliga frågor
Varför fick en rubrik fel nivå?
Extraktorn använder textstorlek snarare än att förstå hela dokumentstrukturen. Justera #-markörerna och kontrollera förhandsgranskningen.
Hämtar förhandsgranskningen länkade bilder?
Den aktuella förhandsgranskningen visar bildreferenser som text utan att ladda fjärrbilder. Granska dem i det program där du senare publicerar din Markdown.
Prova med ditt dokument
Granska resultatet och spara sedan den version du behöver.