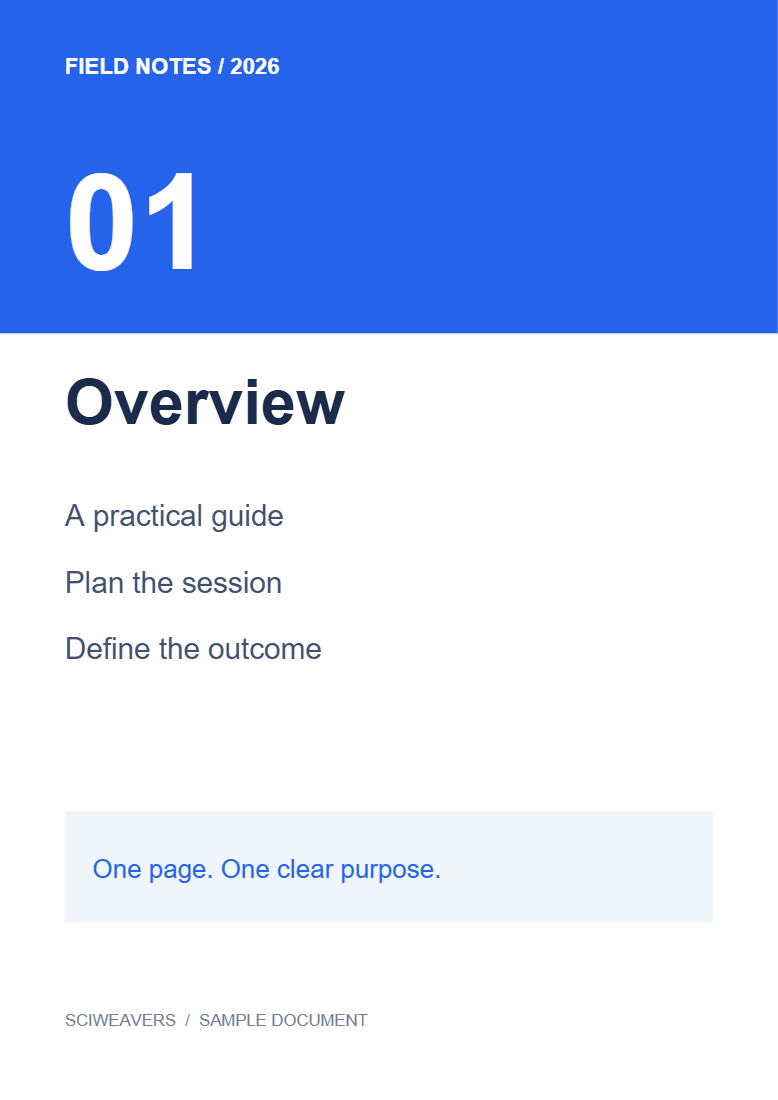
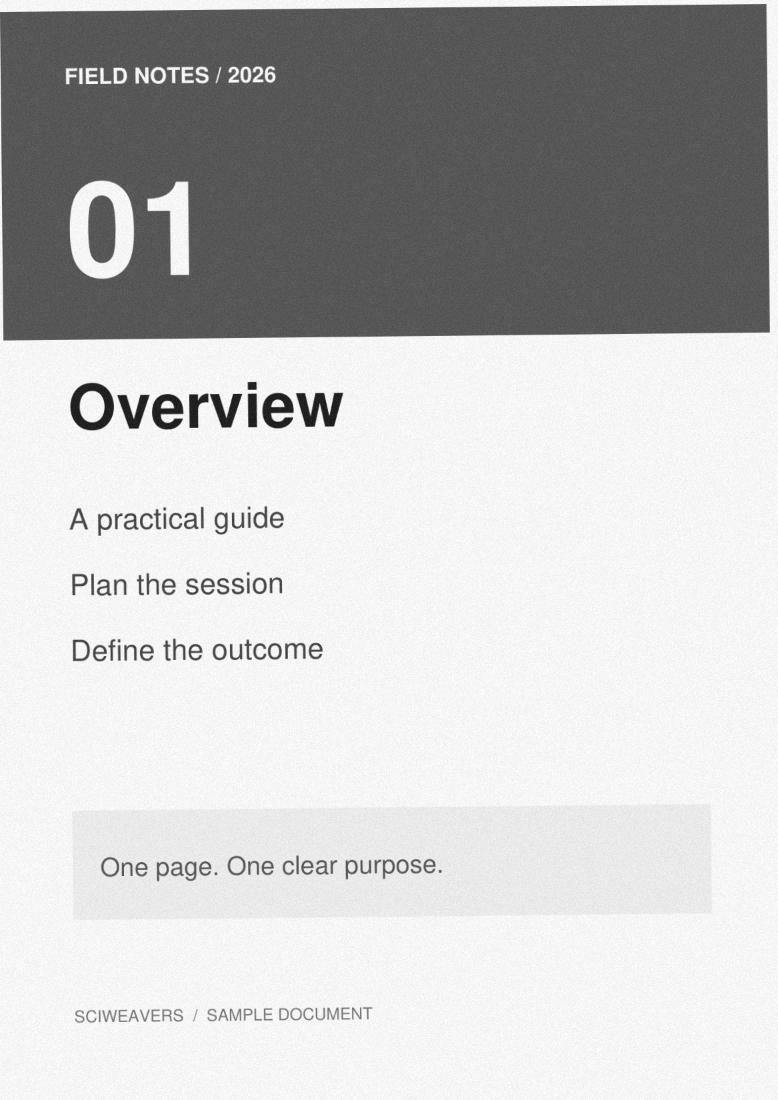

PDF to Scan একটি নতুন PDF-এর ভেতরে PDF পৃষ্ঠাগুলোকে ছবিতে রূপান্তর করে। আমাদের উদাহরণে দুই পৃষ্ঠার একটি ডিজিটাল নথিতে Photocopy লুক ব্যবহার করা হয়েছে।
ডিজিটাল PDF লোড করুন
আপনার PDF নির্বাচন করুন। মূল টেক্সট এবং আর্টওয়ার্ক পরীক্ষা করে দেখুন যাতে আপনি সেগুলোকে সিমুলেটেড স্ক্যানের সাথে তুলনা করতে পারেন। উদাহরণটিতে দুটি পৃষ্ঠা রয়েছে।
50 MB এবং 200 পৃষ্ঠা পর্যন্ত একটি PDF বেছে নিন।
স্ক্যান লুক বেছে নিন এবং রিফাইন করুন
Photocopy নির্বাচন করুন। বর্তমান টুলে এটি গ্রেস্কেল, 50% পেপার নয়েজ এবং −0.6° পেজ টিল্ট সেট করে। এই উদাহরণের জন্য আউটপুট সেটিংসের অধীনে 200 DPI বজায় রাখুন।
সরাসরি ইমেজ-ভিত্তিক কপির জন্য Clean ব্যবহার করুন, অথবা হালকা ইফেক্টের জন্য Light বেছে নিন। মূল ফাইল এবং প্রিভিউ তুলনা করুন; যদি ছোট লেখা পড়তে অসুবিধা হয় তবে নয়েজ বা টিল্ট কমিয়ে দিন।
পেজ সেট করুন এবং এক্সপোর্ট করুন
Pages to process খালি রাখুন। Start নির্বাচন করে ডাউনলোড করুন, তারপর সূক্ষ্ম লেখা এবং রোটেশনের ফলে প্রভাবিত প্রান্তগুলো পরীক্ষা করুন।
সংরক্ষিত উদাহরণটিতে দুটি পৃষ্ঠা রয়েছে যেখানে কোনো টেক্সট লেয়ার এক্সট্র্যাক্ট করা হয়নি। ইমেজের উপস্থিতিই হলো আউটপুট; এটি প্রমাণ করে না যে কোনো ফিজিক্যাল স্ক্যানার ব্যবহার করা হয়েছে।
সাধারণ প্রশ্নাবলী
আমি কি শুধু ইমেজের একটি পরিষ্কার কপি তৈরি করতে পারি?
হ্যাঁ। Clean বেছে নিন এবং নয়েজ ও টিল্ট শূন্য রাখুন। পিডিএফটিতে তখনও রেন্ডার করা পেজ ইমেজ থাকবে।
আমি কি তৈরি করা স্ক্যানটিতে সার্চ করতে পারব?
স্ক্যান এক্সপোর্টে কোনো সিলেকটেবল টেক্সট লেয়ার থাকে না। যদি সার্চ করার প্রয়োজন হয় তবে পরবর্তীতে PDF OCR ব্যবহার করুন এবং শনাক্ত করা টেক্সটটি যাচাই করে নিন।
আপনার ডকুমেন্টের সাথে এটি চেষ্টা করে দেখুন
ফলাফলটি যাচাই করুন, তারপর আপনার প্রয়োজনীয় সংস্করণটি সেভ করুন।