
PDF to Scan एक नई PDF के अंदर PDF पेजों को इमेज में बदल देता है। हमारा उदाहरण दो-पेज वाले डिजिटल दस्तावेज़ पर Photocopy लुक का उपयोग करता है।
डिजिटल PDF लोड करें
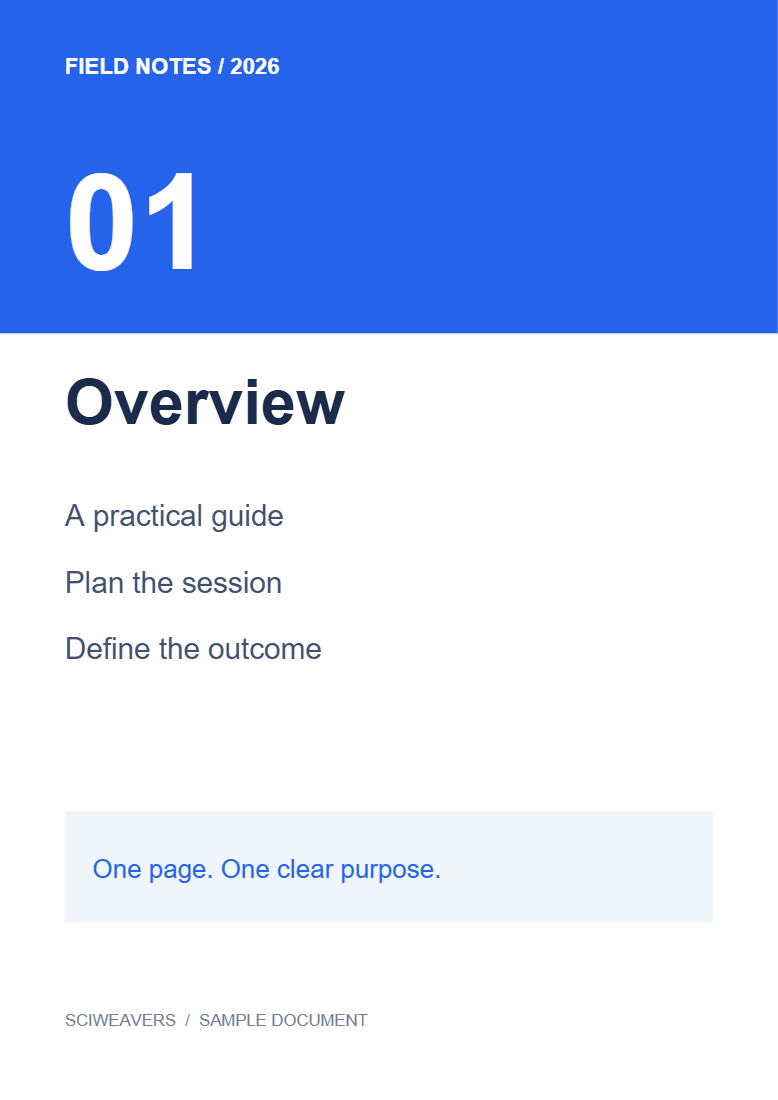
अपनी PDF चुनें। मूल टेक्स्ट और आर्टवर्क की जाँच करें ताकि आप उनकी तुलना सिम्युलेटेड स्कैन से कर सकें। उदाहरण में दो पेज हैं।
50 MB और 200 पृष्ठों तक का PDF चुनें।
स्कैन लुक चुनें और उसे बेहतर बनाएं
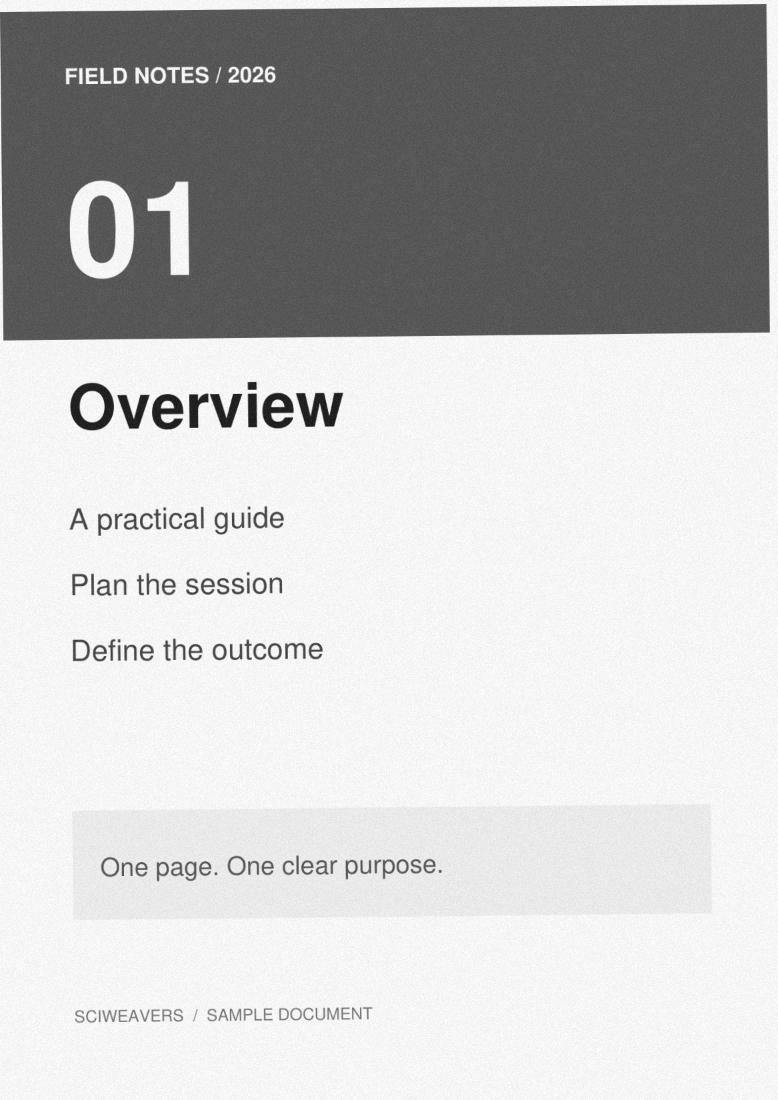
Photocopy चुनें। वर्तमान टूल में यह ग्रेस्केल, 50% पेपर नॉइज़ और −0.6° पेज टिल्ट सेट करता है। इस उदाहरण के लिए आउटपुट सेटिंग्स के अंतर्गत 200 DPI रखें।
सीधी इमेज-आधारित कॉपी के लिए Clean का उपयोग करें, या हल्के प्रभाव के लिए Light चुनें। मूल और प्रीव्यू की तुलना करें; यदि छोटे टेक्स्ट को पढ़ने में कठिनाई हो रही हो, तो नॉइज़ या टिल्ट को कम करें।
पेज सेट करें और एक्सपोर्ट करें
Pages to process को दोनों पेजों के लिए खाली छोड़ दें। Start चुनें और डाउनलोड करें, फिर बारीक टेक्स्ट और रोटेशन से प्रभावित किनारों की जांच करें।
सहेजे गए उदाहरण में दो पेज हैं जिनमें कोई एक्सट्रैक्ट किया हुआ टेक्स्ट लेयर नहीं है। इमेज का स्वरूप ही आउटपुट है; यह साबित नहीं करता कि किसी भौतिक स्कैनर का उपयोग किया गया था।
सामान्य प्रश्न
क्या मैं केवल-इमेज वाली एक साफ कॉपी बना सकता हूँ?
हाँ। Clean चुनें और नॉइज़ और टिल्ट को शून्य पर रखें। PDF में अभी भी रेंडर की गई पेज इमेज शामिल हैं।
क्या मैं परिणामी स्कैन में खोज सकता हूँ?
स्कैन एक्सपोर्ट में कोई चयन योग्य टेक्स्ट लेयर नहीं होती है। यदि खोजने की क्षमता (searchability) आवश्यक है, तो बाद में PDF OCR का उपयोग करें और पहचाने गए टेक्स्ट की समीक्षा करें।
इसे अपने दस्तावेज़ के साथ आज़माएं
परिणाम की समीक्षा करें, फिर अपनी आवश्यकतानुसार संस्करण को सहेजें।