

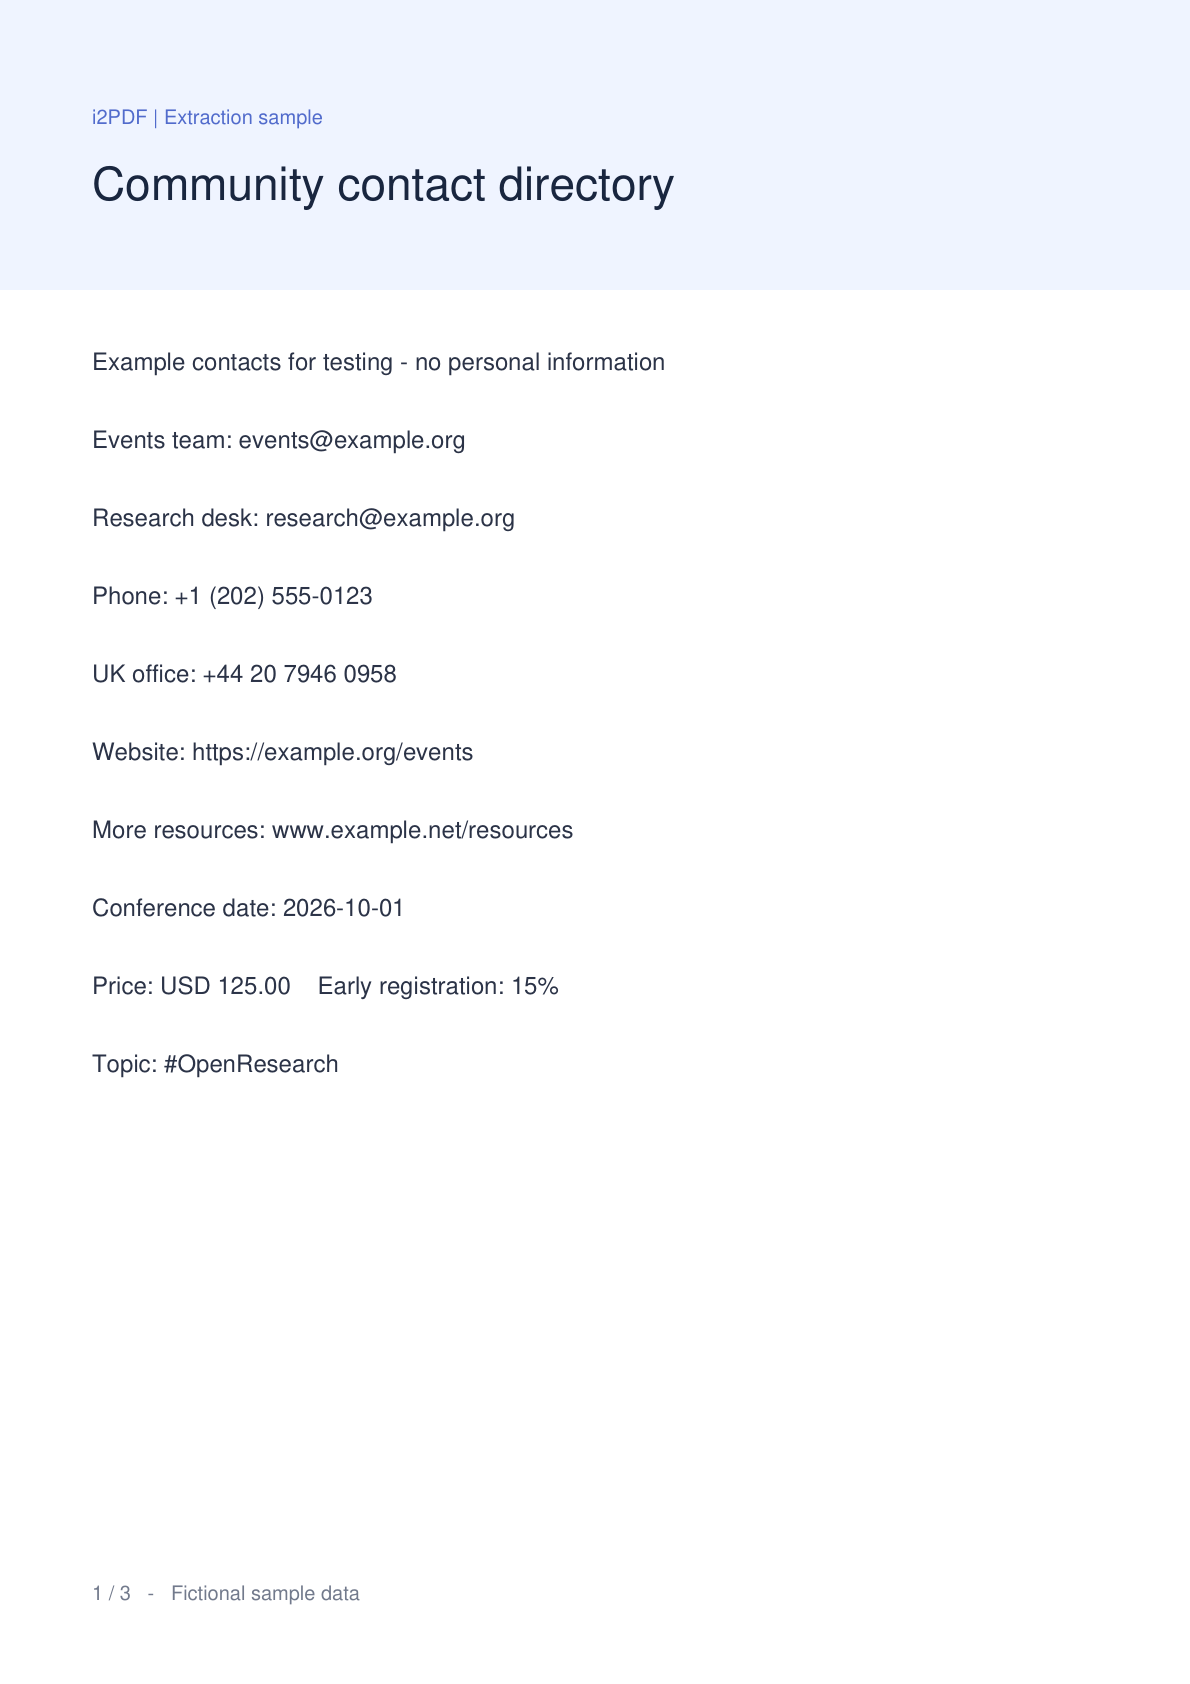
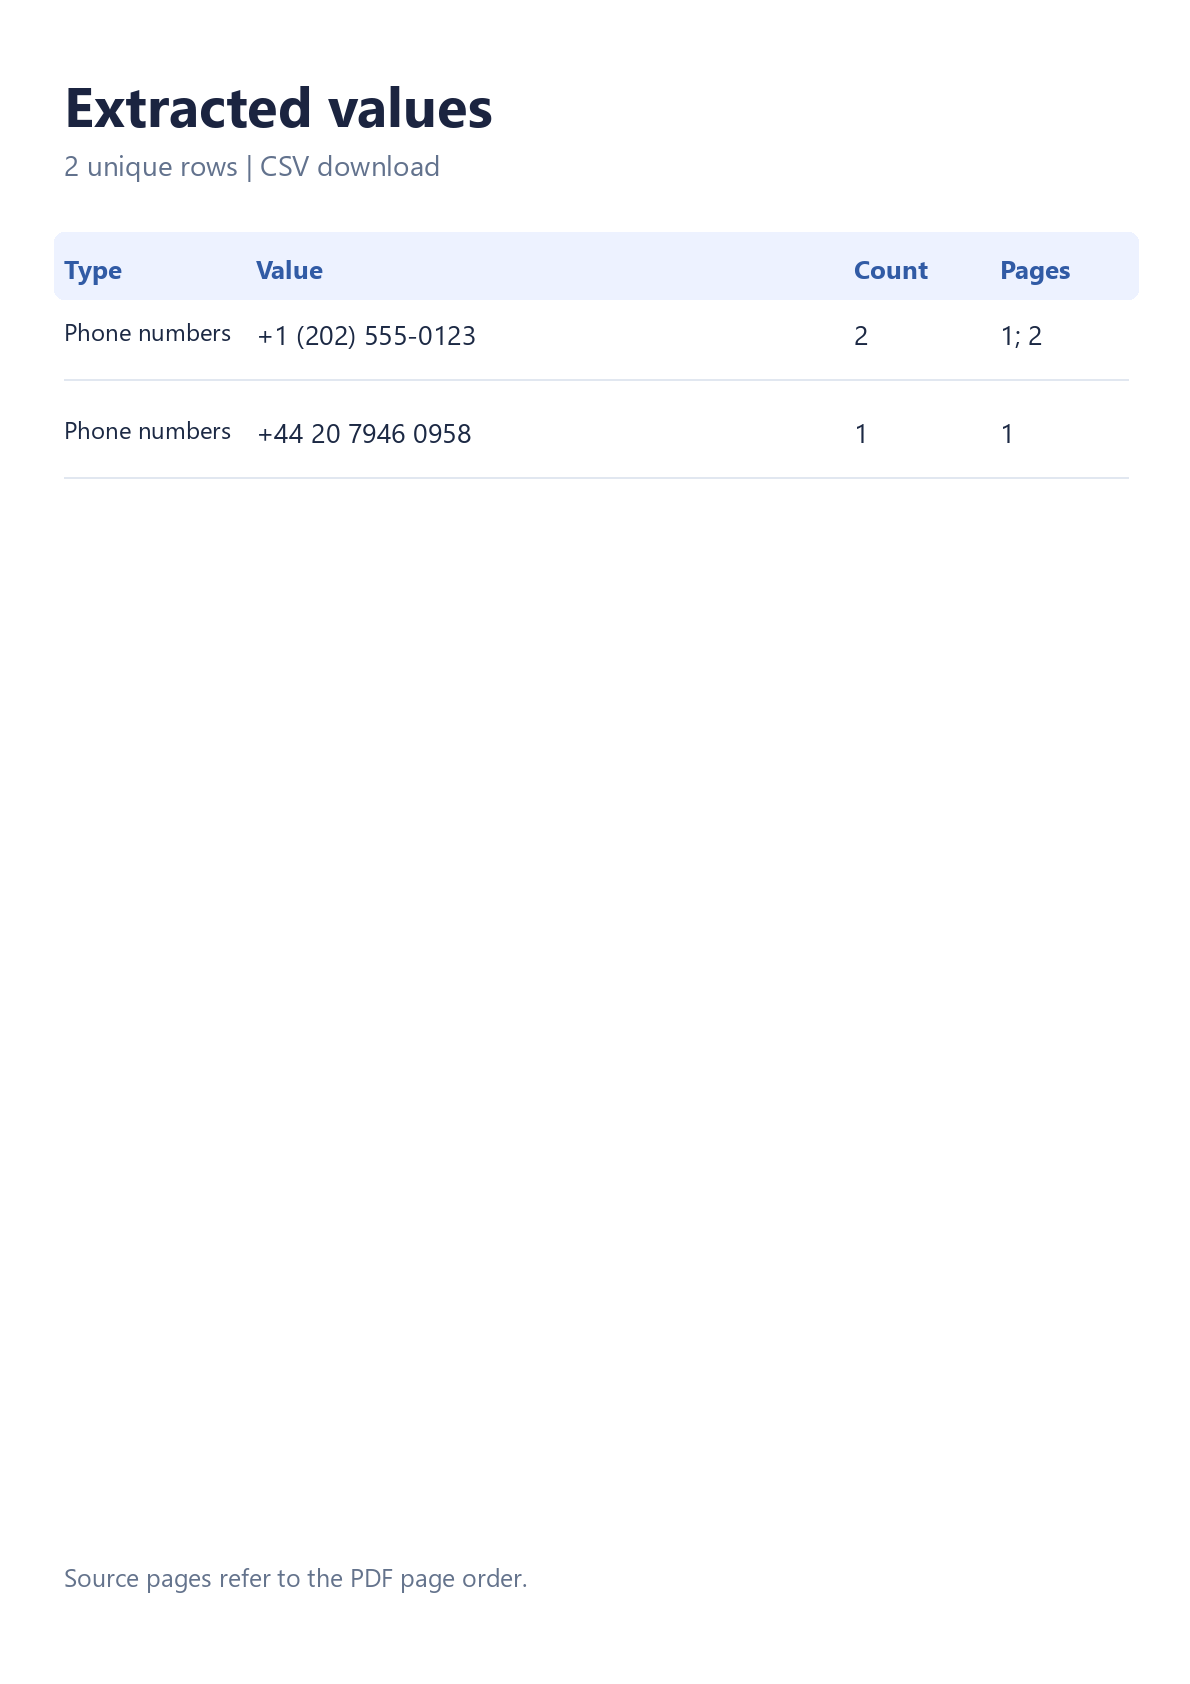

เปิด ดึงหมายเลขโทรศัพท์จาก PDF เพื่อรวบรวมค่าจาก PDF หนึ่งไฟล์โดยไม่ต้องคัดลอกทีละบรรทัด การเปรียบเทียบนี้ใช้เอกสารตัวอย่างจริงและไฟล์ CSV ที่ดาวน์โหลดจากเครื่องมือ ตัวอย่างสามหน้าให้หมายเลขโทรศัพท์ระหว่างประเทศที่ไม่ซ้ำกัน 2 หมายเลขจากทั้งหมด 3 รายการ
เปิด PDF ของคุณ
อัปโหลด PDF หนึ่งไฟล์ หรือเลือก ลองใช้ตัวอย่าง เพื่อทำตามตัวอย่างนี้ ตัวอย่าง PDF และภาพขนาดย่อของหน้าจะปรากฏขึ้น ไฟล์ต้นฉบับของคุณจะไม่มีการเปลี่ยนแปลง และการดึงข้อมูลจะทำงานในเบราว์เซอร์ของคุณ
ไดเรกทอรี รายงาน เอกสารวิจัย หรือโบรชัวร์ที่ใช้ข้อความเป็นจุดเริ่มต้นที่มีประโยชน์ การสแกนที่เป็นรูปภาพเท่านั้นจำเป็นต้องใช้ OCR ก่อนจึงจะสามารถจดจำข้อความที่พิมพ์ได้
เลือกตัวเลือกที่มีประโยชน์
บนโทรศัพท์ ให้เปิด การตั้งค่า บนเดสก์ท็อป ให้ใช้แผงการตั้งค่าข้างตัวอย่าง
ค่าเริ่มต้นของ ภูมิภาคของหมายเลขโทรศัพท์ คือ เฉพาะหมายเลขระหว่างประเทศ (+) ให้คงค่านี้ไว้สำหรับตัวอย่าง เลือกประเทศเมื่อเอกสารของคุณมีหมายเลขในประเทศที่ไม่มีรหัสประเทศ เปิดใช้งาน ลบรายการที่ซ้ำกัน ไว้
ดึงข้อมูลและตรวจสอบรายการที่ตรงกัน
เลือก ดึงข้อมูล เมื่อการประมวลผลเสร็จสิ้น แท็บ ผลลัพธ์ จะแสดงค่า จำนวนที่พบ และหน้าต้นฉบับ เลือกหมายเลขหน้าที่เป็นวงกลมเพื่อตรวจสอบตำแหน่งในตัวอย่าง PDF จากนั้นกลับไปที่ผลลัพธ์
ตัวอย่างพบ +1 (202) 555-0123 ในหน้า 1 และ 2 และ +44 20 7946 0958 ในหน้า 1 รูปแบบที่เทียบเท่ากันของหมายเลขเดียวกันจะถูกจัดกลุ่มตามรูปแบบระหว่างประเทศและส่วนขยาย ปุ่มหน้าต้นฉบับช่วยให้คุณตรวจสอบได้ว่ารายการที่ตรงกันนั้นเป็นหมายเลขติดต่อจริงหรือไม่
ใช้ กรองผลลัพธ์ เพื่อจำกัดรายการให้แคบลง การคัดลอกและการดาวน์โหลดจะรวมแถวที่ตรงกันทั้งหมด แม้ว่าตารางผลลัพธ์จะแสดงหลายหน้าจอของแถวก็ตาม
ดาวน์โหลด CSV หรือ TXT
เลือก ดาวน์โหลด CSV จากนั้นใช้ปุ่ม ดาวน์โหลด หลักบนหน้าจอที่พร้อมใช้งาน CSV จะมีคอลัมน์ประเภท ค่า จำนวน และหน้า TXT และ คัดลอกทั้งหมด จะมีหนึ่งค่าต่อบรรทัด
ค่าใน CSV ที่อาจถูกตีความว่าเป็นสูตรสเปรดชีตจะได้รับการป้องกันด้วยเครื่องหมายอะพอสทรอฟีนำหน้า ตัวอย่างเช่น หมายเลขโทรศัพท์ระหว่างประเทศจะขึ้นต้นด้วยเครื่องหมายบวก ใช้ TXT หากคุณต้องการรายการธรรมดาที่ไม่มีการป้องกันสเปรดชีต
คำถามที่พบบ่อย
ทำไมจึงไม่พบหมายเลขท้องถิ่น?
เลือกประเทศในภูมิภาคของหมายเลขโทรศัพท์ จากนั้นเลือกดึงข้อมูลอีกครั้ง โหมดเฉพาะระหว่างประเทศคาดหวังเครื่องหมายบวกนำหน้า หากหมายเลขถูกแบ่งออกตามรูปแบบที่ผิดปกติหรือไม่มีข้อความที่เลือกได้ ให้แก้ไขแหล่งที่มาหรือใช้ OCR ก่อน
ฉันควรทำอย่างไรกับ PDF ที่สแกนมา?
เรียกใช้ PDF OCR ก่อน จากนั้นโหลดสำเนาที่จดจำได้ลงในเครื่องมือนี้ ตรวจสอบผลลัพธ์ OCR อย่างระมัดระวัง: อักขระที่ผิดพลาดอาจเปลี่ยนที่อยู่หรือตัวระบุได้
ข้อจำกัดในการดึงข้อมูลคืออะไร?
ใช้ PDF หนึ่งไฟล์ที่มีขนาดสูงสุด 50 MiB และ 750 หน้า การดึงข้อมูลจำกัดไว้ที่ 20,000 รายการโดยรวมและ 2,000 รายการต่อหน้า โดยมีงบประมาณการประมวลผล 90 วินาที ข้อจำกัดด้านข้อความและคำอธิบายประกอบก็มีผลเช่นกัน หากข้อจำกัดหรือหน้าที่อ่านไม่ได้ขัดจังหวะการสแกน เครื่องมือจะแสดงประกาศผลลัพธ์บางส่วนและทำเครื่องหมายชื่อไฟล์ส่งออกว่าเป็นบางส่วน
ลิงก์ PDF ของฉันถูกเปิดโดยอัตโนมัติหรือไม่?
ไม่ การดึงข้อมูลจะอ่านไฟล์ในเบราว์เซอร์และไม่เข้าถึงปลายทางที่ดึงข้อมูล ปุ่มหน้าจะนำทางภายในตัวอย่าง PDF
เก็บค่าและบริบทของค่าเหล่านั้นไว้
ดึงรายการที่เน้น ตรวจสอบหน้าต้นฉบับ และดาวน์โหลดรูปแบบที่เหมาะสมกับขั้นตอนถัดไปของคุณ


