
Öppna PDF till Word, lägg till en PDF med markerbar text och välj de sidor du behöver. Verktyget återskapar innehållet i en DOCX-fil, som du kan öppna och revidera i en Word-redigerare.
Ladda en PDF med användbar text
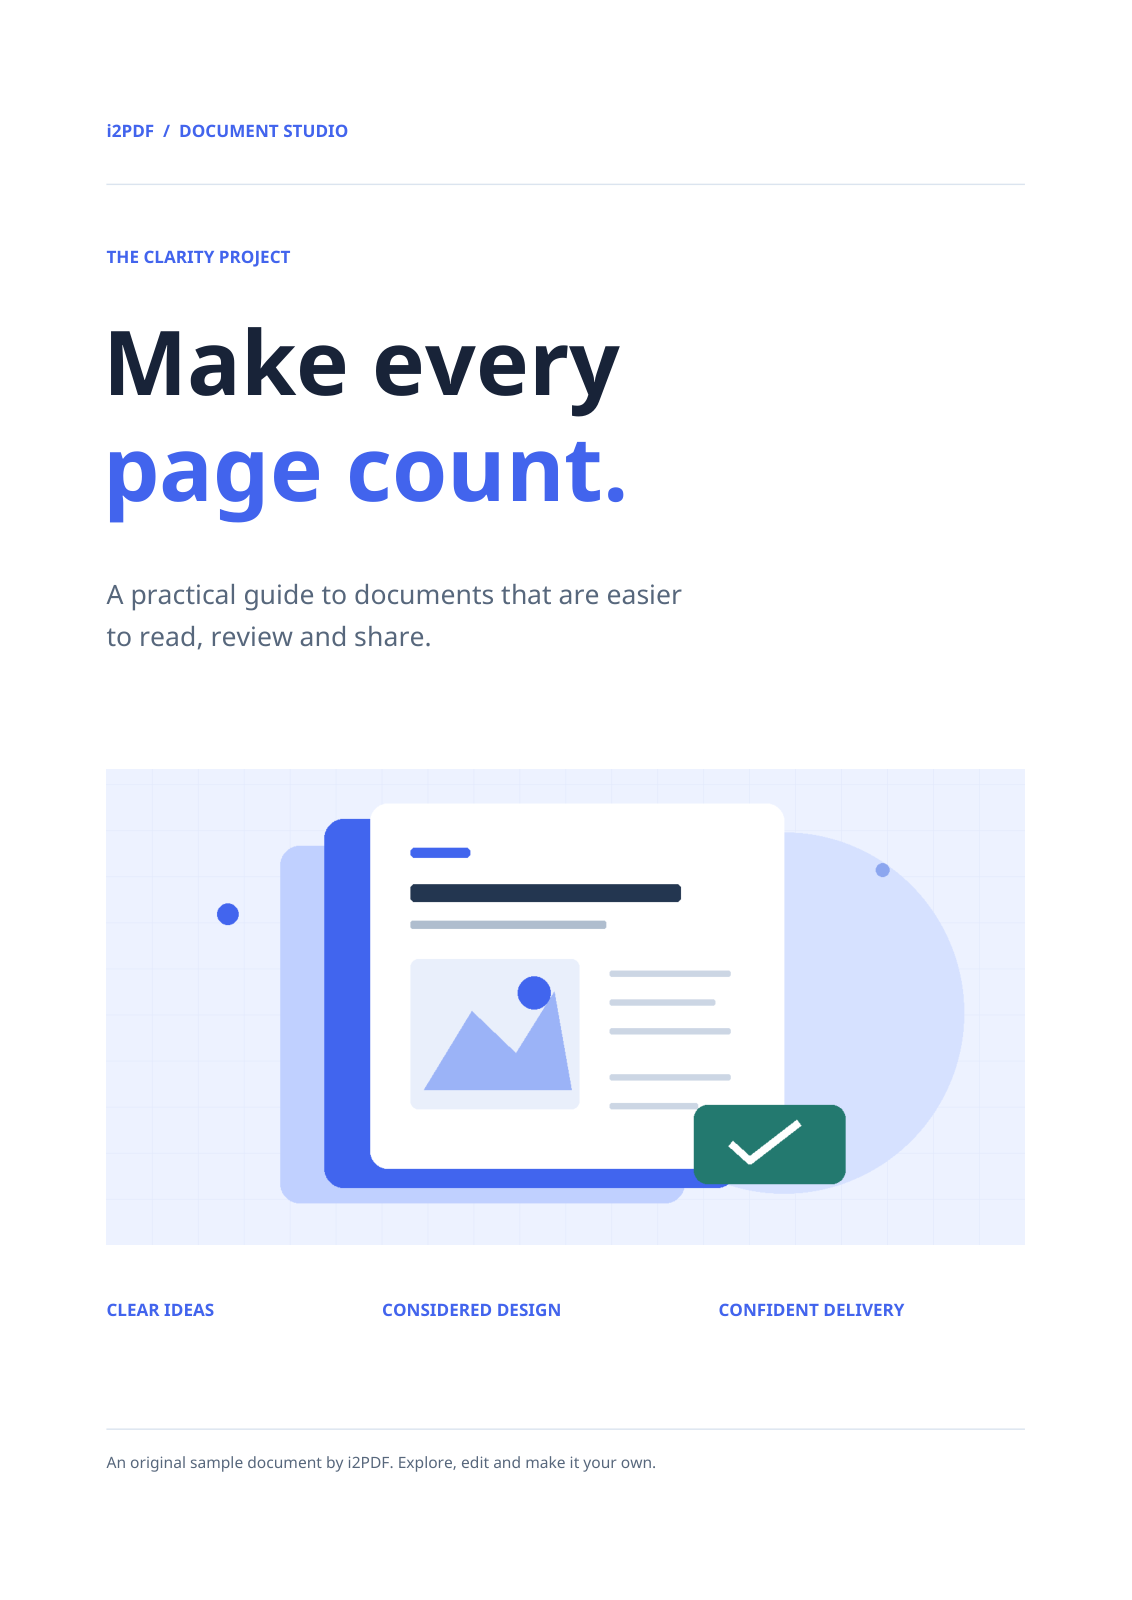
Lägg till din PDF eller välj exemplet. Prova att markera ett ord i källdokumentet: markerbar text är en bättre utgångspunkt än ett fotografi av en sida.
Om ditt dokument endast består av bilder, börja med PDF OCR och granska den igenkända texten. OCR är en separat åtgärd och kan introducera igenkänningsfel.
Välj sidorna som ska konverteras
Lämna Sidor tomma för hela dokumentet, med förbehåll för konverteringsgränsen på 50 sidor. För att konvertera en mindre del, ange ett intervall som 1-3, 5.
För fler än 50 sidor, konvertera separata intervall, till exempel 1-50 och 51-100. Om ett urval överskrider gränsen konverteras endast de första 50 sidorna. Vårt exempel lämnar fältet tomt och inkluderar alla fyra sidor.
Skapa DOCX-filen och inspektera den
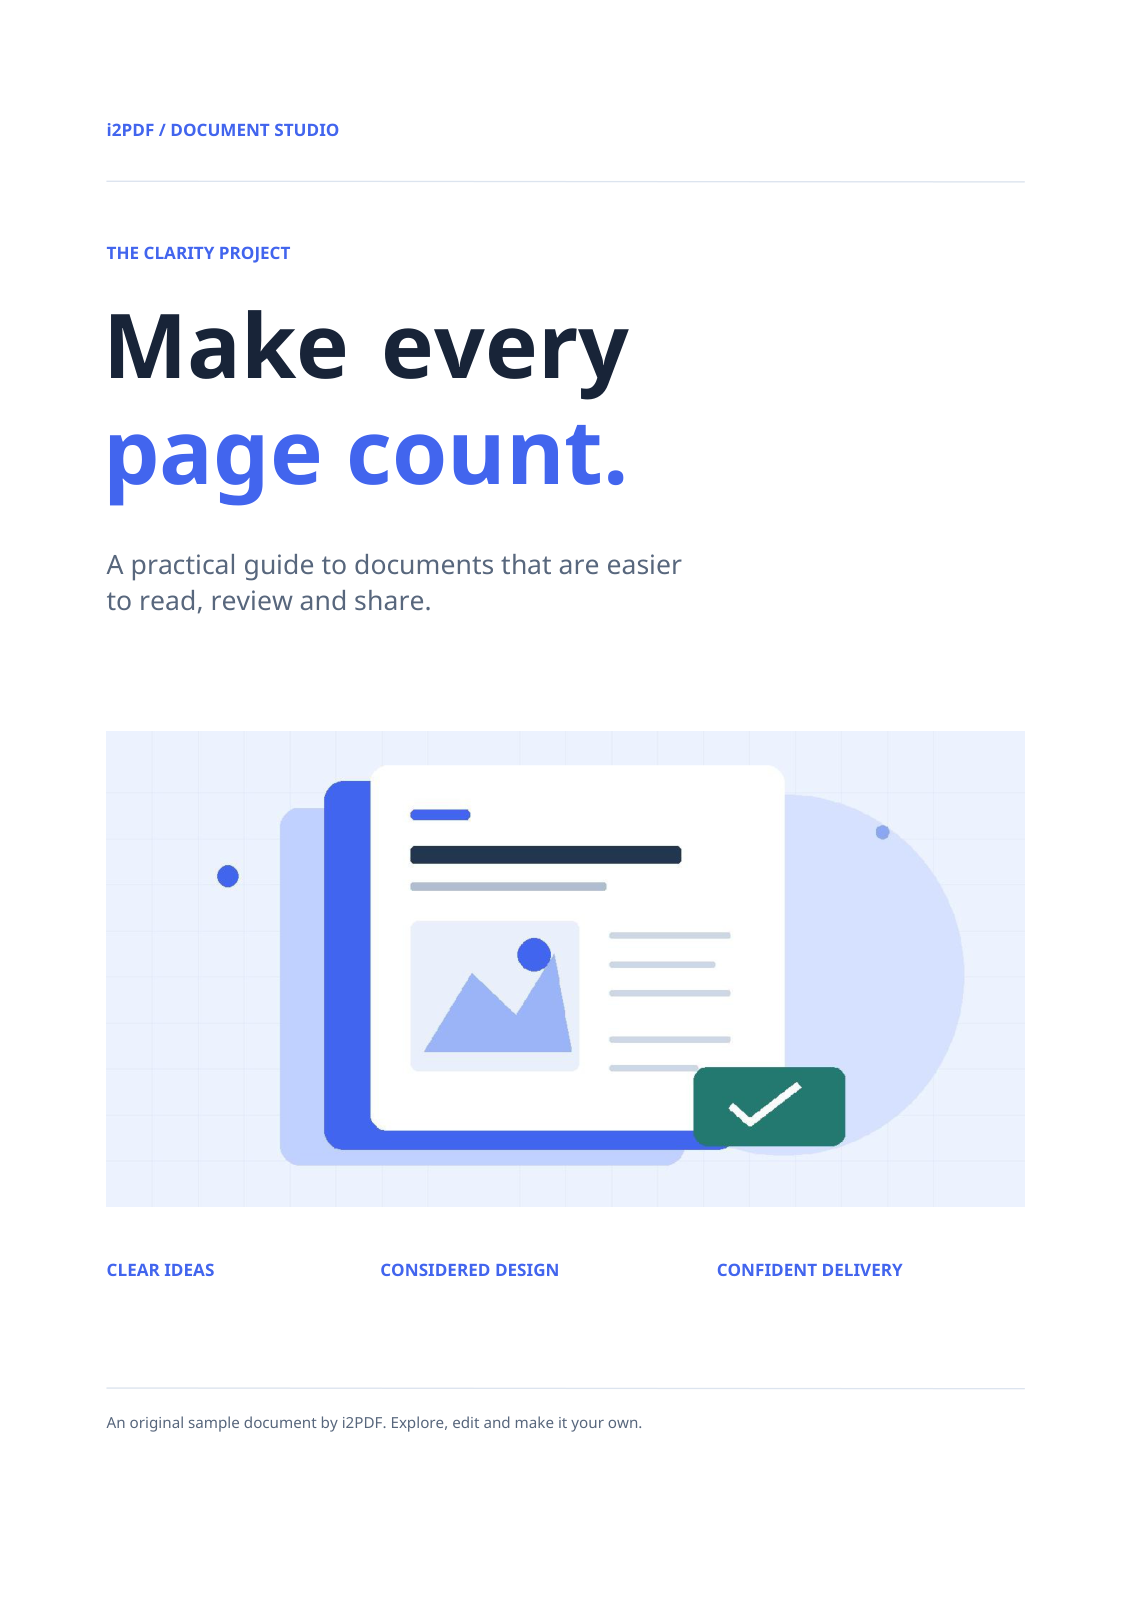
Välj Start, ladda sedan ner DOCX-filen och öppna den i en Word-redigerare. Markera en rubrik och placera markören i ett stycke för att kontrollera att innehållet kan redigeras.
Vårt resultat innehåller fyra sidor, redigerbar text och två inbyggda Word-tabeller. Granska tabellceller, styckebrytningar, kolumner, sidhuvuden och den sista raden på varje sida. Komplexa PDF-layouter kan bli flera textblock snarare än ett sammanhängande stycke.
Vanliga frågor
Kan jag konvertera en skannad PDF direkt till vanlig Word-text?
En skannad sida kan bara innehålla en bild. Använd PDF OCR för igenkänning först, och kontrollera namn, siffror och skiljetecken i resultatet.
Vilket verktyg ska jag prova för text som läses från höger till vänster?
Använd det dedikerade arbetsflödet arabiska, persiska eller hebreiska PDF till Word och granska läsriktning och blandade siffror. Dessa verktyg konverterar befintlig text; de översätter den inte.
Prova med ditt dokument
Granska resultatet och spara sedan den version du behöver.