
PDFからWordへを開き、テキスト選択可能なPDFを追加して必要なページを選択します。ツールがコンテンツをDOCXファイルとして再構築するため、Wordエディタで開いて修正できます。
テキストが使用可能なPDFを読み込む
PDFを追加するか、サンプルを選択してください。ソースドキュメント内の単語を選択してみてください。テキスト選択可能な状態の方が、ページの画像よりも適した開始点となります。
ドキュメントが画像のみの場合は、まずPDF OCRから開始し、認識されたテキストを確認してください。OCRは別の操作であり、認識ミスが発生する可能性があります。
変換するページを選択する
ドキュメント全体を変換する場合はページを空欄のままにしてください(50ページの変換制限が適用されます)。一部のみを変換するには、1-3、5のように範囲を入力してください。
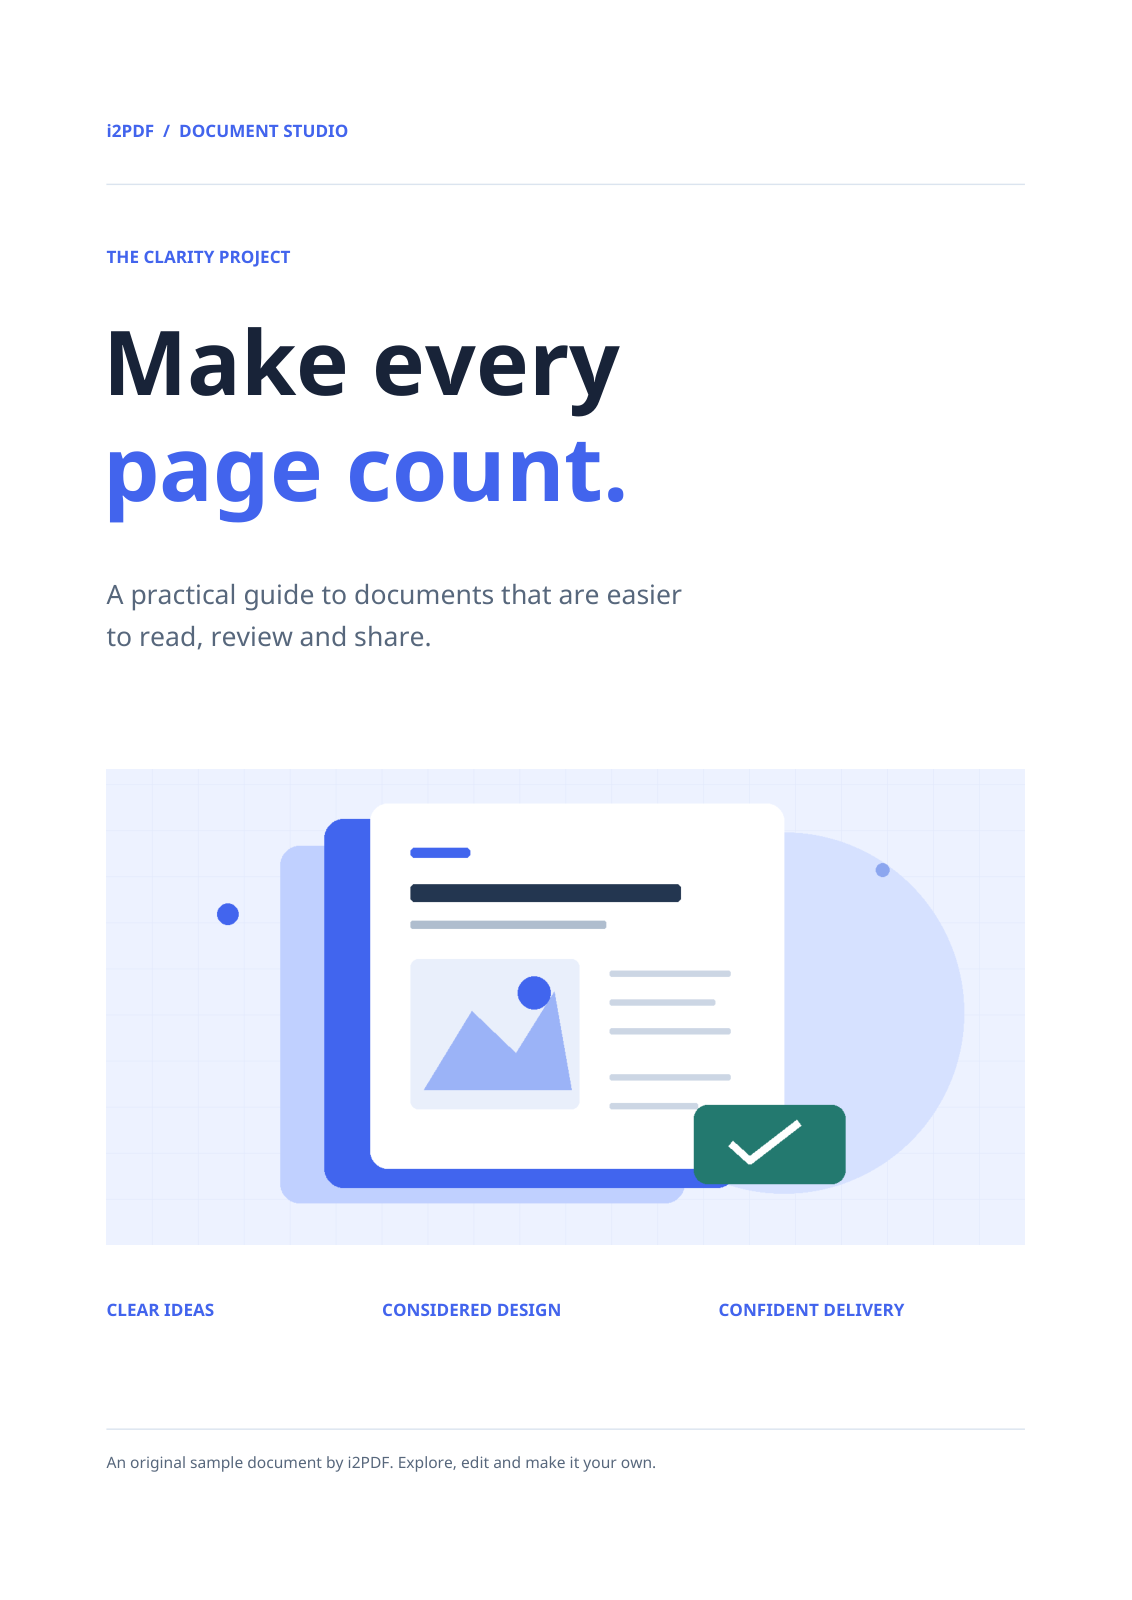
50ページを超える場合は、1-50や51-100のように範囲を分けて変換してください。選択範囲が制限を超える場合、最初の50ページのみが変換されます。この例ではフィールドを空欄のままにし、全4ページを含めています。
DOCXを作成して確認する
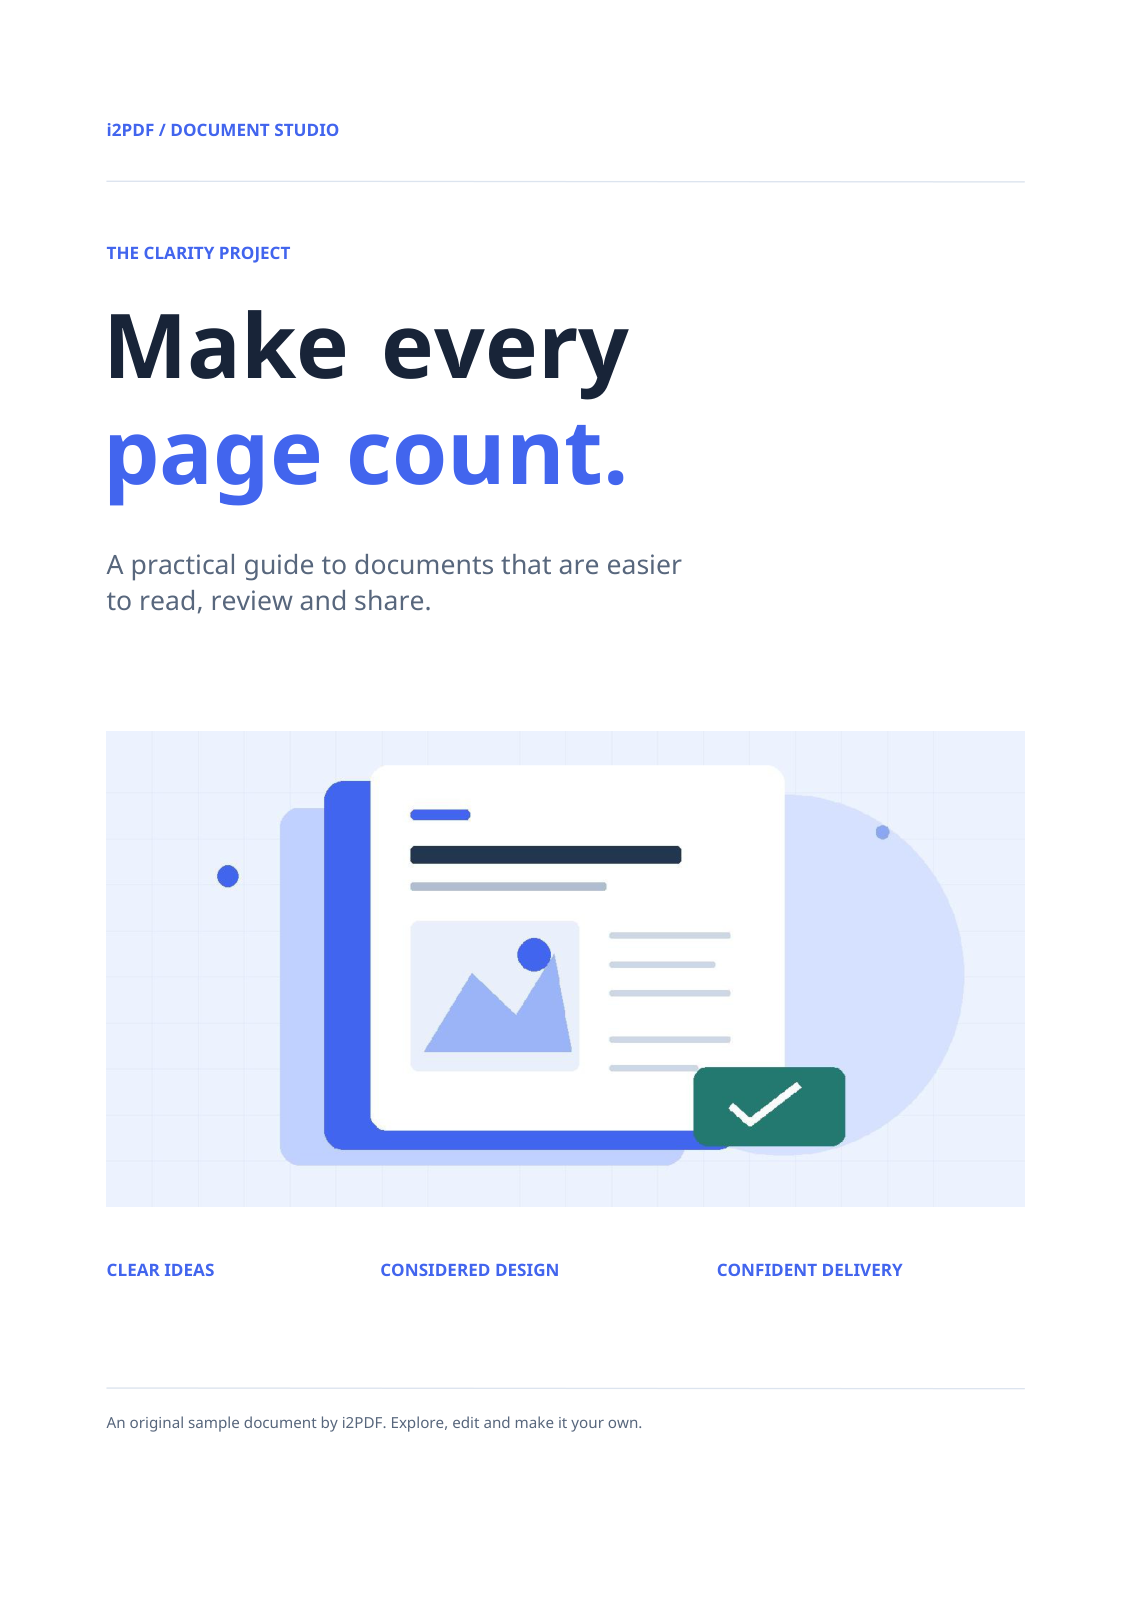
開始を選択し、DOCXをダウンロードしてWordエディタで開きます。見出しを選択し、段落内にカーソルを置いてコンテンツが編集可能であることを確認してください。
結果には4ページ分、編集可能なテキスト、および2つのネイティブWordテーブルが含まれます。テーブルのセル、段落の区切り、列、ヘッダー、および各ページの最終行を確認してください。複雑なPDFレイアウトは、流れるような段落ではなく、複数のテキストブロックになる場合があります。
よくある質問
スキャンされたPDFを直接通常のWordテキストに変換できますか?
スキャンされたページには画像しか含まれていない場合があります。最初にPDF OCRを使用して認識を行い、出力された名前、数字、句読点を確認してください。
右から左に記述される言語のテキストにはどのツールを試すべきですか?
専用のアラビア語、ペルシア語、またはヘブライ語PDFからWordへのワークフローを使用し、読み取り方向と混在する数字を確認してください。これらのツールは既存のテキストを変換するものであり、翻訳は行いません。
お手元のドキュメントで試す
結果を確認し、必要なバージョンを保存してください。