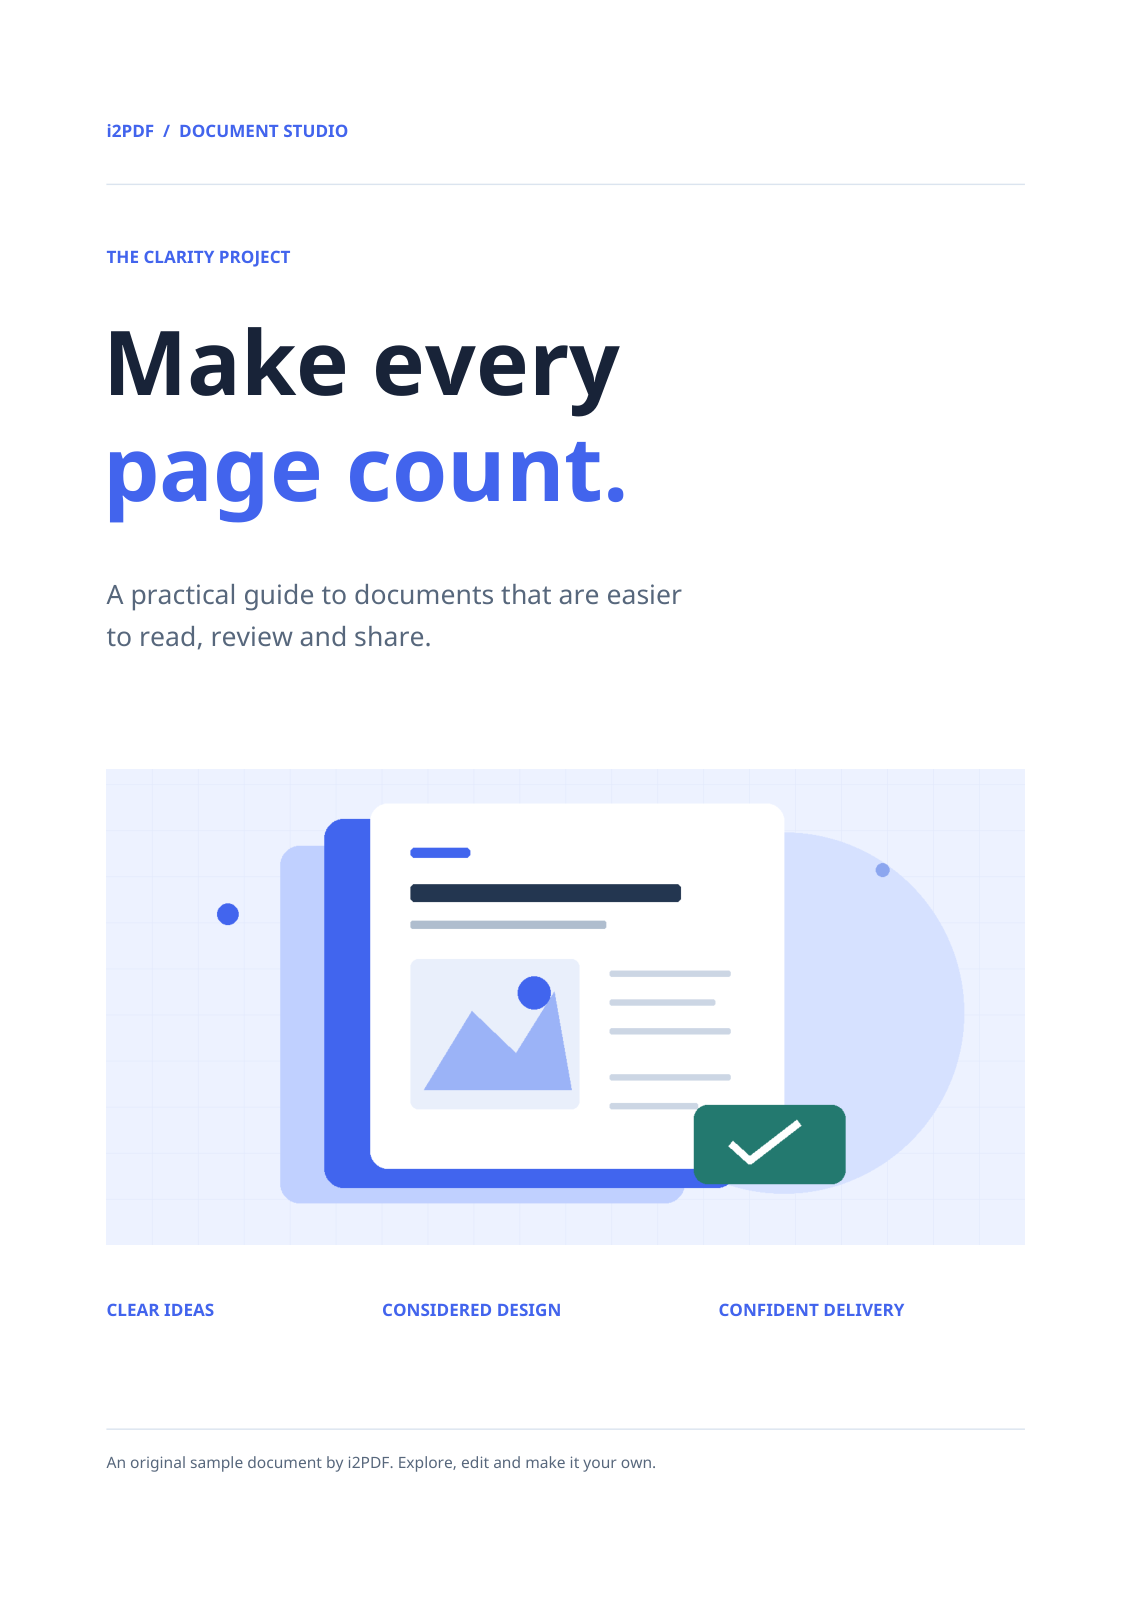

Используйте Извлечь изображения из PDF, чтобы сохранить картинки, встроенные в выбранные страницы. Наш четырехстраничный образец содержит одно извлекаемое изображение; скачанный ZIP-архив содержит файл JPG размером 1440 × 744 пикселя.
Откройте PDF
Добавьте ваш PDF и просмотрите страницы, на которых есть нужные вам изображения. Страница может сочетать текст, векторную графику и встроенные изображения; этот инструмент извлекает только объекты изображений.
Отсканированная страница может быть одним большим встроенным изображением. Логотип, полностью состоящий из векторных контуров, может вообще не содержать извлекаемых изображений.
Выберите страницы и формат изображения
Оставьте диапазон страниц пустым, чтобы просмотреть все страницы, или введите нужные. Выберите JPG, чтобы повторить этот пример; также доступны форматы PNG и TIFF.
JPG перекодируется и использует белый фон там, где изображение было прозрачным. Выбирайте PNG, если нужно сохранить прозрачность. Выходные файлы используют выбранный формат, а не обязательно сохраняют исходные сжатые байты изображения.
Извлеките и распакуйте ZIP
Нажмите Начать, скачайте ZIP-архив и распакуйте его. Имена файлов указывают на исходную страницу и номер изображения. В этом примере получается файл page-001-image-001.jpg размером 1440 × 744 пикселя.
Откройте извлеченные файлы, чтобы проверить картинку, прозрачность и разрешение. Если вам нужна вся страница целиком, включая текст и макет, используйте PDF в изображения.
Часто задаваемые вопросы
Почему в результате отсутствует заголовок страницы?
В этом примере заголовок является отдельным текстовым объектом PDF. Извлечение изображений сохраняет встроенную картинку без окружающего текста или векторных объектов.
Почему в моем PDF нет изображений?
Некоторые PDF-файлы содержат только текст и векторную графику. Преобразуйте всю страницу в изображение, если вам нужна визуальная копия этого контента.
Попробуйте на своем документе
Проверьте результат, затем сохраните нужную версию.