
PDFから画像を抽出を使用して、選択したページに埋め込まれた画像を保存します。4ページのサンプルには抽出可能な画像が1枚含まれており、ダウンロードしたZIPファイルには1440 × 744ピクセルのJPG画像が格納されています。
PDFを開く
PDFを追加し、必要な画像が含まれているページを確認します。1ページの中にテキスト、ベクターアート、埋め込み画像が混在している場合がありますが、このツールで抽出できるのは画像オブジェクトのみです。
スキャンされたページは、1つの大きな埋め込み画像として扱われることがあります。完全にベクターパスで作成されたロゴには、抽出可能な画像が含まれていない場合があります。
ページと画像形式を選択する
ページ範囲を空欄にすると全ページが対象となります。特定のページのみ抽出したい場合はページ番号を入力してください。この例ではJPGを選択していますが、PNGやTIFFも利用可能です。
JPGは再エンコードされ、透明な部分は白背景になります。透明度を保持する必要がある場合はPNGを選択してください。出力ファイルは選択した形式で保存され、元の圧縮画像バイトがそのまま保持されるとは限りません。
抽出してZIPを解凍する
開始を選択し、ZIPファイルをダウンロードして解凍してください。ファイル名には元のページ番号と画像番号が含まれます。この例では、1440 × 744ピクセルのpage-001-image-001.jpgが生成されます。
解凍したファイルを開き、画像、透明度、解像度を確認してください。テキストやレイアウトを含めたページ全体が必要な場合は、代わりにPDFを画像に変換を使用してください。
よくある質問
結果からページ見出しが省略されるのはなぜですか?
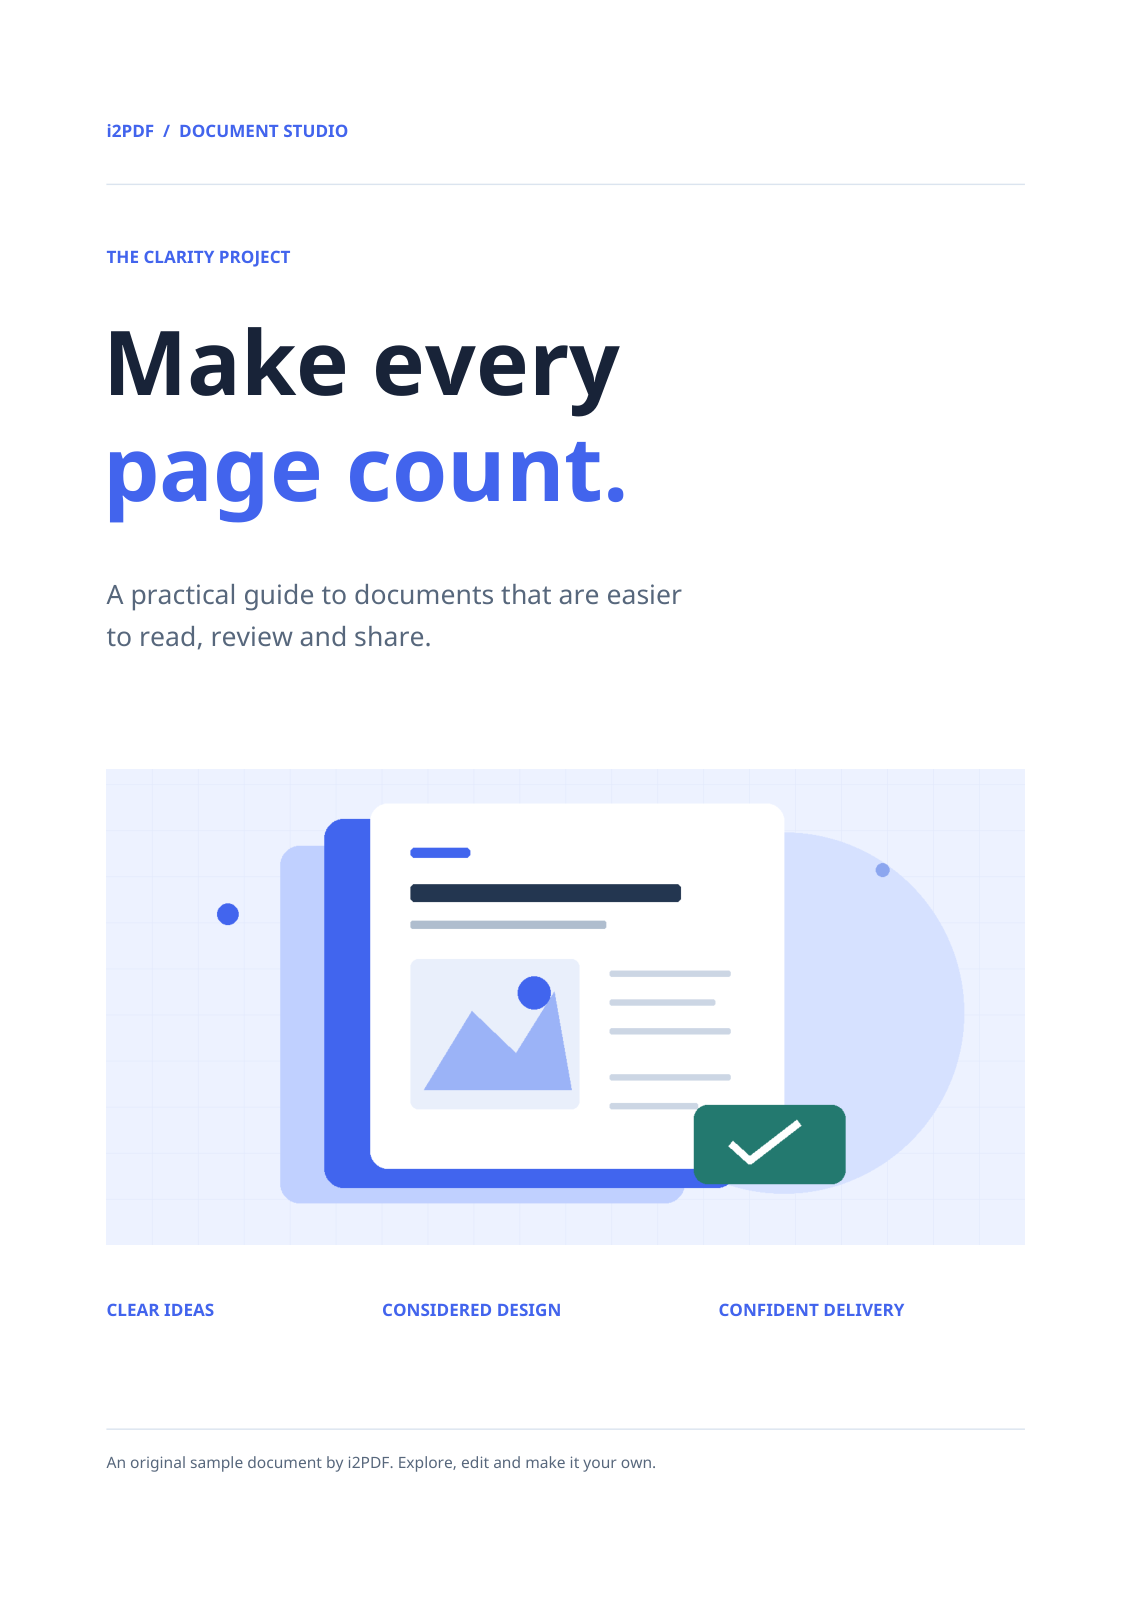
この例では、見出しはPDF内の独立したテキストです。画像抽出では、周囲のテキストやベクターオブジェクトを含めず、埋め込まれた画像のみを保存します。
PDFに画像が含まれていないのはなぜですか?
PDFの中には、テキストとベクターアートのみで構成されているものがあります。そのようなコンテンツの視覚的なコピーが必要な場合は、ページ全体を画像に変換してください。
ドキュメントで試す
結果を確認し、必要なバージョンを保存してください。