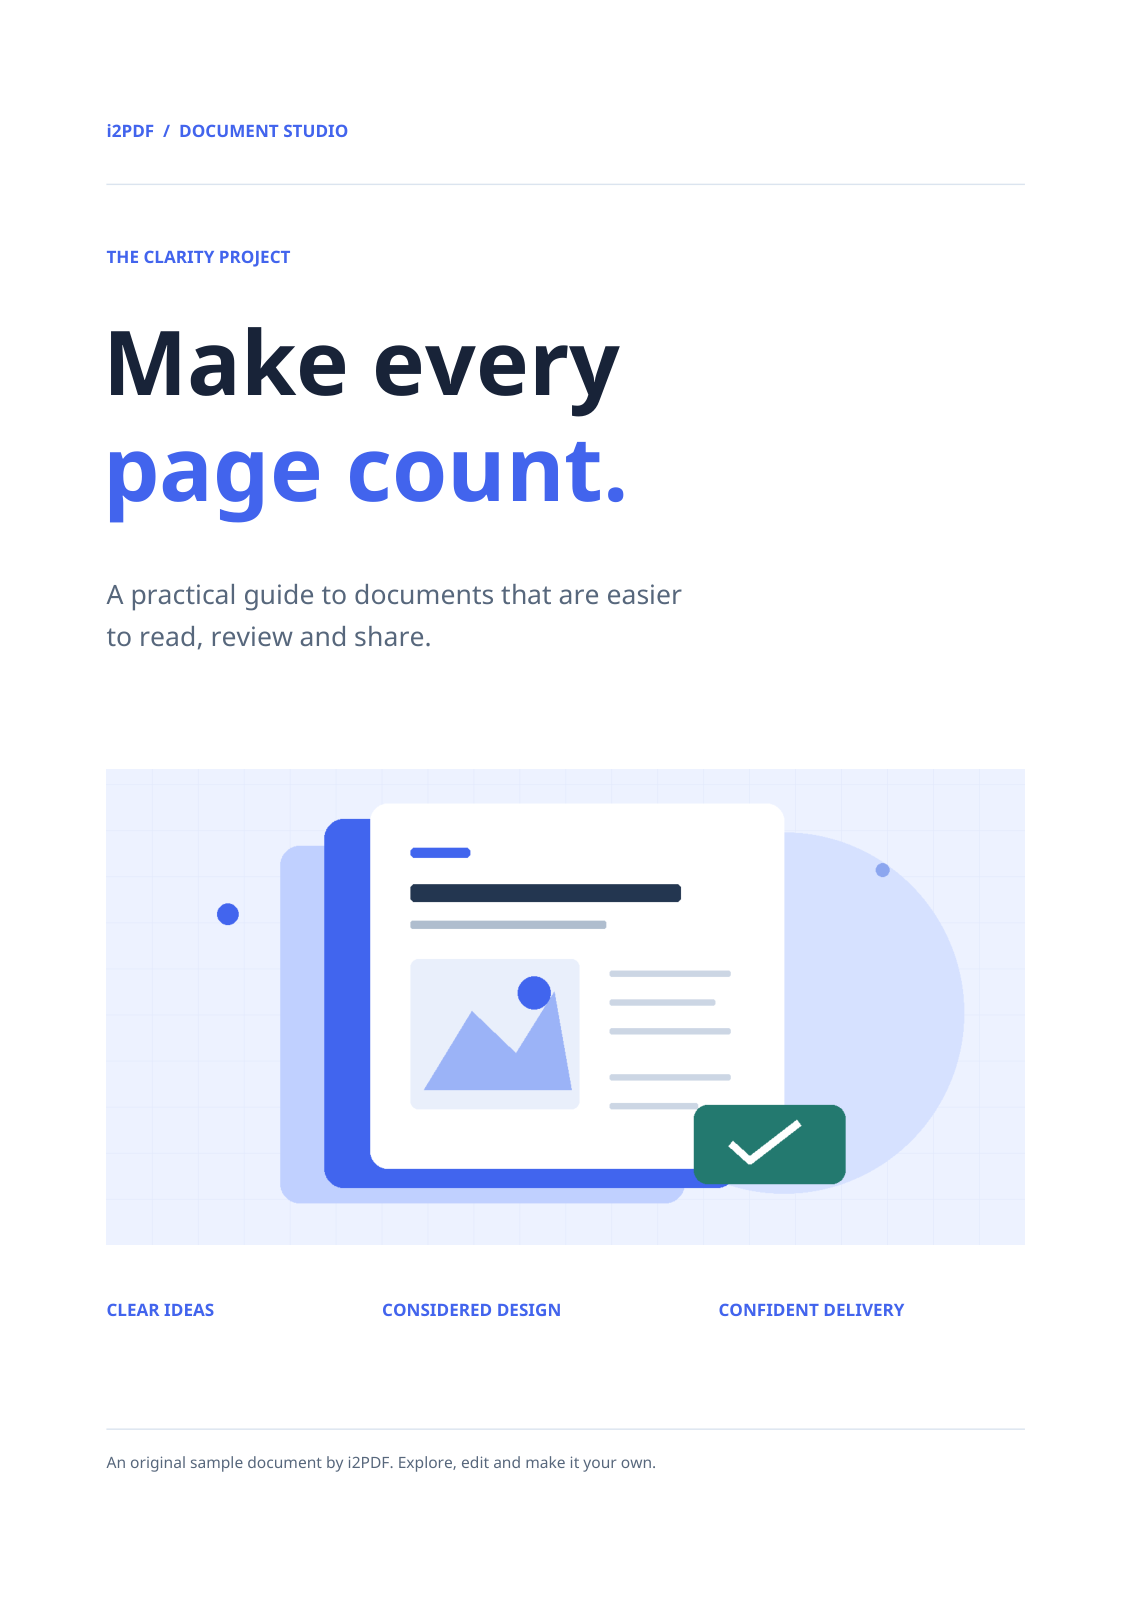

Använd Extrahera bilder från PDF för att spara bilderna som är inbäddade på valda sidor. Vårt exempel på fyra sidor innehåller en extraherbar bild; den nedladdade ZIP-filen innehåller en JPG som mäter 1440 × 744 pixlar.
Öppna PDF-filen
Lägg till din PDF och granska sidorna som innehåller bilderna du behöver. En sida kan kombinera text, vektorgrafik och inbäddade bilder; endast bildobjekten extraheras av detta verktyg.
En skannad sida kan vara en enda stor inbäddad bild. En logotyp som helt består av vektorsökvägar kanske inte har någon extraherbar bild alls.
Välj sidor och bildformat
Lämna sidintervallet tomt för att undersöka alla sidor, eller ange sidorna du vill ha. Välj JPG för att återskapa detta exempel; PNG och TIFF finns också tillgängliga.
JPG omkodas och använder en vit bakgrund där bilden är transparent. Välj PNG när du behöver behålla tillgänglig transparens. Utdatafilerna använder det valda formatet snarare än att nödvändigtvis bevara de ursprungliga komprimerade bildbyten.
Extrahera och packa upp ZIP-filen
Välj Start, ladda ner ZIP-filen och packa upp den. Filnamnen identifierar källsidan och bildnumret. Detta exempel skapar page-001-image-001.jpg med 1440 × 744 pixlar.
Öppna de extraherade filerna för att kontrollera bilden, transparensen och upplösningen. Om du behöver hela sidan, inklusive dess text och layout, använd PDF till bilder istället.
Vanliga frågor
Varför utelämnar resultatet sidrubriken?
Rubriken är separat PDF-text i detta exempel. Bildextrahering sparar den inbäddade bilden utan omgivande text eller vektorobjekt.
Varför finns det inga bilder i min PDF?
Vissa PDF-filer innehåller endast text och vektorgrafik. Konvertera hela sidan till en bild om du behöver en visuell kopia av det innehållet.
Prova med ditt dokument
Granska resultatet och spara sedan den version du behöver.