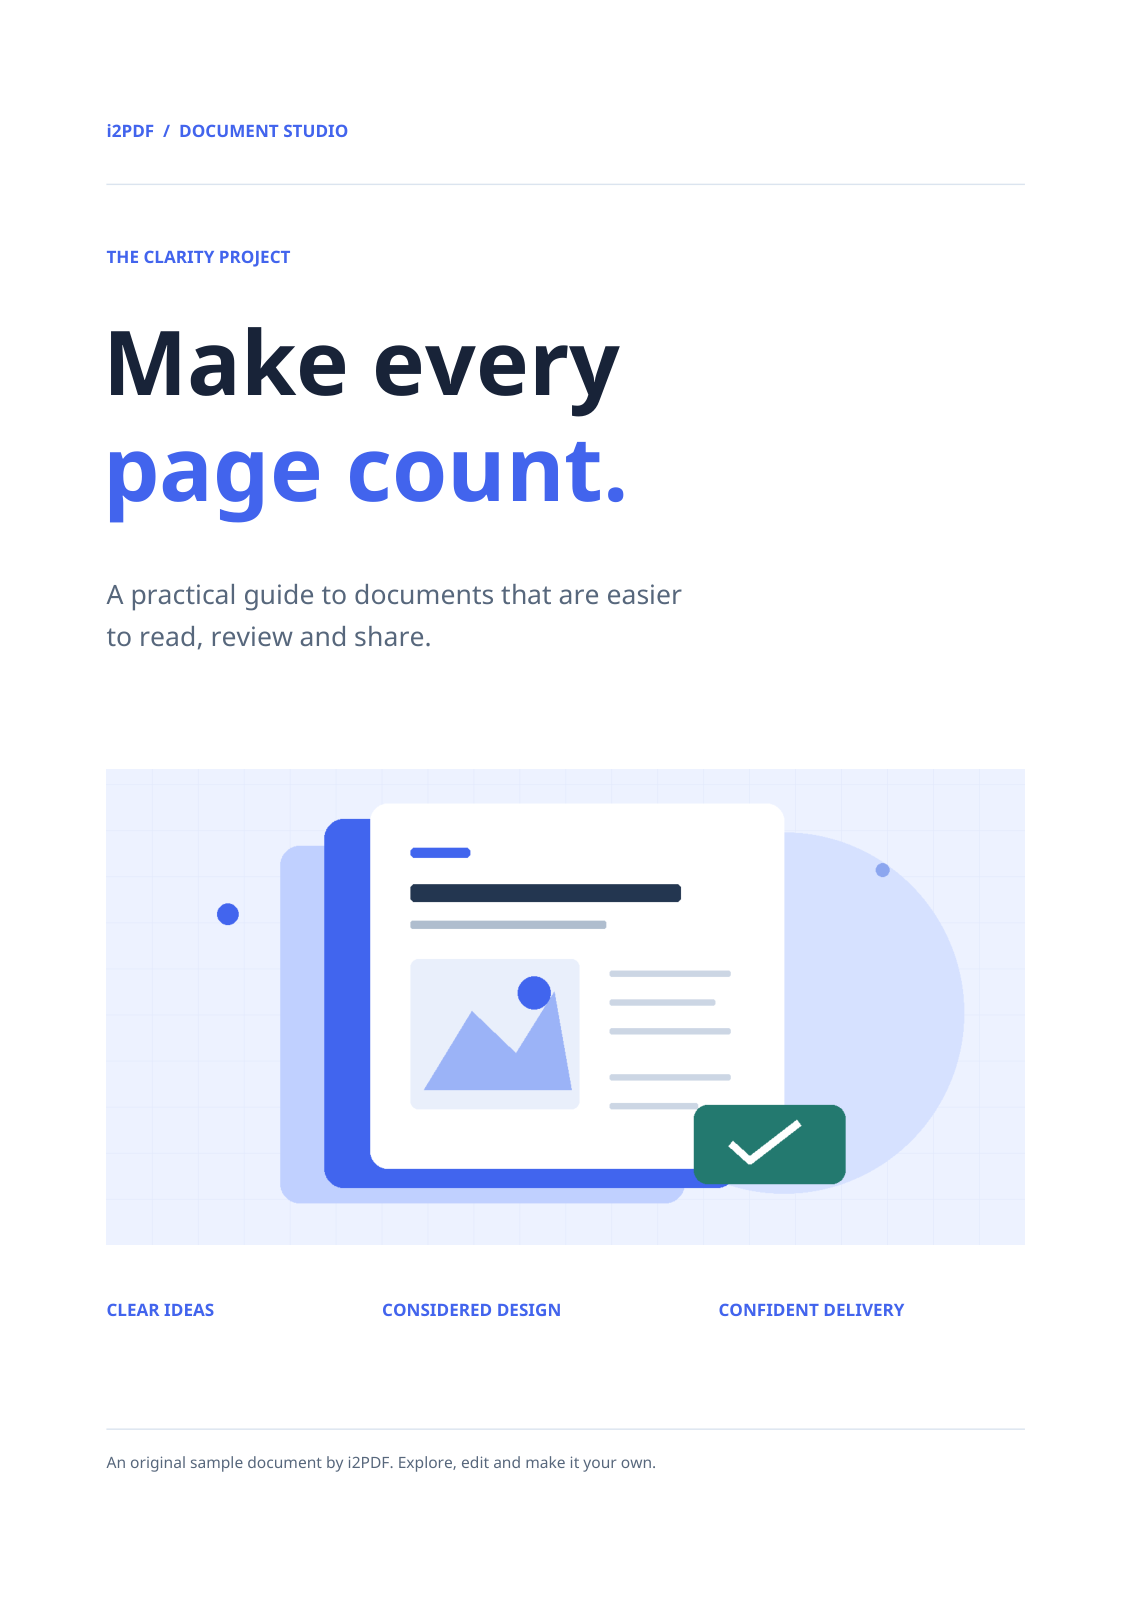

Bruk Trekk ut bilder fra PDF for å lagre bildene som er innebygd i valgte sider. Vårt eksempel på fire sider inneholder ett bilde som kan trekkes ut; den nedlastede ZIP-filen inneholder en JPG som måler 1440 × 744 piksler.
Åpne PDF-filen
Legg til PDF-filen din og gå gjennom sidene som inneholder bildene du trenger. En side kan kombinere tekst, vektorgrafikk og innebygde bilder; kun bildeobjektene trekkes ut av dette verktøyet.
En skannet side kan være ett stort innebygd bilde. En logo laget utelukkende av vektorspor har kanskje ingen bilder som kan trekkes ut i det hele tatt.
Velg sider og bildeformat
La sideområdet stå tomt for å undersøke alle sider, eller skriv inn sidene du ønsker. Velg JPG for å gjenskape dette eksemplet; PNG og TIFF er også tilgjengelige.
JPG blir kodet på nytt og bruker en hvit bakgrunn der bildet er gjennomsiktig. Velg PNG når du trenger å beholde tilgjengelig gjennomsiktighet. Utdatafilene bruker det valgte formatet i stedet for nødvendigvis å bevare de originale komprimerte bildedataene.
Trekk ut og pakk ut ZIP-filen
Velg Start, last ned ZIP-filen og pakk den ut. Filnavnene identifiserer kildesiden og bildenummeret. Dette eksemplet produserer side-001-bilde-001.jpg på 1440 × 744 piksler.
Åpne de uttrukne filene for å kontrollere bildet, gjennomsiktigheten og oppløsningen. Hvis du trenger hele siden, inkludert tekst og layout, bruk PDF til bilder i stedet.
Vanlige spørsmål
Hvorfor utelater resultatet sideoverskriften?
Overskriften er separat PDF-tekst i dette eksemplet. Bildeuttrekking lagrer det innebygde bildet uten omkringliggende tekst eller vektorobjekter.
Hvorfor er det ingen bilder i PDF-filen min?
Noen PDF-filer inneholder kun tekst og vektorgrafikk. Konverter hele siden til et bilde hvis du trenger en visuell kopi av det innholdet.
Prøv det med dokumentet ditt
Gå gjennom resultatet, og lagre deretter versjonen du trenger.