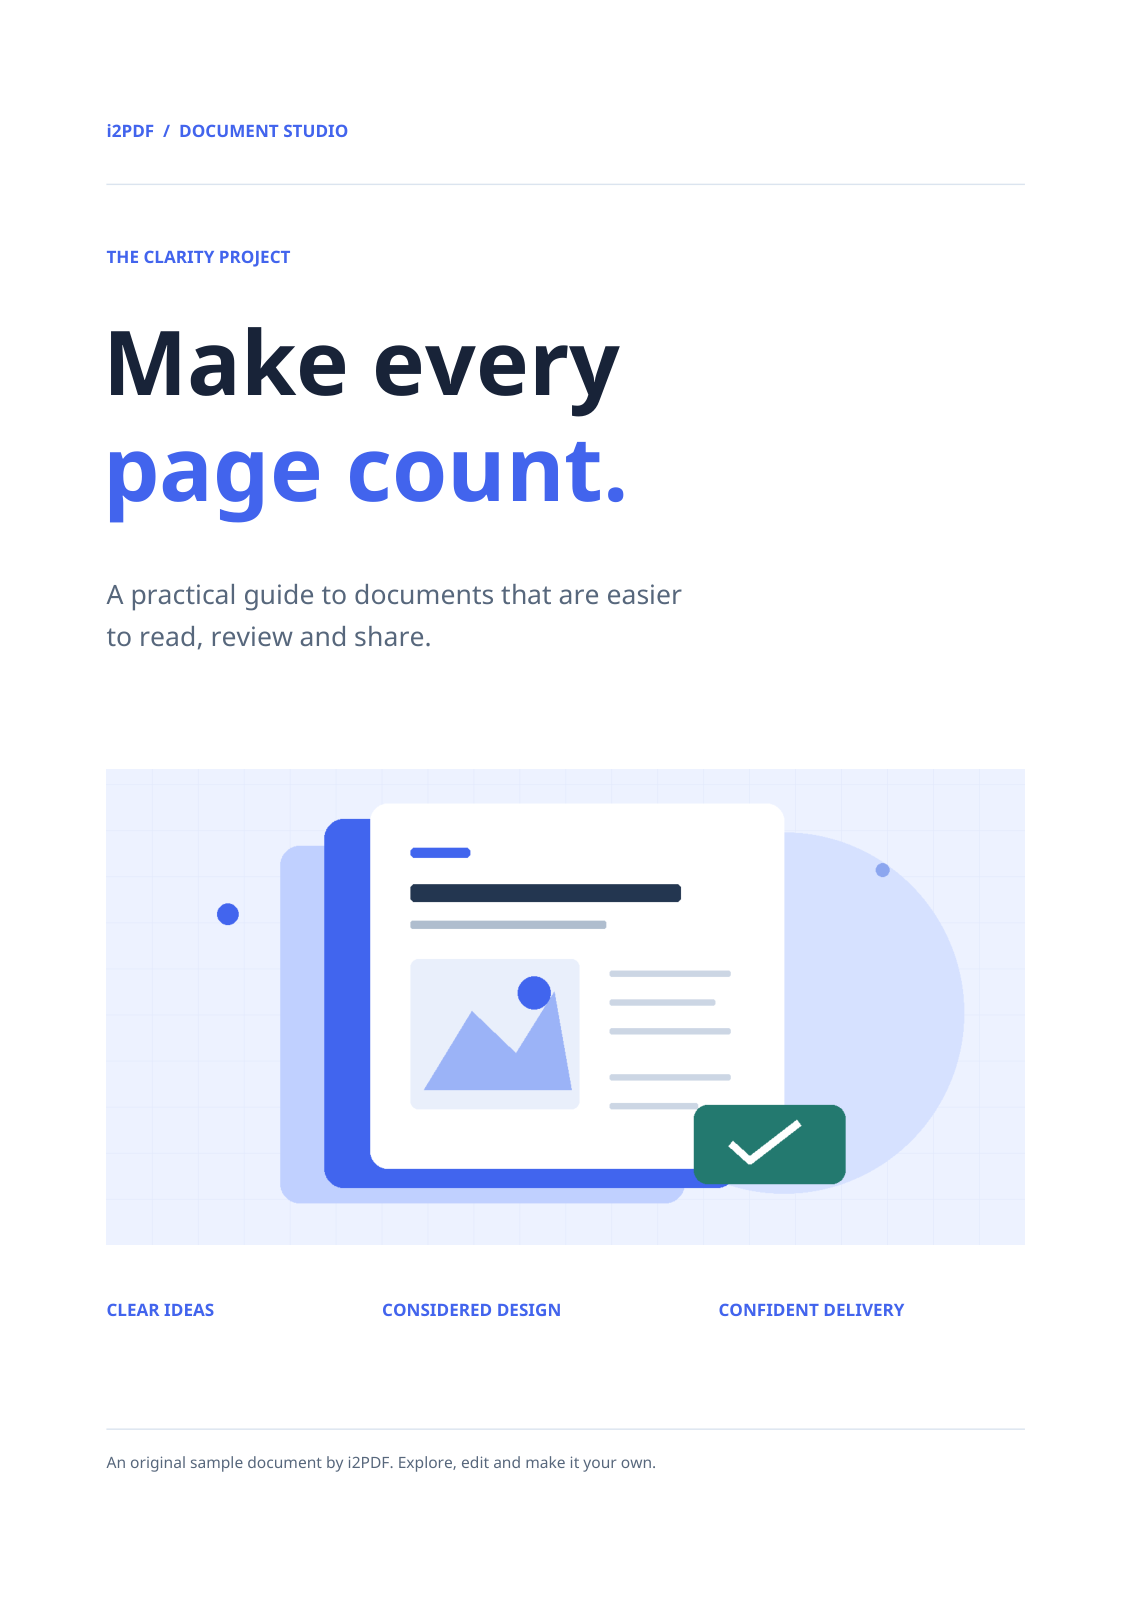

Użyj Wyodrębnij obrazy z PDF, aby zapisać zdjęcia osadzone na wybranych stronach. Nasz czterostronicowy przykład zawiera jeden obraz możliwy do wyodrębnienia; pobrany plik ZIP zawiera plik JPG o wymiarach 1440 × 744 pikseli.
Otwórz plik PDF
Dodaj plik PDF i przejrzyj strony zawierające potrzebne zdjęcia. Strona może łączyć tekst, grafikę wektorową i osadzone obrazy; to narzędzie wyodrębnia tylko obiekty graficzne.
Zeskanowana strona może być pojedynczym, dużym osadzonym obrazem. Logo wykonane w całości z ścieżek wektorowych może w ogóle nie zawierać obrazów możliwych do wyodrębnienia.
Wybierz strony i format obrazu
Pozostaw zakres stron pusty, aby sprawdzić wszystkie strony, lub wprowadź wybrane numery. Wybierz JPG, aby odtworzyć ten przykład; dostępne są również formaty PNG i TIFF.
Plik JPG jest ponownie kodowany i używa białego tła w miejscach, gdzie obraz był przezroczysty. Wybierz PNG, jeśli chcesz zachować przezroczystość. Pliki wyjściowe używają wybranego formatu, zamiast koniecznie zachowywać oryginalne skompresowane bajty obrazu.
Wyodrębnij i rozpakuj plik ZIP
Wybierz Start, pobierz plik ZIP i rozpakuj go. Nazwy plików identyfikują stronę źródłową i numer obrazu. Ten przykład tworzy plik page-001-image-001.jpg o wymiarach 1440 × 744 pikseli.
Otwórz wyodrębnione pliki, aby sprawdzić obraz, przezroczystość i rozdzielczość. Jeśli potrzebujesz całej strony, w tym tekstu i układu, użyj zamiast tego PDF na obrazy.
Często zadawane pytania
Dlaczego wynik pomija nagłówek strony?
Nagłówek w tym przykładzie jest oddzielnym tekstem PDF. Wyodrębnianie obrazów zapisuje osadzone zdjęcie bez otaczającego go tekstu lub obiektów wektorowych.
Dlaczego w moim pliku PDF nie ma obrazów?
Niektóre pliki PDF zawierają tylko tekst i grafikę wektorową. Konwertuj całą stronę na obraz, jeśli potrzebujesz wizualnej kopii tej zawartości.
Wypróbuj na swoim dokumencie
Sprawdź wynik, a następnie zapisz potrzebną wersję.