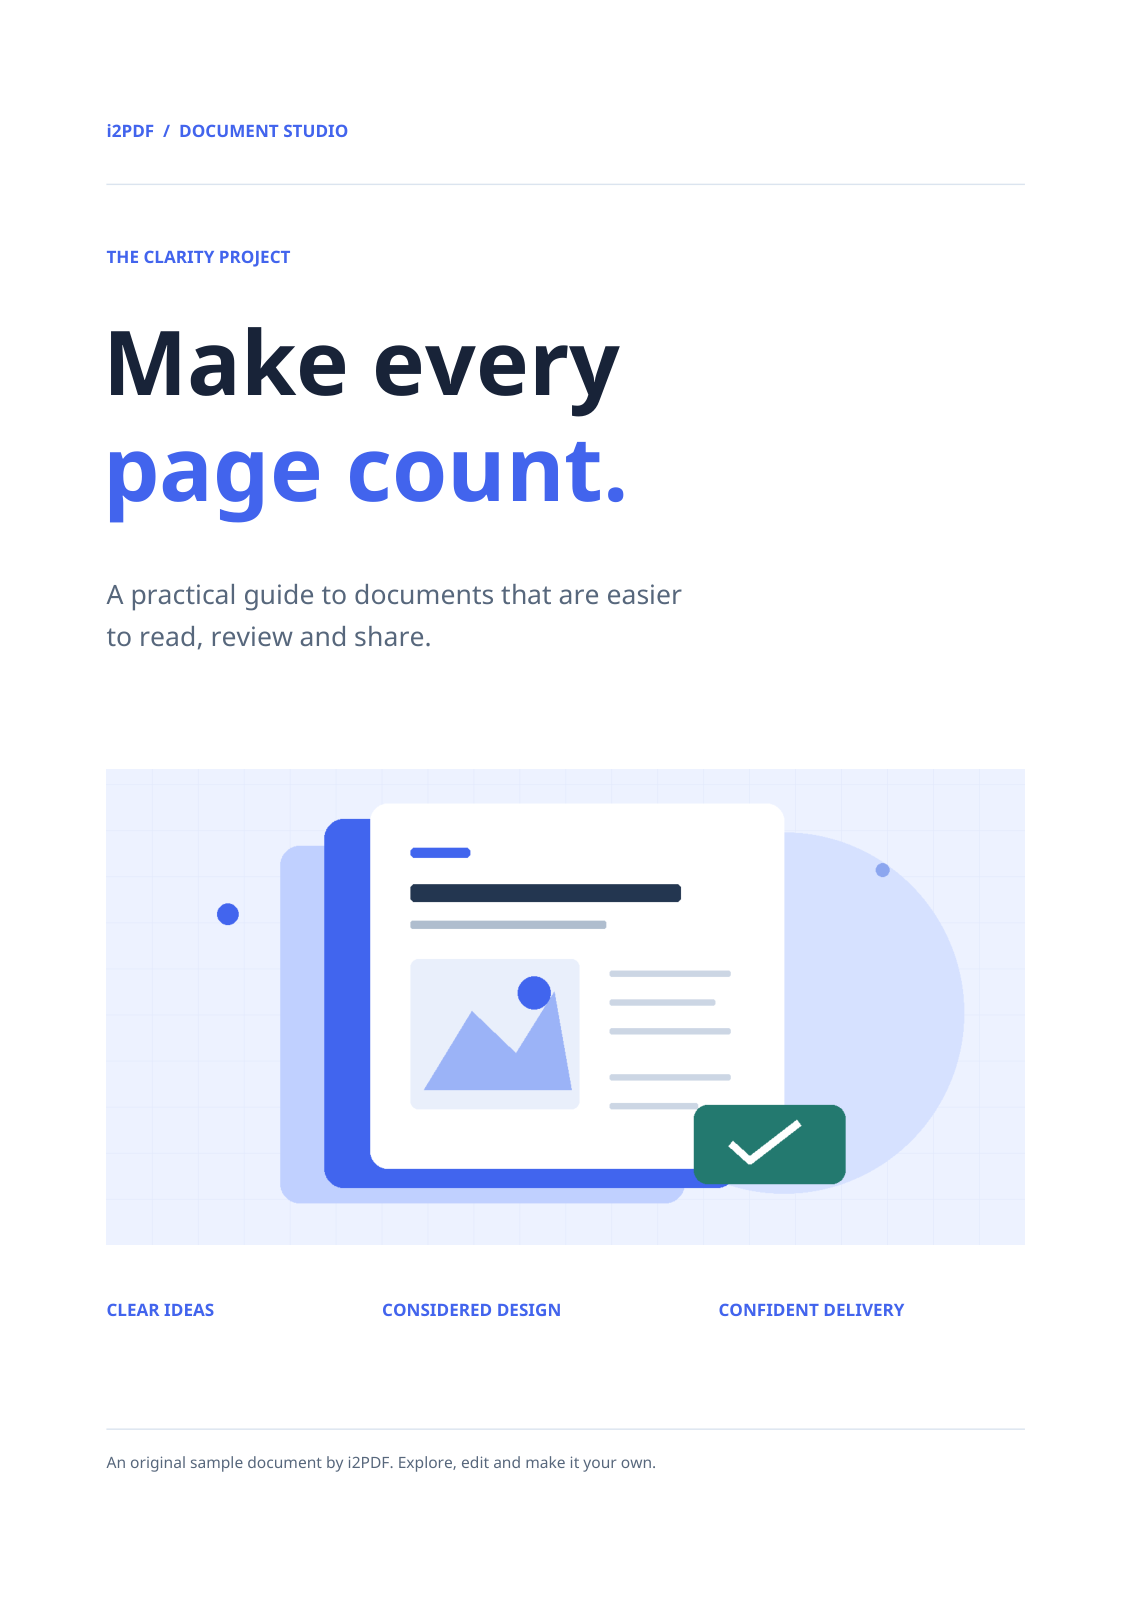

Brug Udtræk billeder fra PDF til at gemme de billeder, der er indlejret på de valgte sider. Vores eksempel på fire sider indeholder ét billede, der kan udtrækkes; den downloadede ZIP-fil indeholder en JPG, der måler 1440 × 744 pixels.
Åbn PDF-filen
Tilføj din PDF og gennemse de sider, der indeholder de billeder, du har brug for. En side kan kombinere tekst, vektorgrafik og indlejrede billeder; kun billedobjekterne udtrækkes af dette værktøj.
En scannet side kan være et enkelt stort indlejret billede. Et logo, der udelukkende er lavet af vektorstier, har muligvis slet ikke noget billede, der kan udtrækkes.
Vælg sider og billedformat
Lad sideområdet stå tomt for at undersøge alle sider, eller indtast de sider, du ønsker. Vælg JPG for at gengive dette eksempel; PNG og TIFF er også tilgængelige.
JPG bliver genkodet og bruger en hvid baggrund, hvor billedet er gennemsigtigt. Vælg PNG, når du har brug for at bevare tilgængelig gennemsigtighed. Outputfilerne bruger det valgte format frem for nødvendigvis at bevare de originale komprimerede billedbytes.
Udtræk og udpak ZIP-filen
Vælg Start, download ZIP-filen og udpak den. Filnavne identificerer kildesiden og billednummeret. Dette eksempel producerer page-001-image-001.jpg på 1440 × 744 pixels.
Åbn de udtrukne filer for at tjekke billedet, gennemsigtigheden og opløsningen. Hvis du har brug for hele siden, inklusive tekst og layout, skal du i stedet bruge PDF til billeder.
Almindelige spørgsmål
Hvorfor udelader resultatet sideoverskriften?
Overskriften er separat PDF-tekst i dette eksempel. Billedudtrækning gemmer det indlejrede billede uden omkringliggende tekst eller vektorobjekter.
Hvorfor er der ingen billeder i min PDF?
Nogle PDF-filer indeholder kun tekst og vektorgrafik. Konvertér hele siden til et billede, hvis du har brug for en visuel kopi af det indhold.
Prøv det med dit dokument
Gennemse resultatet, og gem derefter den version, du har brug for.