

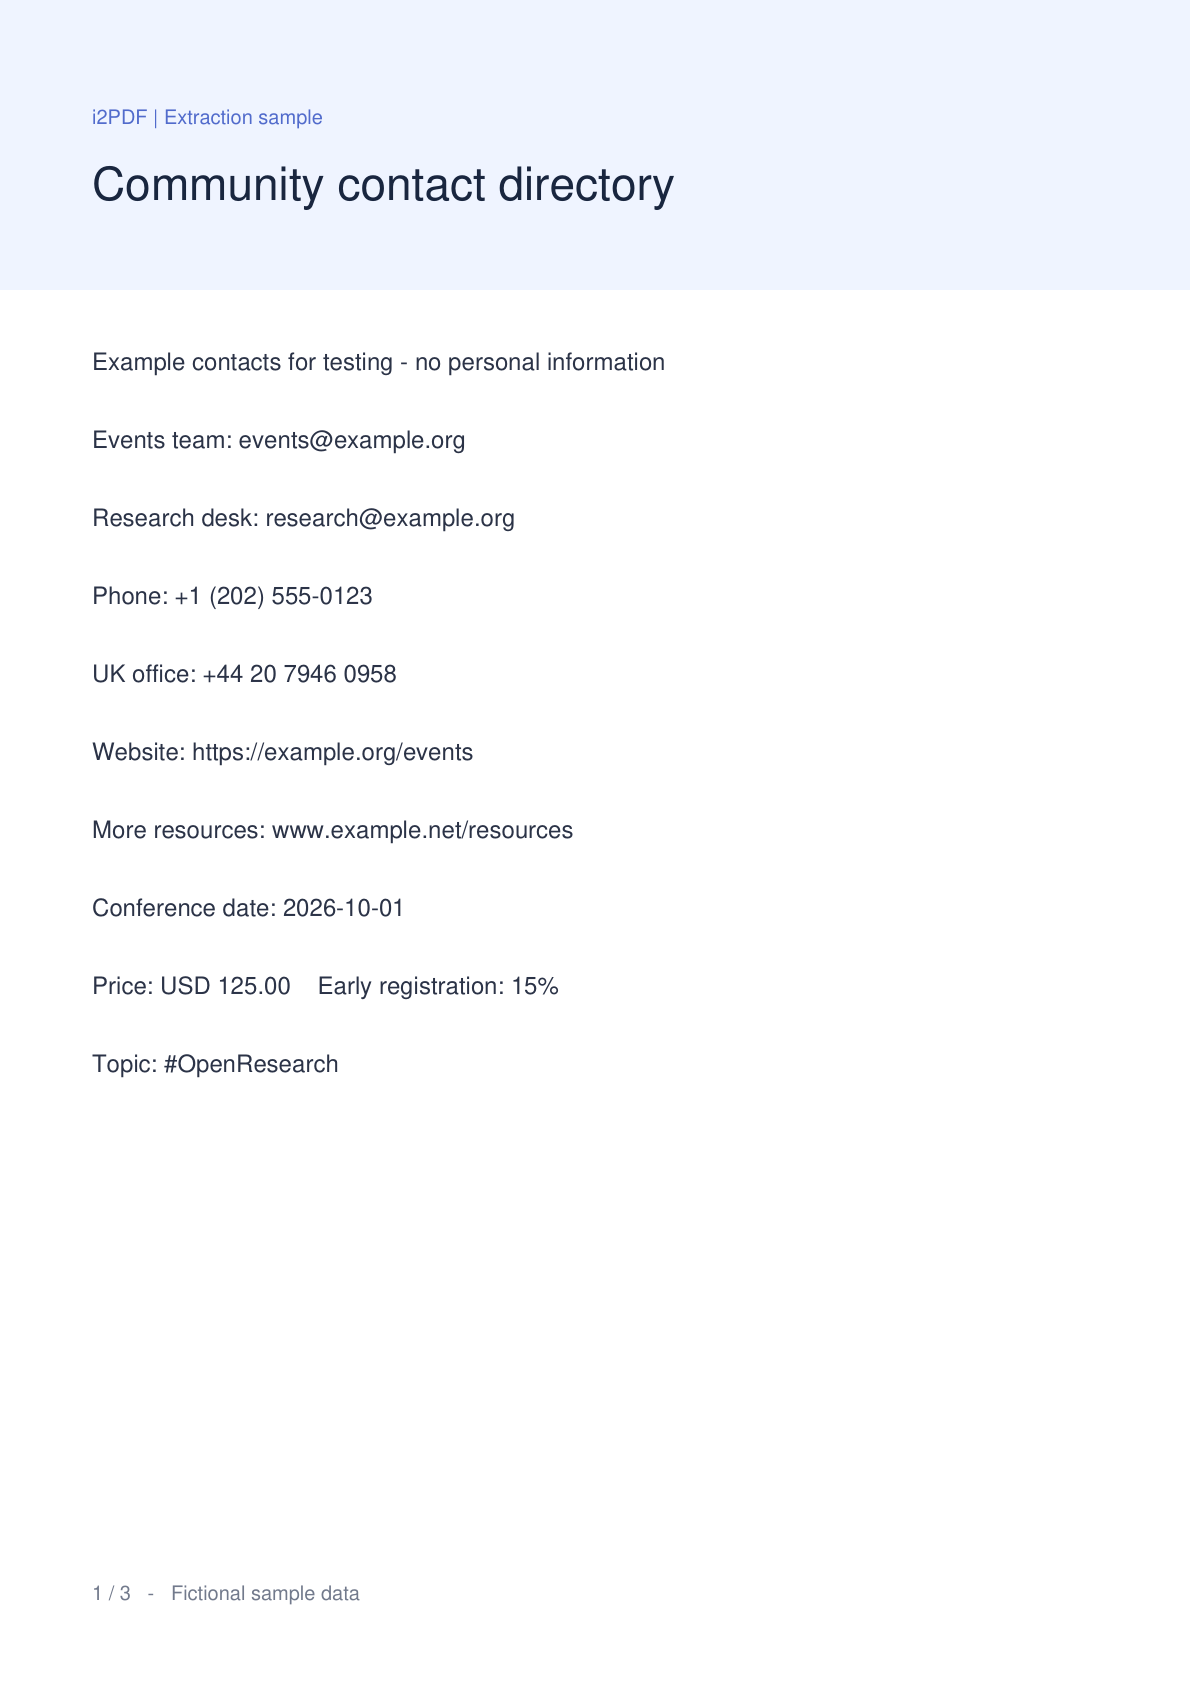
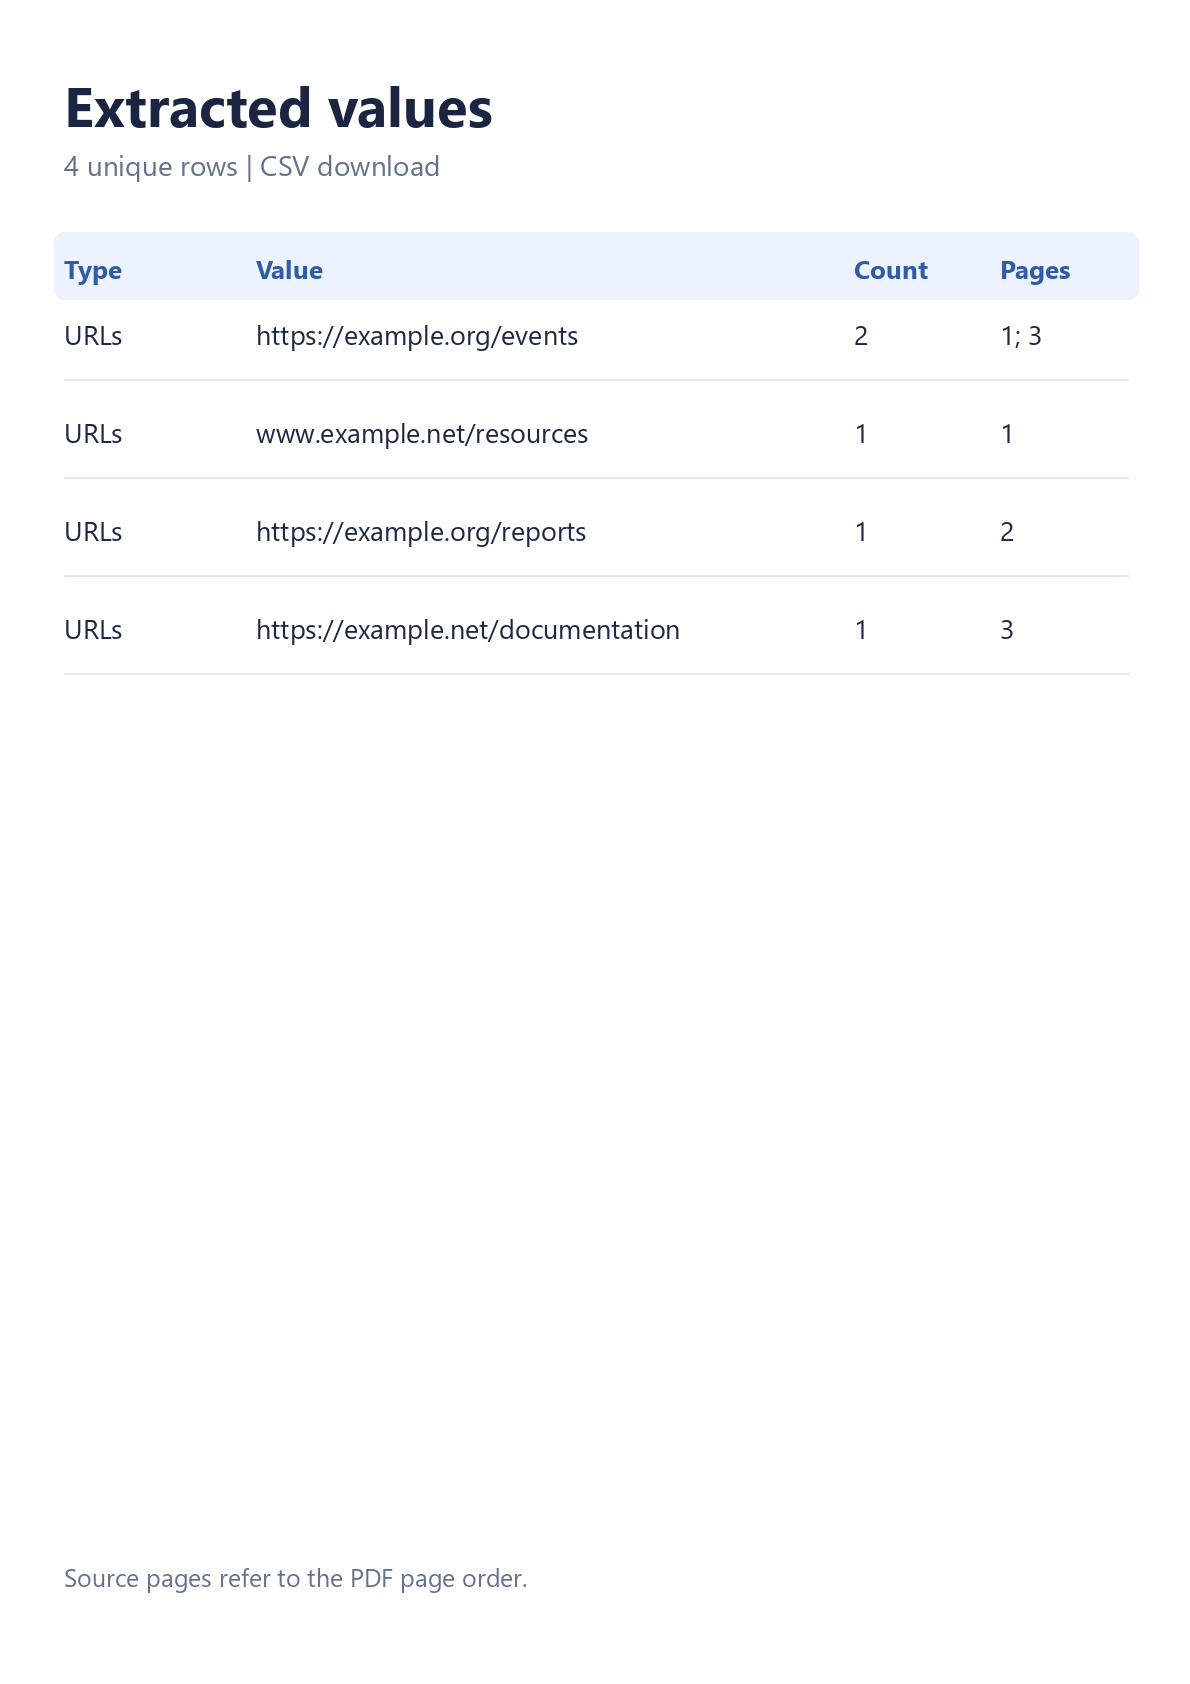

Ouvrez Extraire des liens d'un PDF pour collecter des valeurs à partir d'un PDF sans avoir à les copier ligne par ligne. La comparaison utilise le document échantillon réel et un CSV téléchargé depuis l'outil. L'échantillon de trois pages produit 4 adresses web uniques à partir de 5 occurrences.
Ouvrez votre PDF
Téléversez un PDF, ou sélectionnez Essayer l'exemple pour suivre ce guide. L'aperçu du PDF et les vignettes des pages s'affichent. Votre fichier original reste inchangé et l'extraction s'exécute dans votre navigateur.
Un répertoire, un rapport, un document de recherche ou une brochure basé sur du texte constitue un point de départ utile. Les scans contenant uniquement des images nécessitent un OCR avant que leur texte imprimé puisse être reconnu.
Choisissez les options utiles
Sur un téléphone, ouvrez Paramètres. Sur ordinateur, utilisez le panneau des paramètres à côté de l'aperçu.
Gardez Supprimer les doublons activé pour regrouper les cibles répétées. Choisissez CSV lorsque vous avez besoin de références de pages, ou TXT pour une liste d'URLs simple. L'exemple utilise le format CSV par défaut et l'ordre des sources.
Extrayez et vérifiez les correspondances
Sélectionnez Extraire. Une fois le traitement terminé, l'onglet Résultats affiche les valeurs, le nombre d'occurrences et les pages sources. Sélectionnez un numéro de page circulaire pour inspecter son emplacement dans l'aperçu du PDF, puis revenez aux Résultats.
L'échantillon inclut https://example.org/events deux fois et trois autres adresses web. Il démontre également un lien cliquable dont l'étiquette visible est différente de sa cible. Une URL imprimée et sa cible cliquable identique sur la même page ne sont pas comptées deux fois.
Utilisez Filtrer les résultats pour restreindre la liste. La copie et le téléchargement incluent toutes les lignes correspondantes, même lorsque le tableau des résultats s'étend sur plusieurs écrans.
Téléchargez le CSV ou le TXT
Sélectionnez Télécharger le CSV, puis utilisez le bouton principal Télécharger sur l'écran prêt. Le CSV contient les colonnes Type, Valeur, Occurrences et Pages. Le TXT et Copier tout contiennent une valeur par ligne.
Les valeurs CSV qui pourraient être interprétées comme des formules de tableur sont protégées par une apostrophe initiale. Par exemple, un numéro de téléphone international commence par un signe plus. Utilisez le TXT si vous avez besoin d'une liste simple sans protection pour tableur.
Questions fréquentes
Cet outil peut-il trouver un lien derrière des mots tels que « En savoir plus » ?
Oui, lorsque ces mots possèdent une annotation de lien HTTP ou HTTPS prise en charge dans le PDF. La valeur exportée est sa destination web. Un soulignement visuel seul ne prouve pas qu'un lien cliquable existe.
Que dois-je faire avec un PDF scanné ?
Exécutez PDF OCR d'abord, puis chargez la copie reconnue dans cet outil. Vérifiez attentivement la sortie OCR : un caractère erroné peut modifier une adresse ou un identifiant.
Quelles sont les limites d'extraction ?
Utilisez un PDF jusqu'à 50 MiB et 750 pages. L'extraction est limitée à 20 000 correspondances au total et 2 000 par page, avec un budget de traitement de 90 secondes. Les limites de texte et d'annotation s'appliquent également. Si une limite ou une page illisible interrompt l'analyse, l'outil affiche un avis de résultats partiels et marque le nom du fichier d'exportation comme partiel.
Mes liens PDF sont-ils ouverts automatiquement ?
Non. L'extraction lit le fichier dans le navigateur et ne visite pas les destinations extraites. Les boutons de page permettent de naviguer dans l'aperçu du PDF.
Conservez les valeurs et leur contexte
Extrayez une liste ciblée, vérifiez les pages sources et téléchargez le format qui convient à votre prochaine étape.


