

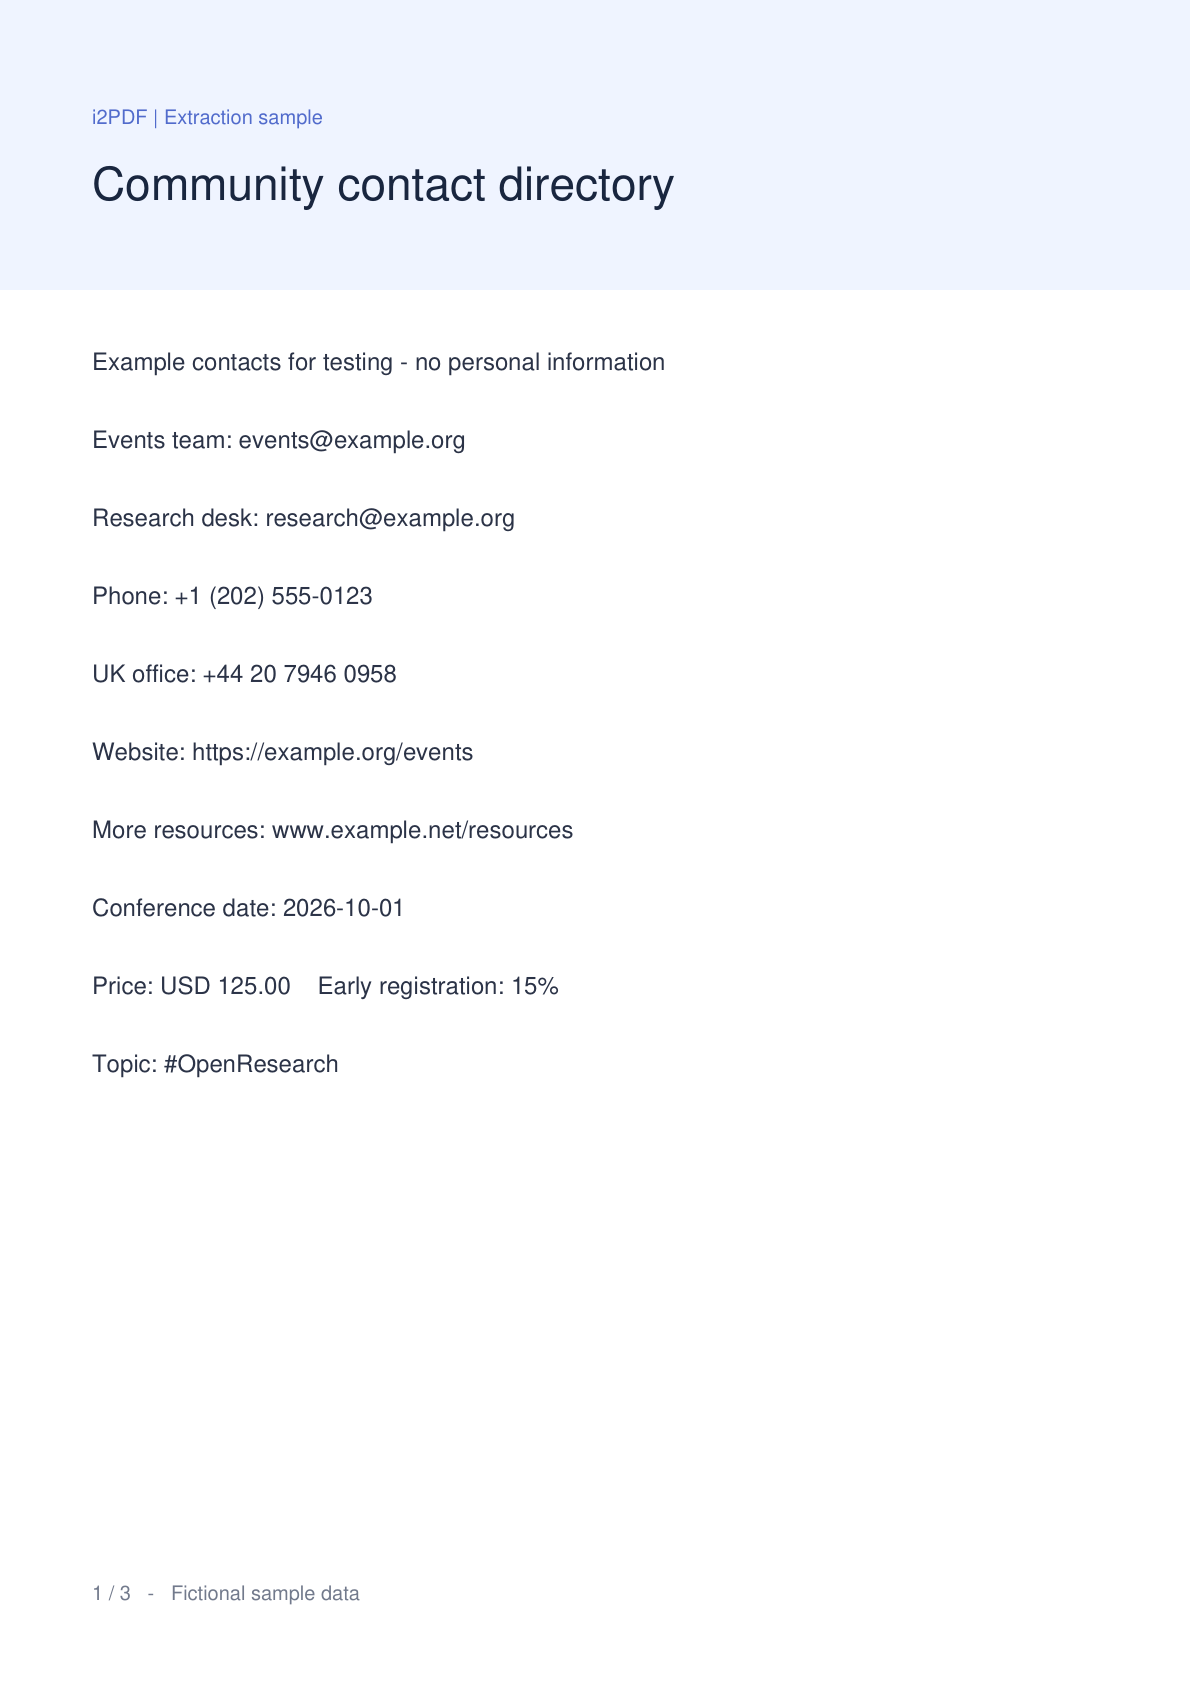
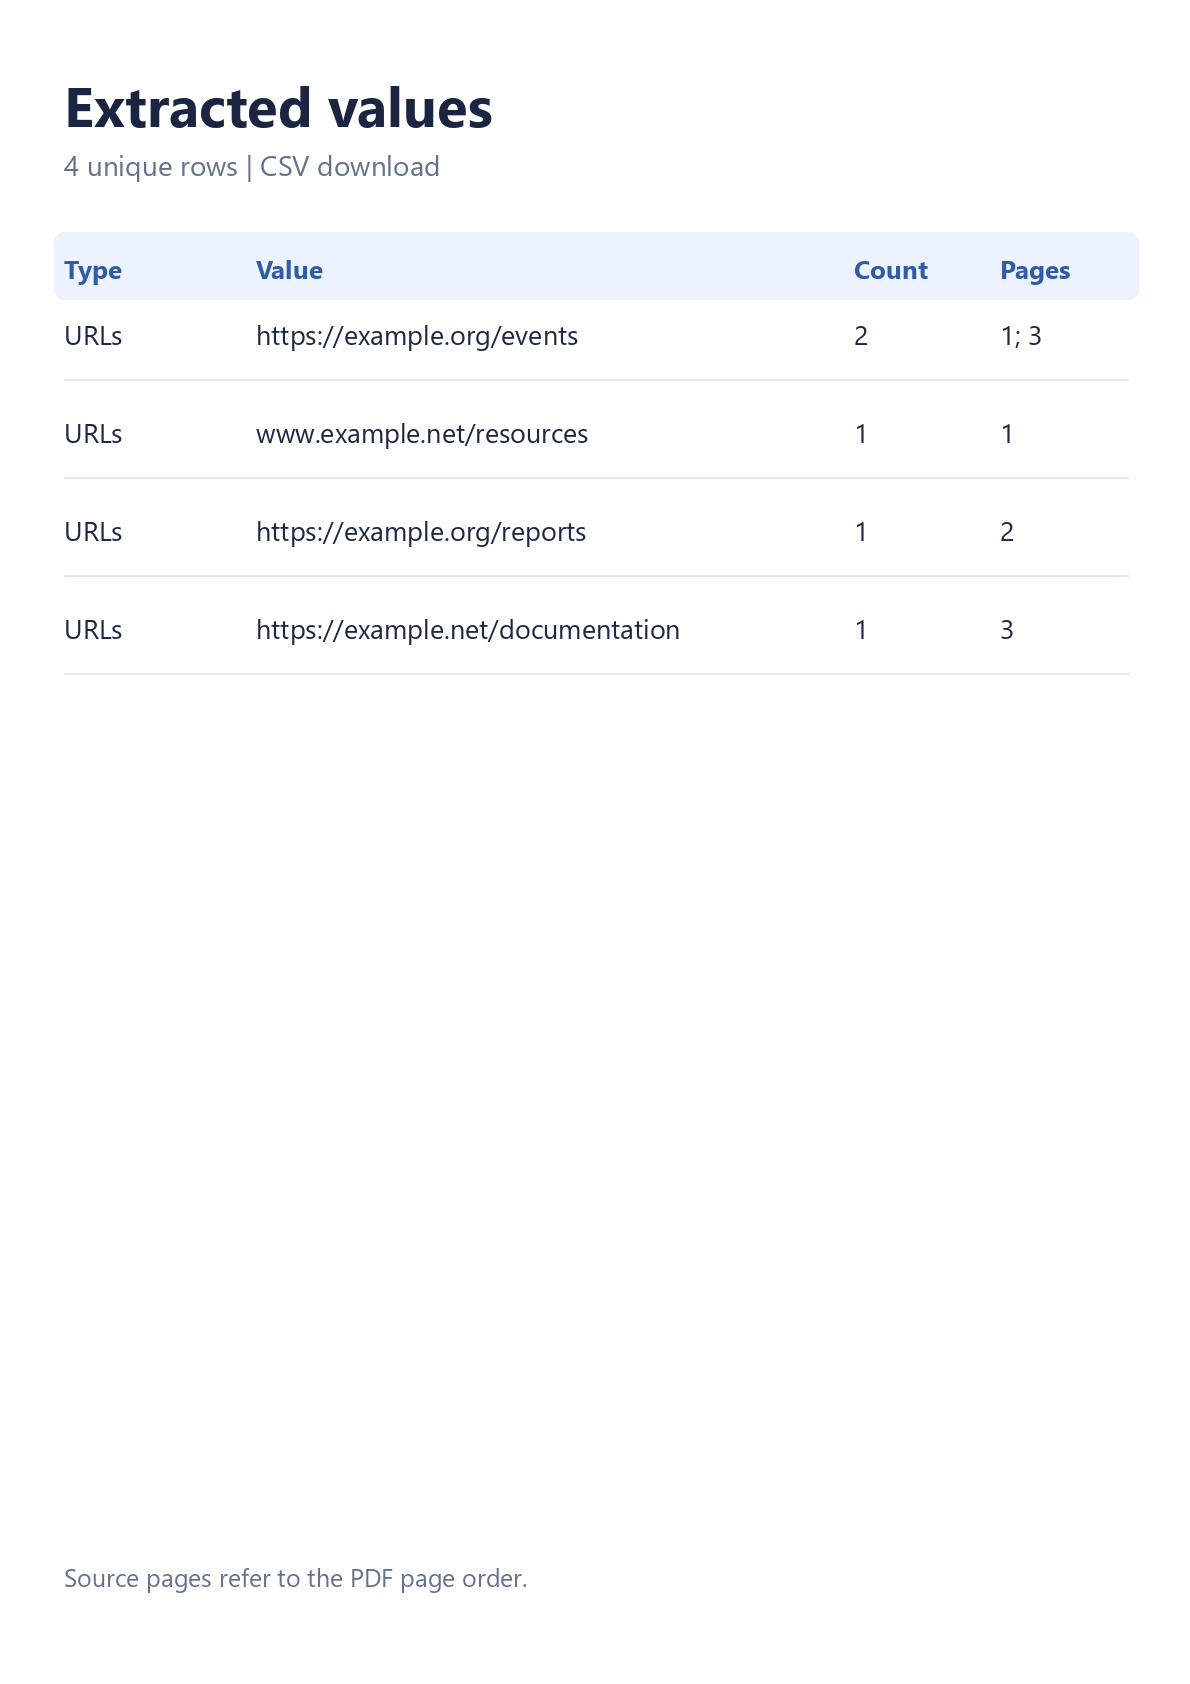

Öppna Extrahera länkar från PDF för att samla värden från en PDF utan att kopiera dem rad för rad. Jämförelsen använder det verkliga exempeldokumentet och en CSV nedladdad från verktyget. Tresidexemplet genererar 4 unika webbadresser från 5 förekomster.
Öppna din PDF
Ladda upp en PDF, eller välj Prova exempel för att följa detta exempel. PDF-förhandsgranskningen och sidminiatyrerna visas. Din originalfil förblir oförändrad och extraheringen körs i din webbläsare.
En textbaserad katalog, rapport, forskningsartikel eller broschyr är en användbar startpunkt. Bildbaserade skanningar behöver OCR innan deras tryckta text kan kännas igen.
Välj de användbara alternativen
På en telefon, öppna Inställningar. På dator, använd inställningspanelen bredvid förhandsgranskningen.
Behåll Ta bort dubbletter aktiverat för att gruppera upprepade mål. Välj CSV när du behöver sidreferenser, eller TXT för en enkel lista med webbadresser. Exemplet använder standardformatet CSV och källordning.
Extrahera och kontrollera matchningarna
Välj Extrahera. När bearbetningen är klar visar fliken Resultat värdena, antalet förekomster och källsidor. Välj ett cirkulärt sidnummer för att inspektera dess plats i PDF-förhandsgranskningen, återvänd sedan till Resultat.
Exemplet innehåller https://example.org/events två gånger och tre andra webbadresser. Det demonstrerar också en klickbar länk vars synliga etikett skiljer sig från dess mål. En tryckt webbadress och dess identiska klickbara mål på samma sida räknas inte två gånger.
Använd Filtrera resultat för att begränsa listan. Kopiering och nedladdning inkluderar alla matchande rader, även när resultattabellen sträcker sig över flera skärmar med rader.
Ladda ner CSV eller TXT
Välj Ladda ner CSV, använd sedan huvudknappen Ladda ner på skärmen för färdigställande. CSV innehåller kolumnerna Typ, Värde, Antal och Sidor. TXT och Kopiera alla innehåller ett värde per rad.
CSV-värden som kan tolkas som kalkylbladsformler skyddas med ett inledande apostrof. Till exempel börjar ett internationellt telefonnummer med ett plustecken. Använd TXT om du behöver en enkel lista utan kalkylbladsskydd.
Vanliga frågor
Kan detta hitta en länk bakom ord som "Läs mer"?
Ja, när dessa ord har en stödd HTTP- eller HTTPS-länkanmärkning i PDF-filen. Det exporterade värdet är dess webbdestination. En visuell understrykning i sig bevisar inte att en klickbar länk finns.
Vad ska jag göra med en skannad PDF?
Kör PDF-OCR först, ladda sedan den igenkända kopian i detta verktyg. Kontrollera OCR-utdata noggrant: ett felaktigt tecken kan ändra en adress eller identifierare.
Vilka är extraheringsgränserna?
Använd en PDF på upp till 50 MiB och 750 sidor. Extrahering är begränsad till totalt 20 000 matchningar och 2 000 per sida, med en bearbetningsbudget på 90 sekunder. Gränser för text och anteckningar gäller också. Om en gräns eller oläsbar sida avbryter skanningen visar verktyget ett meddelande om partiella resultat och markerar exportfilnamnet som partiellt.
Öppnas mina PDF-länkar automatiskt?
Nej. Extraheringen läser filen i webbläsaren och besöker inte extraherade destinationer. Sidknappar navigerar inom PDF-förhandsgranskningen.
Behåll värdena och deras sammanhang
Extrahera en fokuserad lista, kontrollera källsidorna och ladda ner det format som passar ditt nästa steg.


