

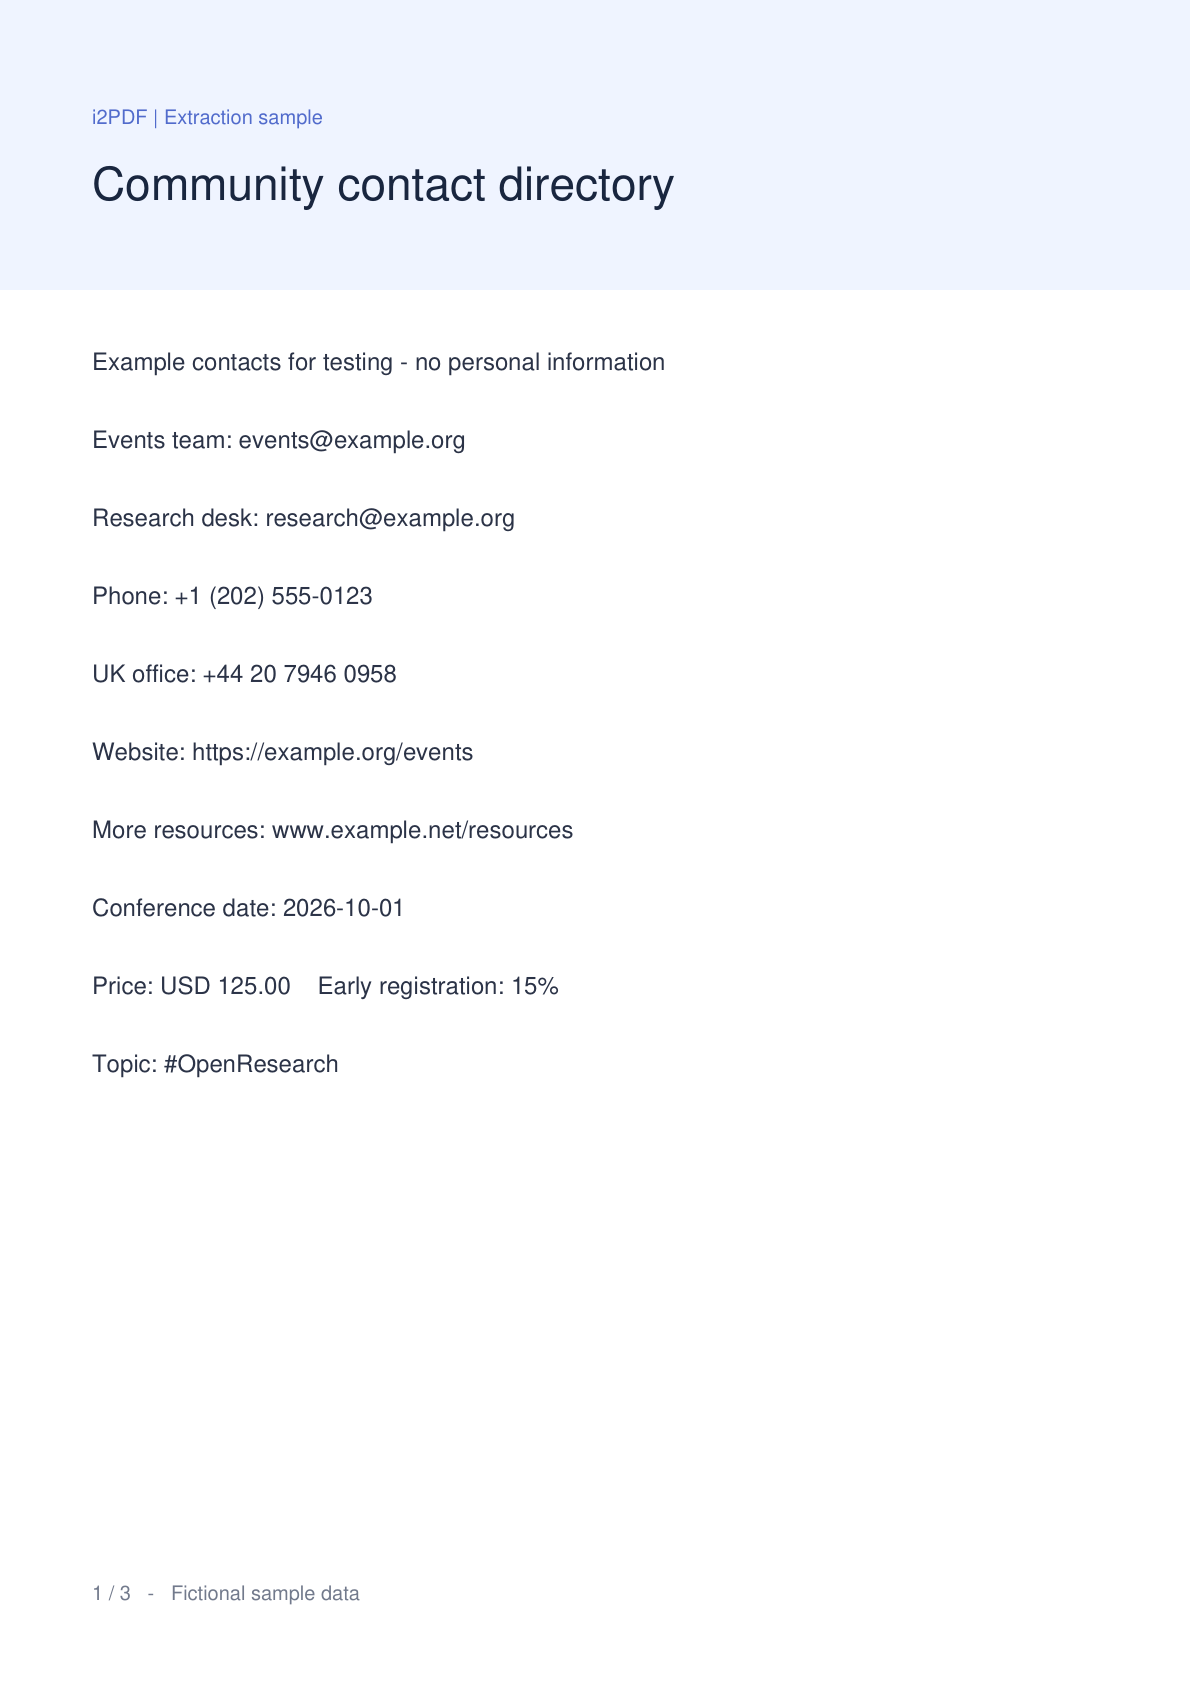
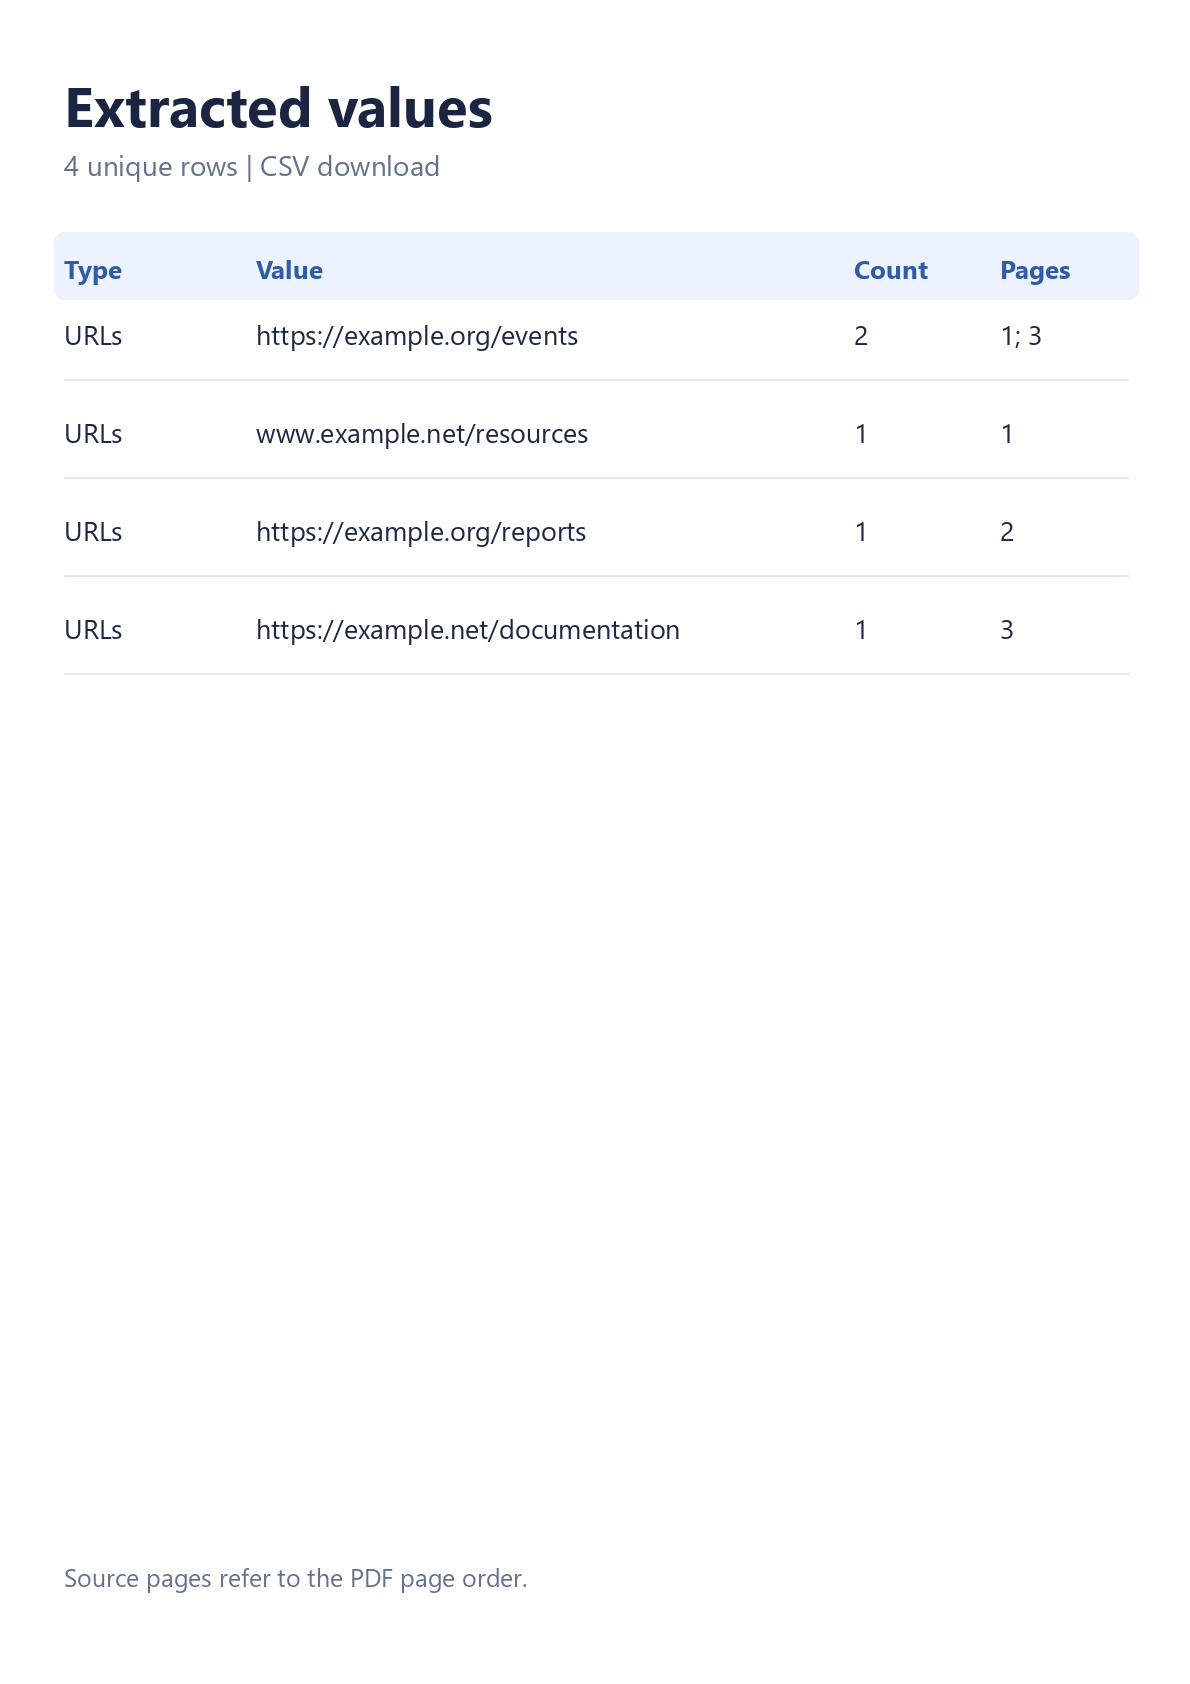

Öffnen Sie Links aus PDF extrahieren, um Werte aus einem PDF zu sammeln, ohne sie Zeile für Zeile kopieren zu müssen. Der Vergleich verwendet das echte Beispieldokument und eine vom Tool heruntergeladene CSV. Das dreiseitige Beispiel erzeugt 4 eindeutige Webadressen aus 5 Vorkommen.
Öffnen Sie Ihr PDF
Laden Sie ein PDF hoch oder wählen Sie Beispiel versuchen, um diesem Beispiel zu folgen. Die PDF-Vorschau und Seitenvorschaubilder erscheinen. Ihre Originaldatei bleibt unverändert und die Extraktion erfolgt in Ihrem Browser.
Ein textbasiertes Verzeichnis, ein Bericht, ein Forschungspapier oder eine Broschüre sind ein nützlicher Ausgangspunkt. Reine Bild-Scans benötigen eine OCR, bevor ihr gedruckter Text erkannt werden kann.
Wählen Sie die nützlichen Optionen
Öffnen Sie auf einem Telefon die Einstellungen. Verwenden Sie auf dem Desktop das Einstellungsfeld neben der Vorschau.
Lassen Sie Duplikate entfernen aktiviert, um wiederholte Ziele zu gruppieren. Wählen Sie CSV, wenn Sie Seitenreferenzen benötigen, oder TXT für eine einfache URL-Liste. Das Beispiel verwendet das Standard-CSV-Format und die Quellreihenfolge.
Extrahieren und prüfen Sie die Treffer
Wählen Sie Extrahieren. Wenn die Verarbeitung abgeschlossen ist, zeigt der Tab Ergebnisse die Werte, Vorkommenshäufigkeiten und Quellseiten an. Wählen Sie eine kreisförmige Seitenzahl, um deren Position in der PDF-Vorschau zu prüfen, und kehren Sie dann zu den Ergebnissen zurück.
Das Beispiel enthält https://example.org/events zweimal und drei weitere Webadressen. Es demonstriert auch einen anklickbaren Link, dessen sichtbares Label sich von seinem Ziel unterscheidet. Eine gedruckte URL und ihr identisches anklickbares Ziel auf derselben Seite werden nicht doppelt gezählt.
Verwenden Sie Ergebnisse filtern, um die Liste einzugrenzen. Kopieren und Herunterladen umfassen alle übereinstimmenden Zeilen, selbst wenn die Ergebnistabelle mehrere Bildschirme umfasst.
CSV oder TXT herunterladen
Wählen Sie CSV herunterladen und verwenden Sie dann die Hauptschaltfläche Herunterladen auf dem Bereitstellungsbildschirm. CSV enthält die Spalten Typ, Wert, Anzahl und Seiten. TXT und Alle kopieren enthalten einen Wert pro Zeile.
CSV-Werte, die als Tabellenkalkulationsformeln interpretiert werden könnten, werden mit einem führenden Apostroph geschützt. Zum Beispiel beginnt eine internationale Telefonnummer mit einem Pluszeichen. Verwenden Sie TXT, wenn Sie eine einfache Liste ohne Tabellenschutz benötigen.
Häufige Fragen
Kann dies einen Link hinter Wörtern wie „Mehr lesen“ finden?
Ja, wenn diese Wörter eine unterstützte HTTP- oder HTTPS-Link-Annotation im PDF haben. Der exportierte Wert ist das Webziel. Eine visuelle Unterstreichung allein beweist nicht, dass ein anklickbarer Link existiert.
Was soll ich mit einem gescannten PDF tun?
Führen Sie zuerst PDF-OCR aus und laden Sie dann die erkannte Kopie in dieses Tool. Prüfen Sie die OCR-Ausgabe sorgfältig: Ein falsches Zeichen kann eine Adresse oder Kennung verändern.
Was sind die Extraktionslimits?
Verwenden Sie ein PDF bis zu 50 MiB und 750 Seiten. Die Extraktion ist auf insgesamt 20.000 Treffer und 2.000 pro Seite begrenzt, mit einem Verarbeitungsbudget von 90 Sekunden. Text- und Annotationslimits gelten ebenfalls. Wenn ein Limit oder eine unlesbare Seite den Scan unterbricht, zeigt das Tool einen Hinweis auf Teilergebnisse und markiert den Export-Dateinamen als partiell.
Werden meine PDF-Links automatisch geöffnet?
Nein. Die Extraktion liest die Datei im Browser und besucht keine extrahierten Ziele. Seitenschaltflächen navigieren innerhalb der PDF-Vorschau.
Behalten Sie die Werte und ihren Kontext
Extrahieren Sie eine fokussierte Liste, prüfen Sie die Quellseiten und laden Sie das Format herunter, das zu Ihrem nächsten Schritt passt.


