

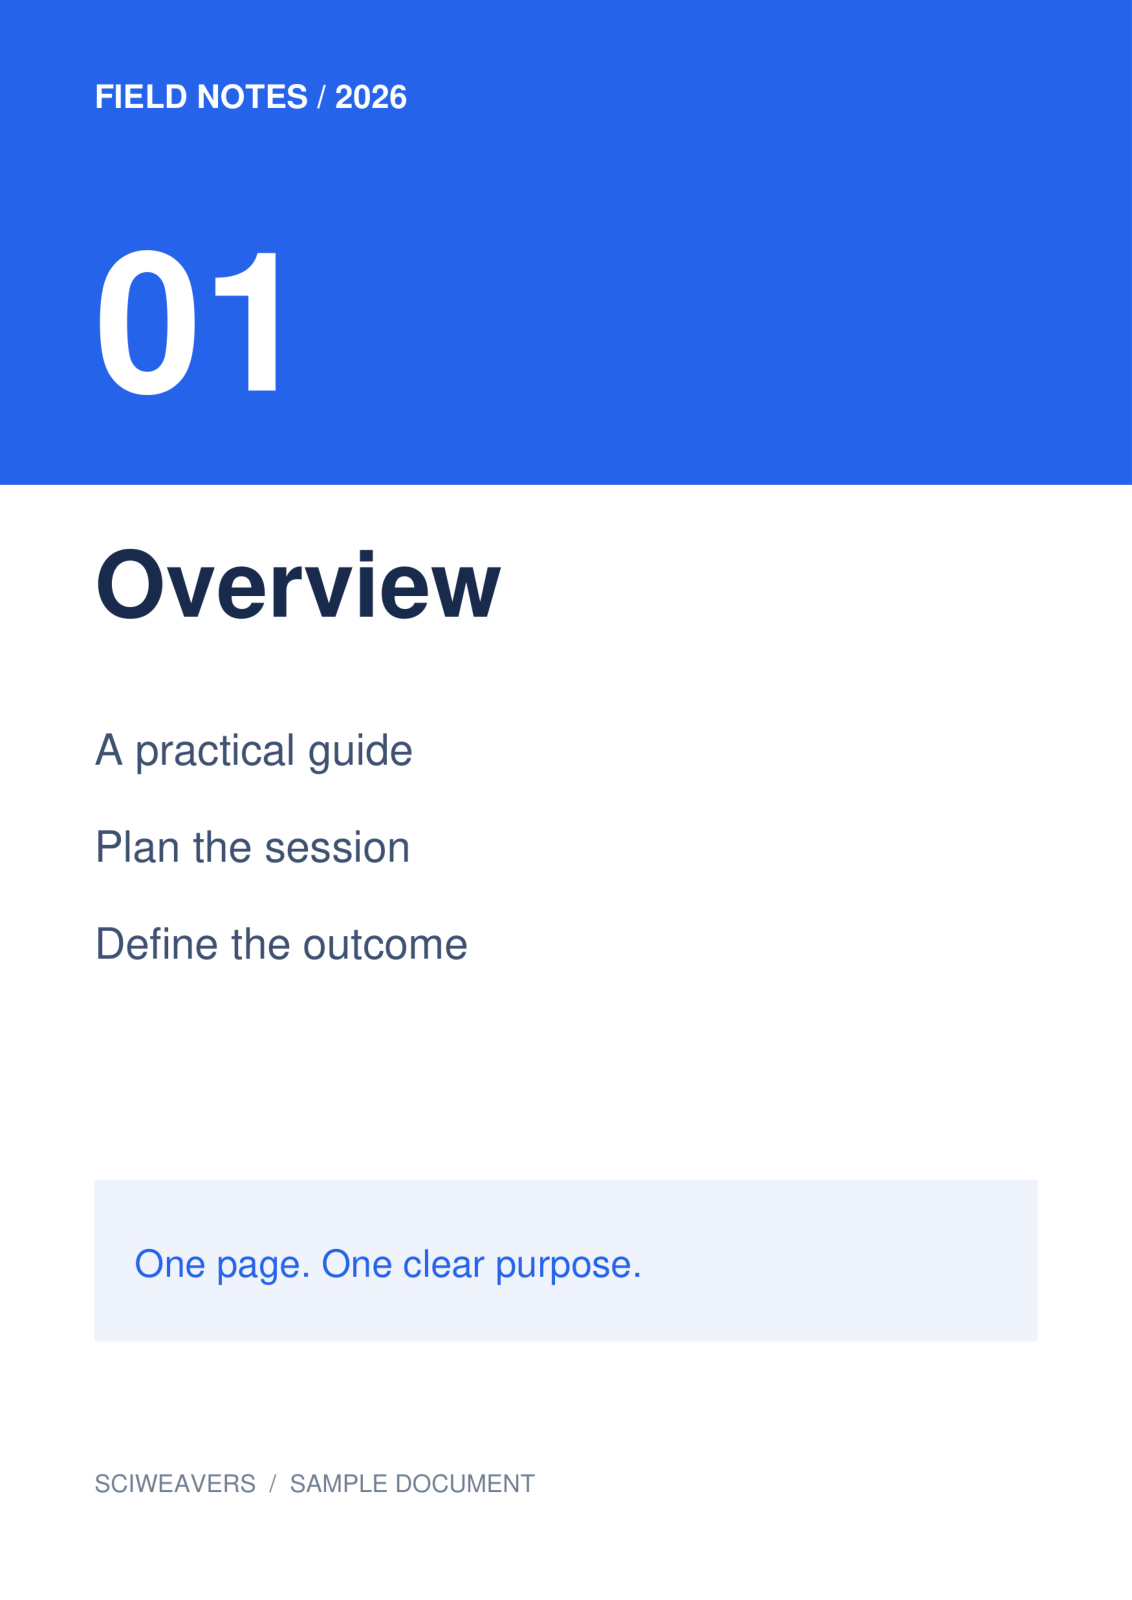
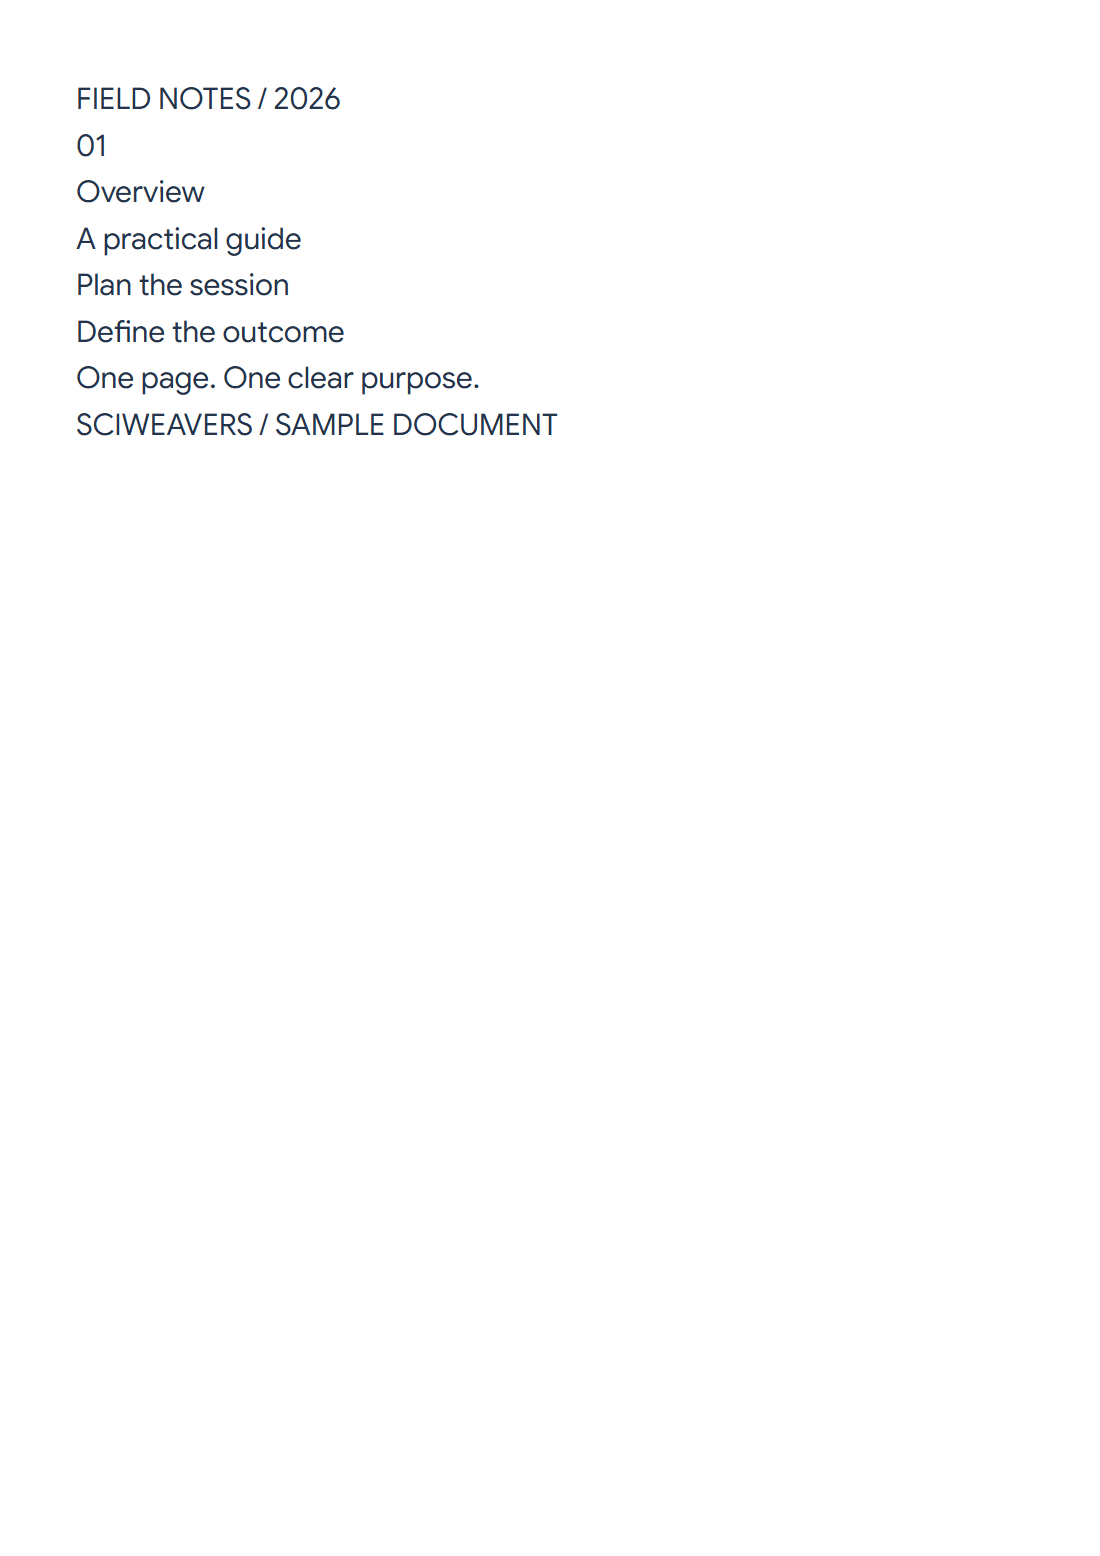

Utilisez PDF OCR pour reconnaître les mots à partir d'images de pages. Notre exemple commence par une numérisation de quatre pages contenant uniquement des images et reconnaît sa première page, Overview, en texte modifiable.
Choisir une page ou une zone
Chargez le PDF et accédez à la page dont vous avez besoin. Utilisez la page entière ou ajustez un rectangle de sélection autour du texte nécessaire. L'exemple utilise la totalité de la page 1.
Une autre page ou zone nécessite une action de reconnaissance distincte. L'outil ne traite pas automatiquement chaque page du PDF téléchargé.
Pour une numérisation peu lisible ou marquée, choisissez Améliorer l'image au-dessus de l'aperçu de la page. Ajustez la luminosité, le contraste ou le nettoyage de l'arrière-plan ; utilisez la gomme ou dessinez un rectangle pour effacer les marques indésirables. Comparez Original et Amélioré, puis choisissez Appliquer les modifications. Les modifications s'appliquent à la page actuelle. Vérifiez la sélection avant de lancer OCR.
Choisir la langue, le moteur et le format
Choisissez la langue imprimée sur la page. Pour notre exemple en anglais, conservez Future comme moteur OCR et choisissez Texte modifiable (.txt).
Choisissez Classic lorsque vous avez besoin de son PDF interrogeable, qui conserve l'image source avec une couche de texte reconnu invisible. Future fournit du texte modifiable, Word et un PDF uniquement texte réorganisé.
Reconnaître, corriger et télécharger
Choisissez Start et complétez la case de vérification affichée. Comparez le résultat reconnu avec l'image source. Notre téléchargement inclut correctement Overview, Plan the session et Define the outcome.
Corrigez les noms, les chiffres et les mots incertains avant de copier ou de télécharger le texte. Les corrections mettent à jour les exportations modifiables ; le PDF interrogeable positionné de Classic conserve la reconnaissance originale, donc révisez ce fichier séparément.
Affiner le texte reconnu avec Smart edit
Pour un résultat TXT ou Word, choisissez Smart edit à côté de Copy. Sélectionnez un passage pour travailler sur ce texte, ou ne laissez rien sélectionné pour utiliser l'ensemble du brouillon. Choisissez Summarize text, Paraphrase text, Fix grammar ou Suggest a title, puis choisissez Apply. L'action de titre ajoute un en-tête au-dessus du texte.
Vérifiez chaque modification IA par rapport à la numérisation, en particulier les noms, les chiffres et les mots manquants. La suggestion reste dans Édition intelligente jusqu'à ce que vous choisissiez Appliquer les modifications. Les téléchargements TXT et Word utilisent ensuite le texte brut modifié. Édition intelligente télécharge Word (.docx) par défaut ; choisissez PDF ou HTML pour une autre copie formatée. La numérisation originale et la couche de texte PDF interrogeable Classique ne changent pas.
Questions courantes
Puis-je reconnaître un seul paragraphe ?
Oui. Sélectionnez un rectangle autour avant de commencer. Vérifiez les bords afin que le texte à proximité soit exclu et que les mots importants ne soient pas coupés.
Future conservera-t-il la mise en page originale dans son PDF ?
Son PDF est un document uniquement texte réorganisé. Choisissez le PDF interrogeable de Classic lorsque l'objectif est de conserver l'image de la page numérisée avec une couche de texte.
Smart edit peut-il modifier le PDF interrogeable ?
Non. Smart edit est disponible avec les résultats TXT et Word. Apply Changes met à jour le texte modifiable ; il ne réécrit pas la page numérisée ou un PDF interrogeable précédemment généré.
Essayez avec votre document
Révisez le résultat, puis enregistrez la version dont vous avez besoin.


