

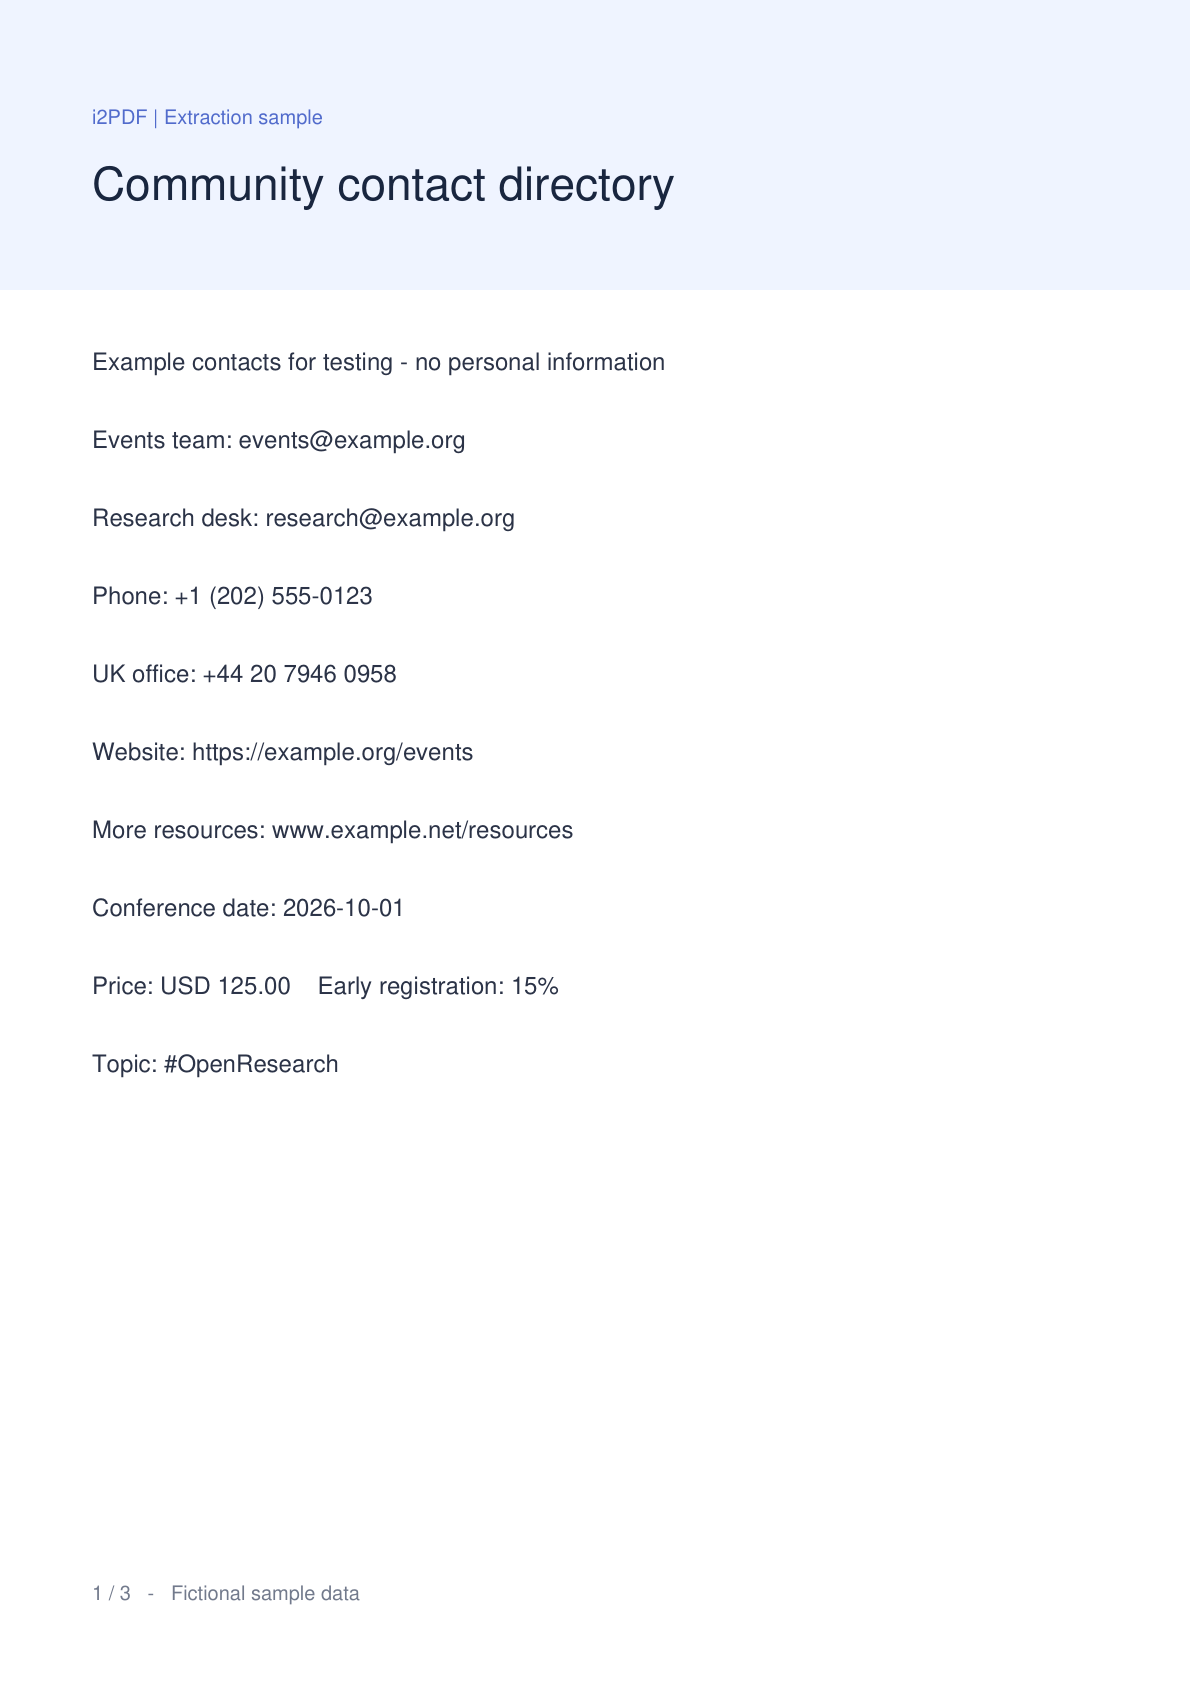
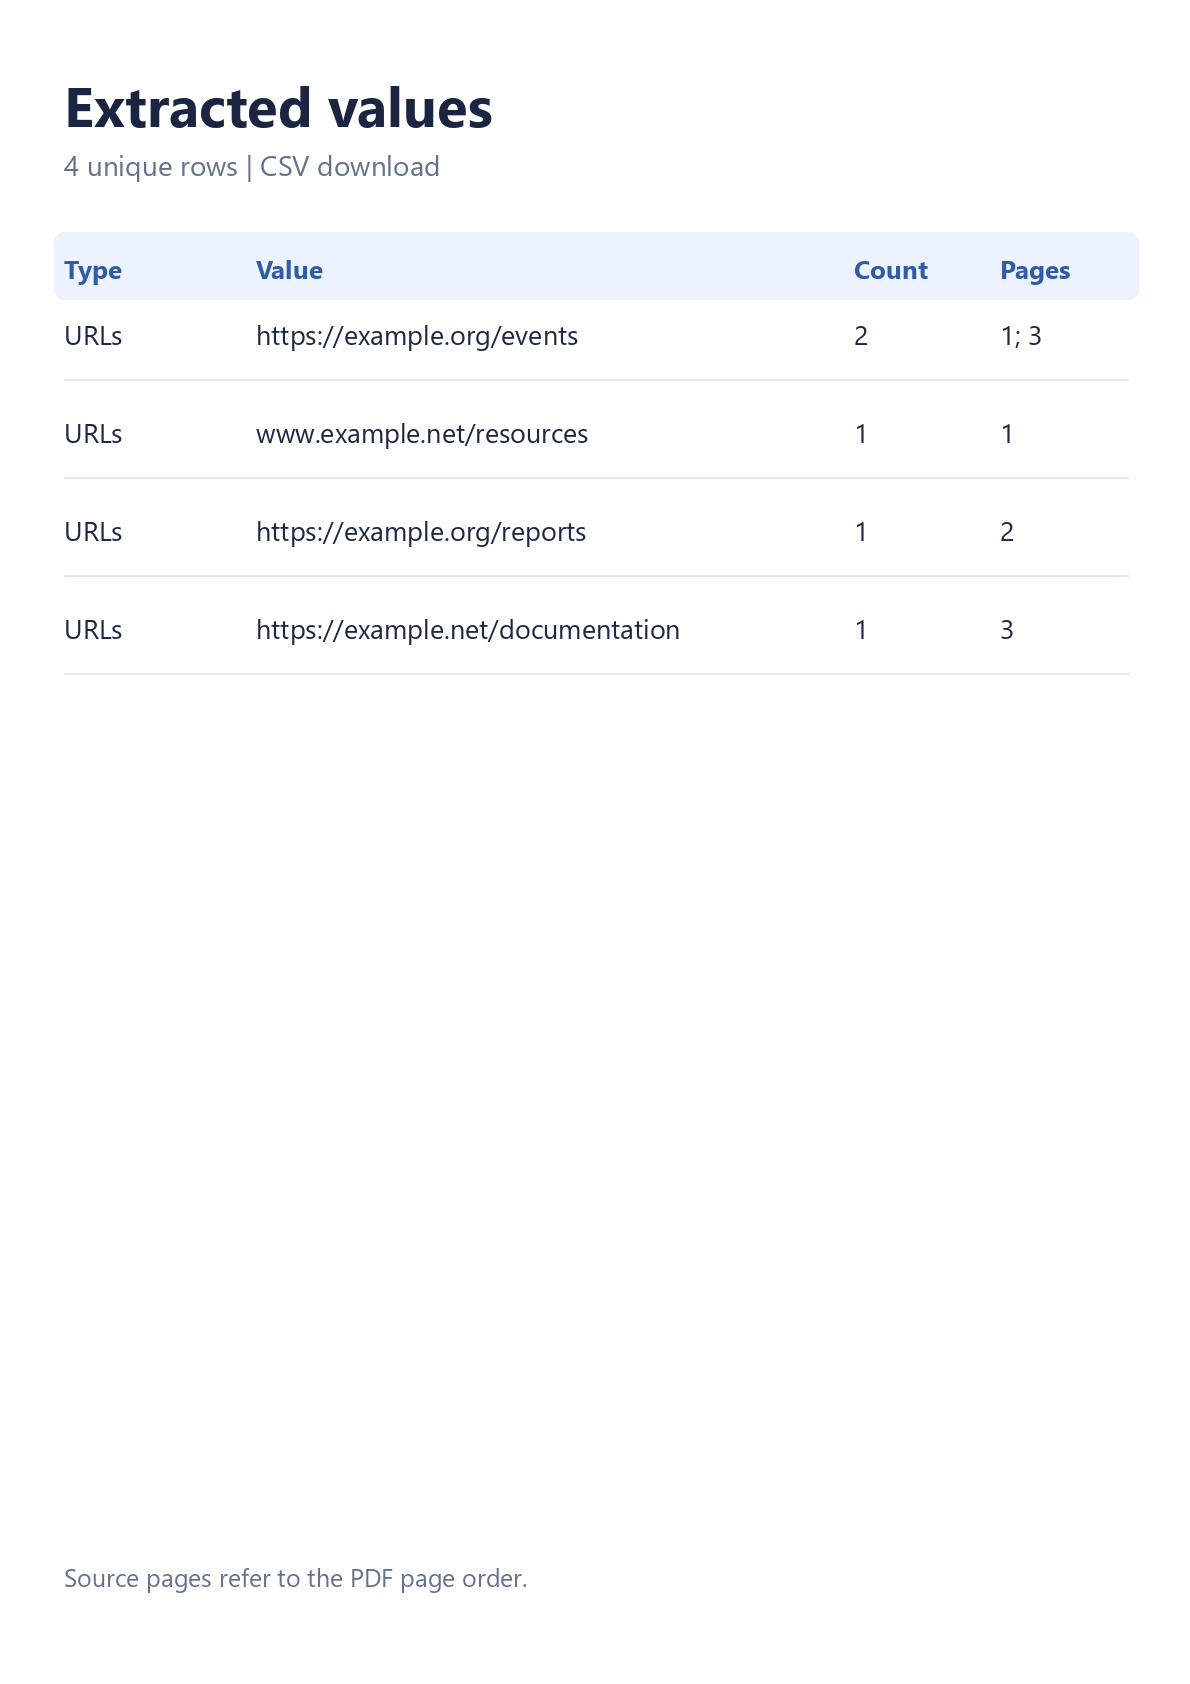

PDF से लिंक निकालें खोलें ताकि एक-एक करके कॉपी किए बिना एक PDF से मान एकत्र किए जा सकें। तुलना वास्तविक नमूना दस्तावेज़ और टूल से डाउनलोड की गई CSV का उपयोग करती है। तीन-पृष्ठ का नमूना 5 घटनाओं से 4 अद्वितीय वेब पते तैयार करता है।
अपनी PDF खोलें
एक PDF अपलोड करें, या इस उदाहरण का पालन करने के लिए नमूना आज़माएं चुनें। PDF पूर्वावलोकन और पृष्ठ थंबनेल दिखाई देते हैं। आपकी मूल फ़ाइल अपरिवर्तित रहती है, और एक्सट्रैक्शन आपके ब्राउज़र में चलता है।
टेक्स्ट-आधारित निर्देशिका, रिपोर्ट, शोध पत्र या ब्रोशर एक उपयोगी शुरुआती बिंदु है। केवल-छवि स्कैन को उनके मुद्रित टेक्स्ट को पहचानने से पहले OCR की आवश्यकता होती है।
उपयोगी विकल्प चुनें
फ़ोन पर, सेटिंग्स खोलें। डेस्कटॉप पर, पूर्वावलोकन के बगल में सेटिंग्स पैनल का उपयोग करें।
दोहराए गए लक्ष्यों को समूहित करने के लिए डुप्लिकेट हटाएं को सक्षम रखें। जब आपको पृष्ठ संदर्भों की आवश्यकता हो तो CSV चुनें, या सादे URL सूची के लिए TXT चुनें। उदाहरण डिफ़ॉल्ट CSV प्रारूप और स्रोत क्रम का उपयोग करता है।
मिलान निकालें और जाँचें
चुनें एक्सट्रैक्ट करें। जब प्रोसेसिंग समाप्त हो जाती है, तो परिणाम टैब मान, घटना गणना और स्रोत पृष्ठ दिखाता है। PDF पूर्वावलोकन में इसके स्थान का निरीक्षण करने के लिए एक गोलाकार पृष्ठ संख्या चुनें, फिर परिणामों पर वापस लौटें।
नमूने में https://example.org/events दो बार और तीन अन्य वेब पते शामिल हैं। यह एक क्लिक करने योग्य लिंक को भी प्रदर्शित करता है जिसका दृश्य लेबल उसके लक्ष्य से भिन्न है। एक मुद्रित URL और उसी पृष्ठ पर उसका समान क्लिक करने योग्य लक्ष्य दो बार नहीं गिना जाता है।
सूची को सीमित करने के लिए परिणाम फ़िल्टर करें का उपयोग करें। कॉपी और डाउनलोड में सभी मिलान वाली पंक्तियाँ शामिल हैं, तब भी जब परिणाम तालिका कई स्क्रीन तक फैली हो।
CSV या TXT डाउनलोड करें
CSV डाउनलोड करें चुनें, फिर तैयार स्क्रीन पर मुख्य डाउनलोड बटन का उपयोग करें। CSV में प्रकार, मान, गणना और पृष्ठ कॉलम होते हैं। TXT और सभी कॉपी करें में प्रति पंक्ति एक मान होता है।
CSV मान जिन्हें स्प्रेडशीट फ़ार्मुलों के रूप में व्याख्यायित किया जा सकता है, उन्हें एक अग्रणी एपोस्ट्रोफी के साथ सुरक्षित किया जाता है। उदाहरण के लिए, एक अंतरराष्ट्रीय फ़ोन नंबर प्लस चिह्न से शुरू होता है। यदि आपको स्प्रेडशीट सुरक्षा के बिना एक सादी सूची की आवश्यकता है तो TXT का उपयोग करें।
सामान्य प्रश्न
क्या यह “और पढ़ें” जैसे शब्दों के पीछे का लिंक ढूंढ सकता है?
हाँ, जब उन शब्दों में PDF में एक समर्थित HTTP या HTTPS लिंक एनोटेशन होता है। निर्यात किया गया मान उसका वेब गंतव्य है। केवल एक दृश्य रेखांकन यह साबित नहीं करता है कि एक क्लिक करने योग्य लिंक मौजूद है।
मुझे स्कैन की गई PDF के साथ क्या करना चाहिए?
पहले PDF OCR चलाएं, फिर पहचानी गई प्रति को इस टूल में लोड करें। OCR आउटपुट की सावधानीपूर्वक जाँच करें: एक गलत वर्ण किसी पते या पहचानकर्ता को बदल सकता है।
एक्सट्रैक्शन सीमाएं क्या हैं?
50 MiB और 750 पृष्ठों तक की एक PDF का उपयोग करें। एक्सट्रैक्शन कुल मिलाकर 20,000 मिलान और प्रति पृष्ठ 2,000 तक सीमित है, जिसमें 90-सेकंड का प्रोसेसिंग बजट है। टेक्स्ट और एनोटेशन सीमाएं भी लागू होती हैं। यदि कोई सीमा या अपठनीय पृष्ठ स्कैन को बाधित करता है, तो टूल एक आंशिक-परिणाम सूचना दिखाता है और निर्यात फ़ाइल नाम को आंशिक के रूप में चिह्नित करता है।
क्या मेरे PDF लिंक स्वचालित रूप से खुल जाते हैं?
नहीं। एक्सट्रैक्शन ब्राउज़र में फ़ाइल को पढ़ता है और निकाले गए गंतव्यों पर नहीं जाता है। पृष्ठ बटन PDF पूर्वावलोकन के भीतर नेविगेट करते हैं।
मानों और उनके संदर्भ को रखें
एक केंद्रित सूची निकालें, स्रोत पृष्ठों की जाँच करें, और वह प्रारूप डाउनलोड करें जो आपके अगले चरण के लिए उपयुक्त हो।


