

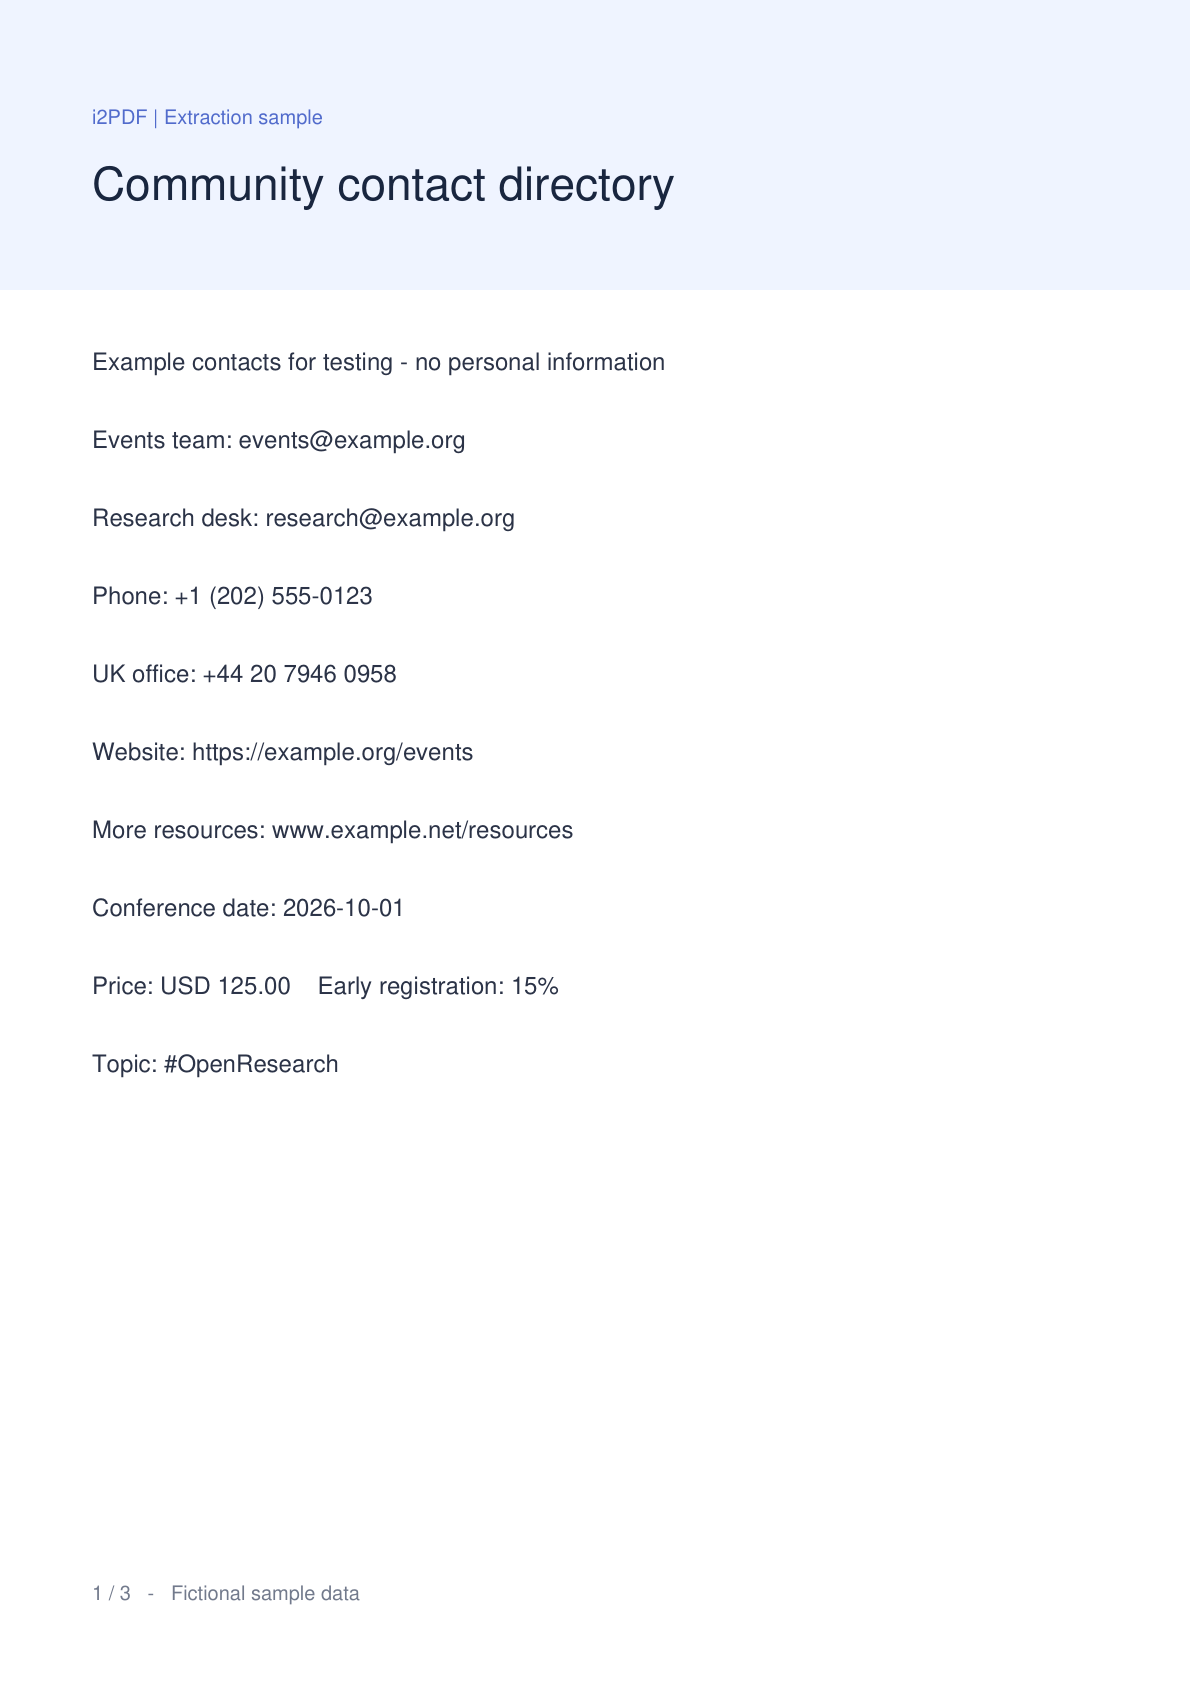
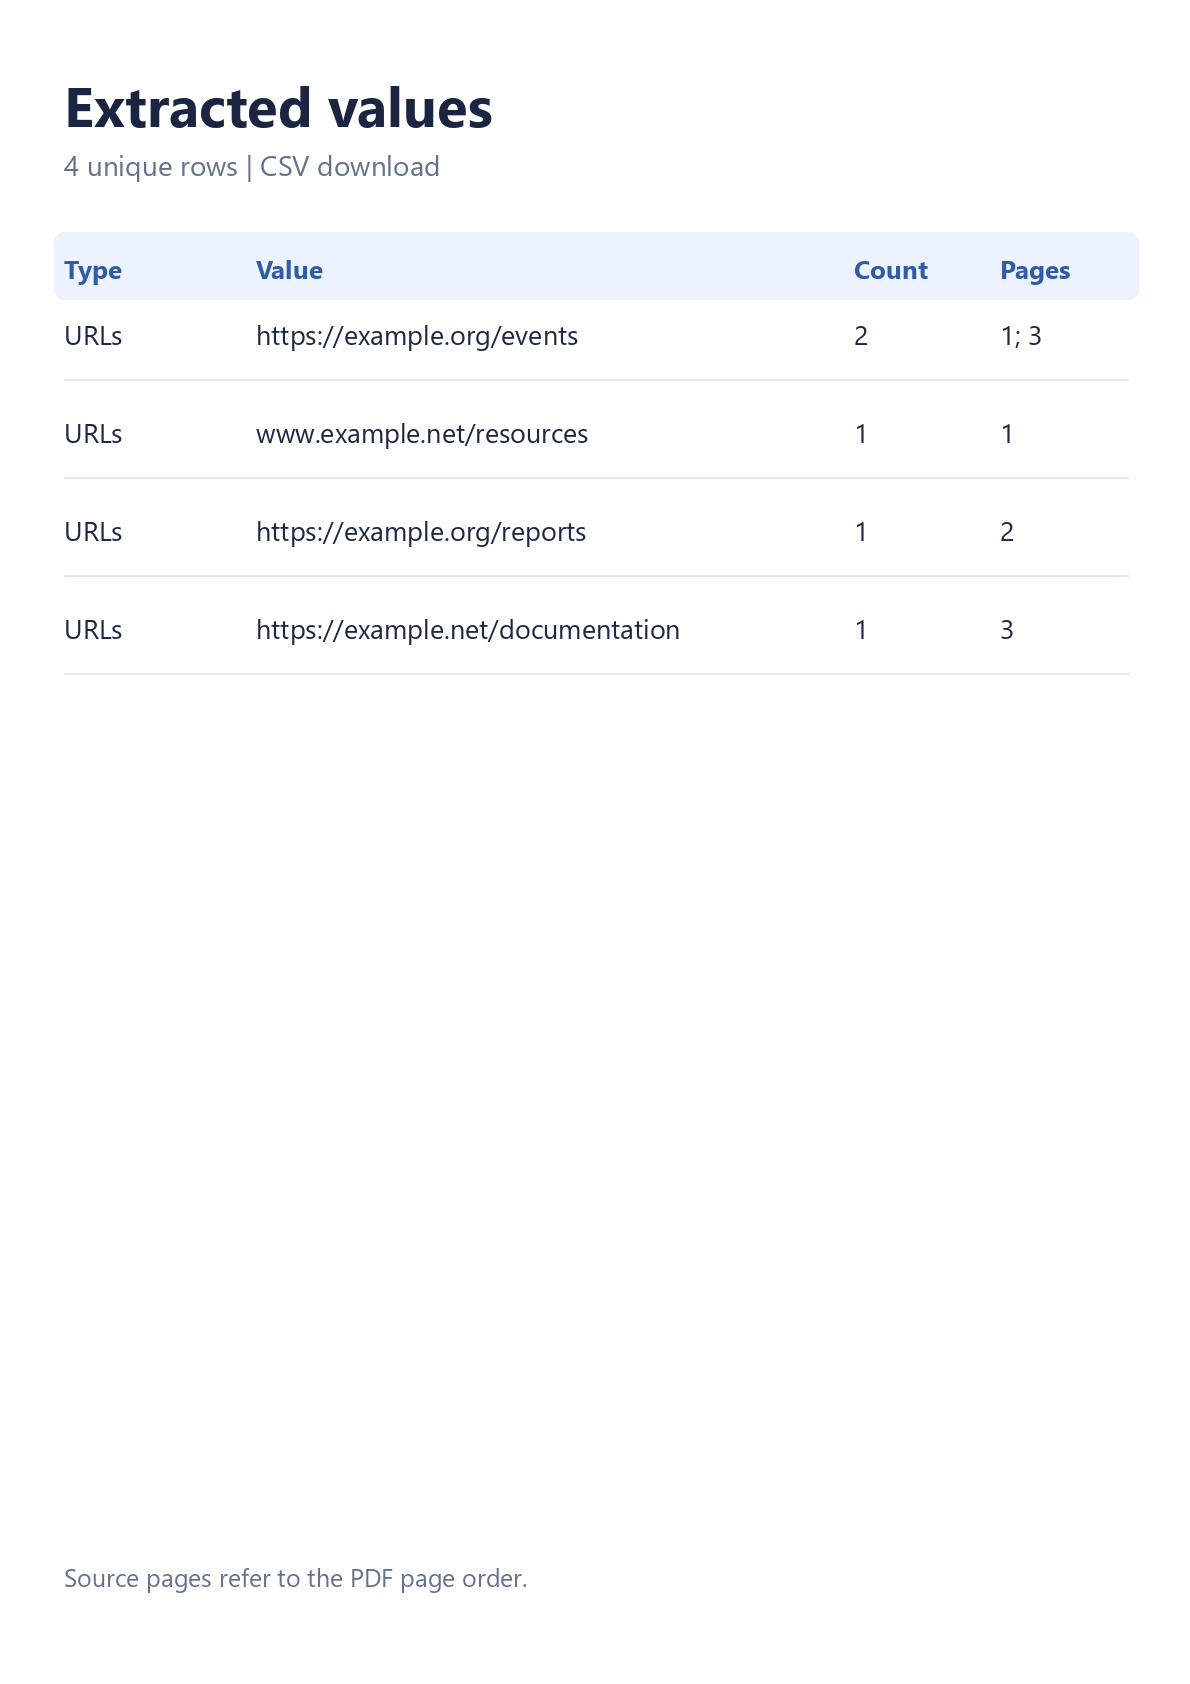

PDFからリンクを抽出を開き、1つずつコピーすることなくPDFから値を収集します。比較には実際のサンプルドキュメントと、ツールからダウンロードしたCSVを使用します。3ページのサンプルから、5 件の出現箇所に対し 4 件のユニークなWebアドレスが生成されます。
PDFを開く
PDFをアップロードするか、サンプルを試すを選択してこの例に従ってください。PDFプレビューとページのサムネイルが表示されます。元のファイルは変更されず、抽出はブラウザ内で実行されます。
テキストベースのディレクトリ、レポート、研究論文、パンフレットは、便利な出発点となります。画像のみのスキャンデータは、印刷されたテキストを認識するためにOCRが必要です。
便利なオプションを選択する
スマートフォンの場合は設定を開きます。デスクトップの場合は、プレビューの横にある設定パネルを使用します。
重複を削除を有効にして、繰り返されるターゲットをグループ化します。ページ参照が必要な場合はCSVを、単純なURLリストが必要な場合はTXTを選択します。この例では、デフォルトのCSV形式とソース順序を使用しています。
抽出して一致を確認する
抽出を選択します。処理が完了すると、結果タブに値、出現回数、ソースページが表示されます。円形のページ番号を選択してPDFプレビュー内の場所を確認し、結果に戻ります。
サンプルには https://example.org/events が2回と、その他3つのWebアドレスが含まれています。また、表示ラベルがターゲットと異なるクリック可能なリンクも示しています。同じページ上の印刷されたURLと同一のクリック可能なターゲットは、2回カウントされません。
結果をフィルタリングを使用してリストを絞り込みます。コピーやダウンロードには、結果テーブルが複数の画面にまたがる場合でも、一致するすべての行が含まれます。
CSVまたはTXTをダウンロードする
CSVをダウンロードを選択し、準備完了画面のメインのダウンロードボタンを使用します。CSVには「タイプ」、「値」、「件数」、「ページ」の列が含まれます。TXTとすべてコピーには、1行に1つの値が含まれます。
スプレッドシートの数式として解釈される可能性のあるCSV値は、先頭にアポストロフィを付けて保護されます。例えば、国際電話番号はプラス記号で始まります。スプレッドシート保護なしの単純なリストが必要な場合は、TXTを使用してください。
よくある質問
「続きを読む」などの単語の背後にあるリンクを見つけることはできますか?
はい、その単語にPDF内でサポートされているHTTPまたはHTTPSリンク注釈がある場合に可能です。エクスポートされる値はWeb上の宛先です。視覚的な下線だけでは、クリック可能なリンクが存在する証明にはなりません。
スキャンされたPDFはどうすればよいですか?
最初にPDF OCRを実行してから、認識されたコピーをこのツールに読み込んでください。OCRの出力を注意深く確認してください。文字の誤認識により、アドレスや識別子が変更される可能性があります。
抽出の制限は何ですか?
最大 50 MiB および 750 ページのPDFを1つ使用してください。抽出は全体で 20,000 件、ページあたり 2,000 件のマッチに制限され、90 秒の処理予算が設定されています。テキストおよび注釈の制限も適用されます。制限や読み取り不可能なページによってスキャンが中断された場合、ツールは部分的な結果の通知を表示し、エクスポートファイル名に「partial」とマークします。
PDFのリンクは自動的に開かれますか?
いいえ。抽出はブラウザ内でファイルを読み取るだけで、抽出された宛先にアクセスすることはありません。ページボタンはPDFプレビュー内を移動します。
値とそのコンテキストを保持する
焦点を絞ったリストを抽出し、ソースページを確認し、次のステップに適した形式をダウンロードします。


