

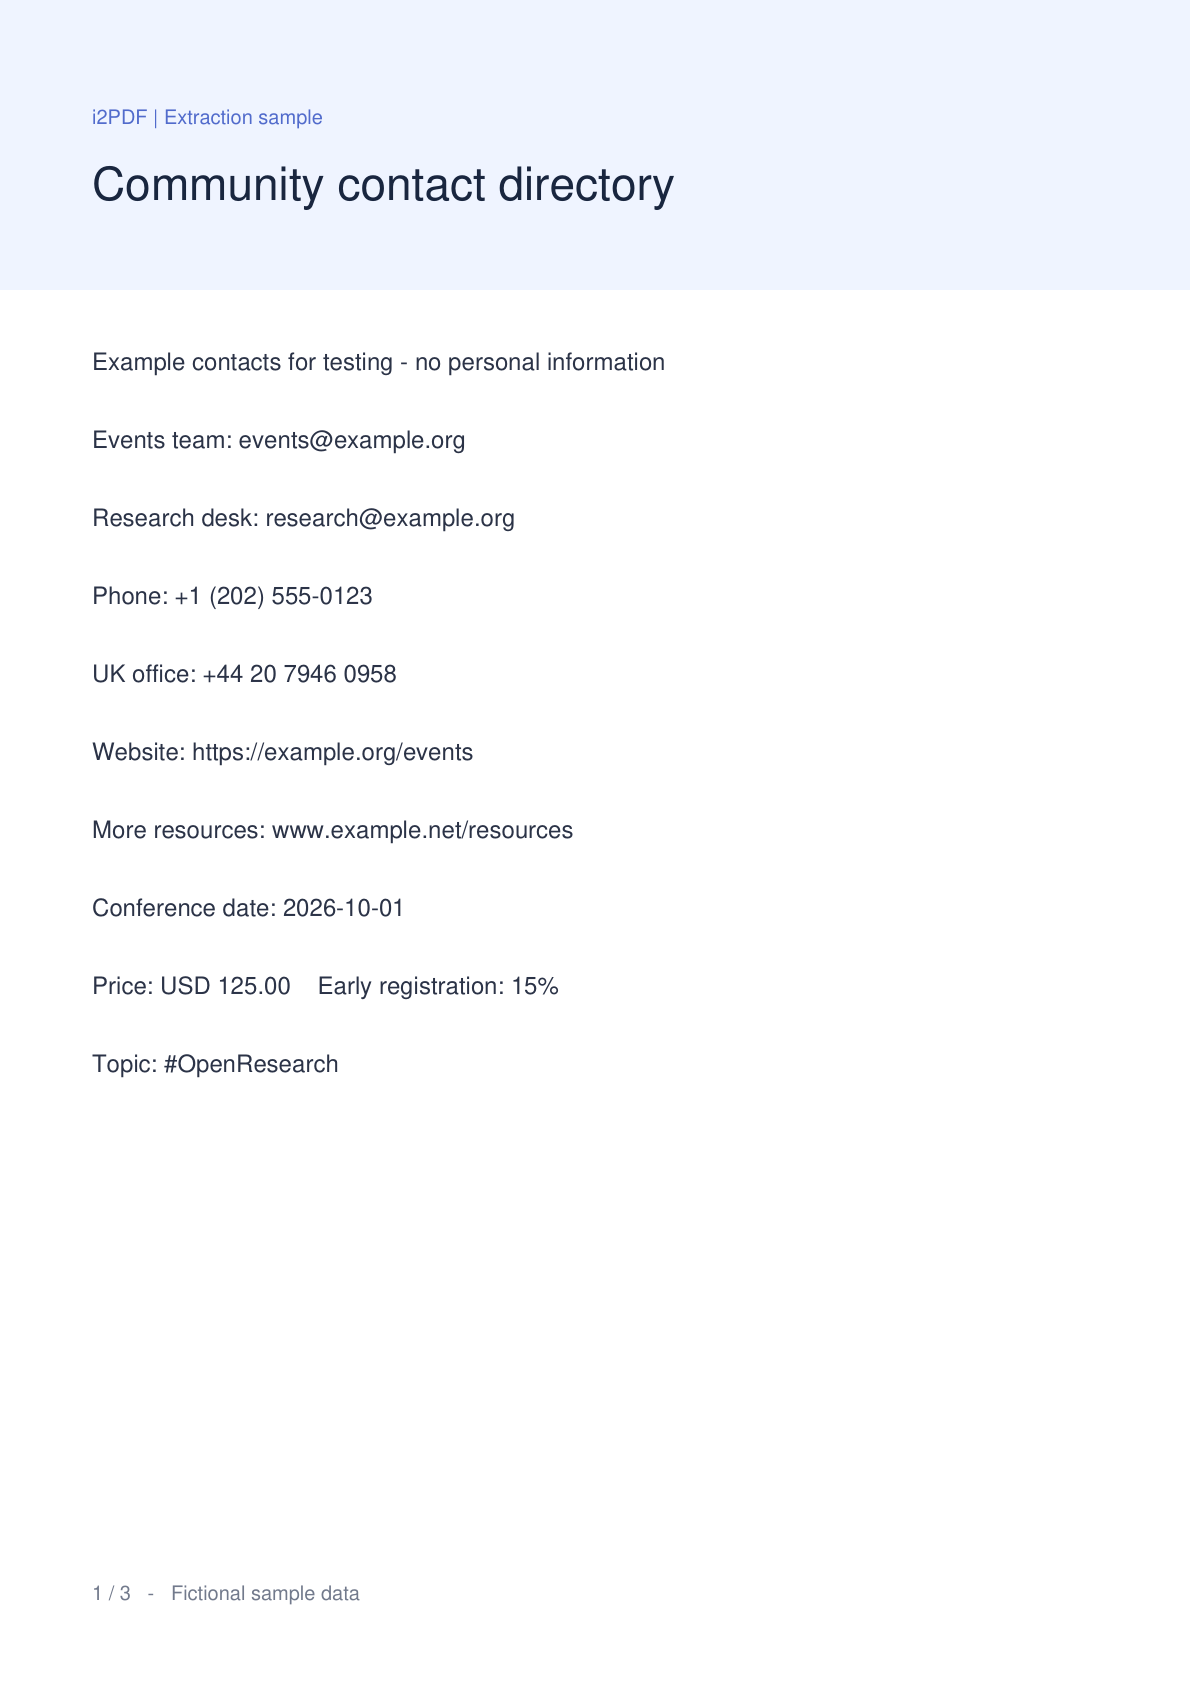
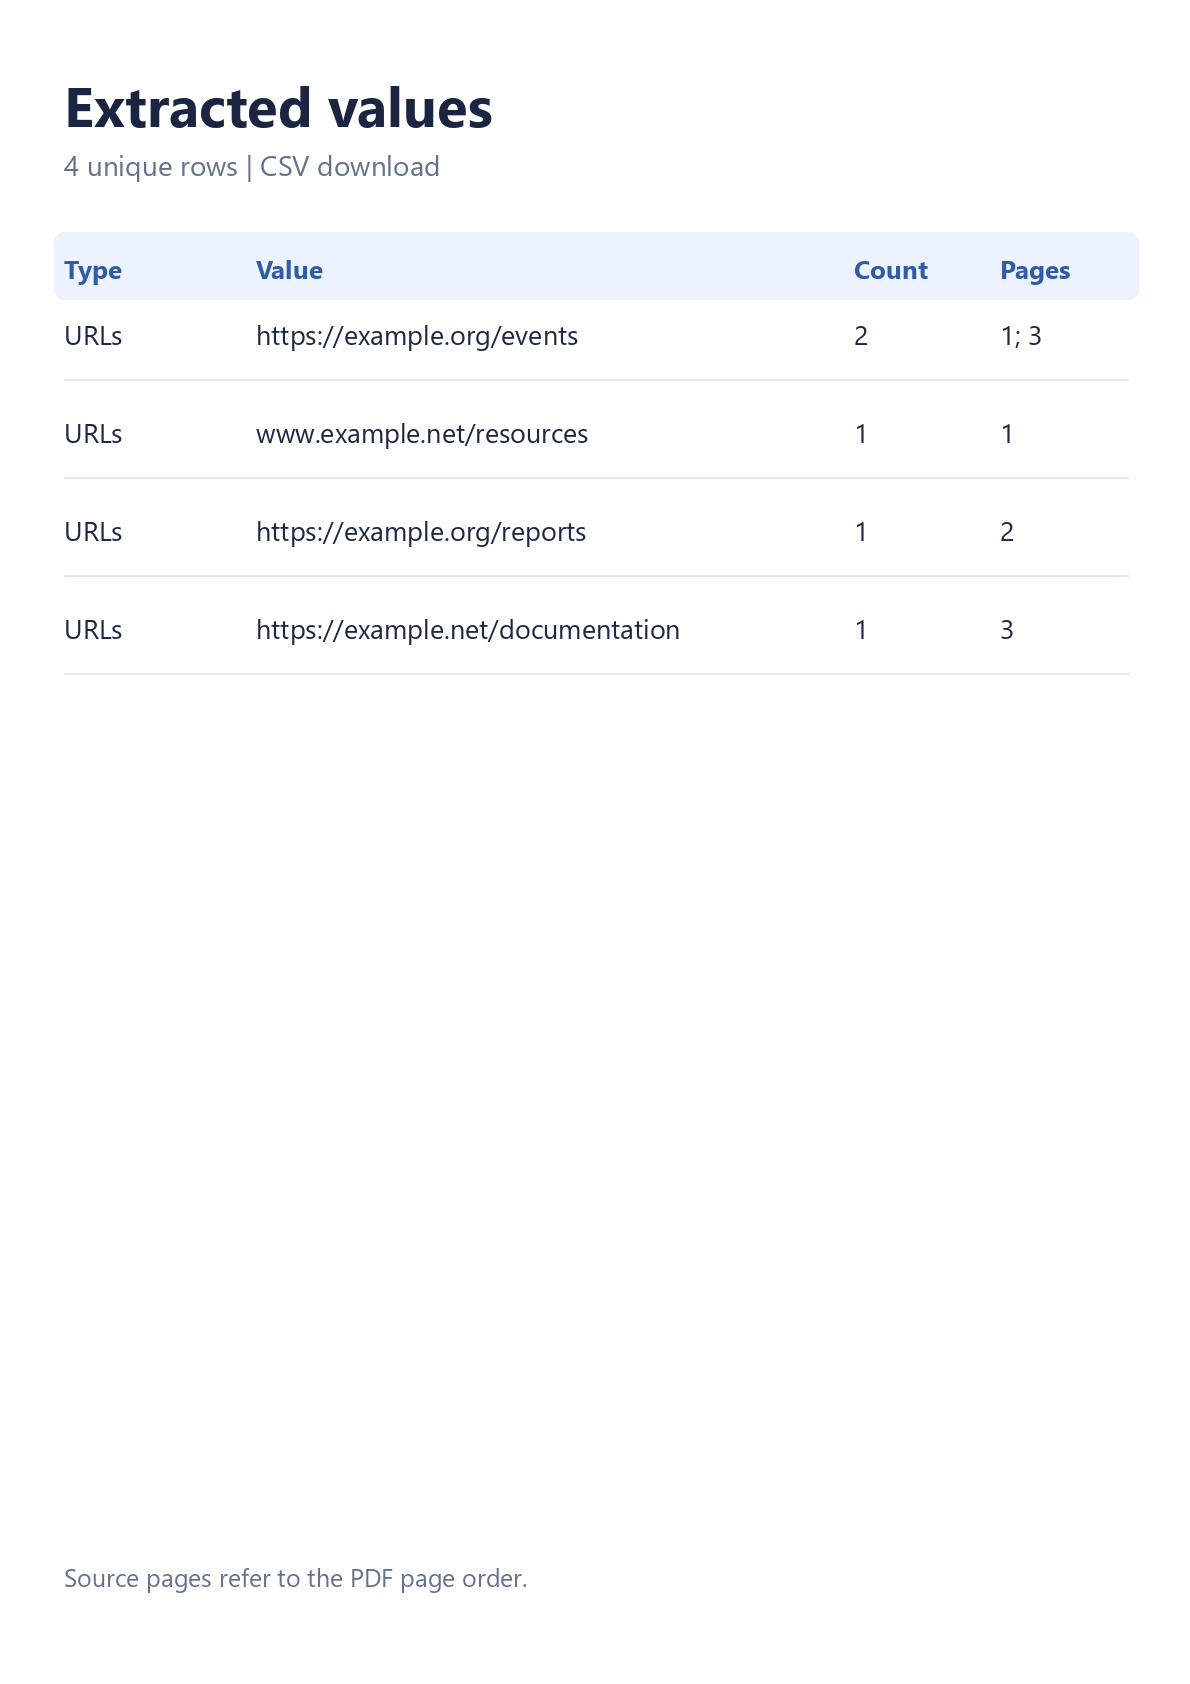

打开 从 PDF 中提取链接,无需逐行复制即可从一个 PDF 中收集值。该比较使用了真实的示例文件和从工具下载的 CSV。三页的示例从 5 次出现中生成了 4 个唯一的网址。
打开您的 PDF
上传一个 PDF,或选择 尝试示例以跟随此示例。PDF 预览和页面缩略图将会出现。您的原始文件保持不变,提取过程在您的浏览器中运行。
基于文本的目录、报告、研究论文或手册是一个有用的起点。仅包含图像的扫描件在识别其打印文本之前需要进行 OCR。
选择有用的选项
在手机上,打开 设置。在桌面上,使用预览旁边的设置面板。
保持 删除重复项启用以对重复的目标进行分组。当您需要页面引用时选择 CSV,或者选择 TXT 以获取纯网址列表。该示例使用默认的 CSV 格式和源顺序。
提取并检查匹配项
选择 提取。处理完成后,结果选项卡会显示值、出现次数和源页面。选择一个圆形的页码以在 PDF 预览中检查其位置,然后返回结果。
该示例包含两次 https://example.org/events 和其他三个网址。它还演示了一个可见标签与其目标不同的可点击链接。同一页面上的打印网址及其相同的可点击目标不会被计算两次。
使用 筛选结果来缩小列表范围。复制和下载包含所有匹配的行,即使结果表跨越多个屏幕的行。
下载 CSV 或 TXT
选择 下载 CSV,然后在就绪屏幕上使用主 下载按钮。CSV 包含类型、值、计数和页码列。TXT 和 全部复制包含每行一个值。
可能被解释为电子表格公式的 CSV 值会以撇号开头进行保护。例如,国际电话号码以加号开头。如果您需要没有电子表格保护的纯列表,请使用 TXT。
常见问题
这能找到“阅读更多”等词汇背后的链接吗?
是的,当这些词在 PDF 中具有支持的 HTTP 或 HTTPS 链接注释时。导出的值是其网络目标。仅视觉下划线并不能证明存在可点击的链接。
我应该如何处理扫描的 PDF?
先运行 PDF OCR,然后将识别出的副本加载到此工具中。仔细检查 OCR 输出:错误的字符可能会更改地址或标识符。
提取限制是什么?
使用一个最大 50 MiB 和 750 页的 PDF。提取总共限制为 20,000 个匹配项,每页 2,000 个,处理预算为 90 秒。文本和注释限制也适用。如果限制或不可读的页面中断了扫描,工具会显示部分结果通知并将导出文件名标记为部分。
我的 PDF 链接会自动打开吗?
不。提取过程在浏览器中读取文件,不会访问提取的目标。页面按钮在 PDF 预览内导航。
保留值及其上下文
提取一个重点列表,检查源页面,并下载适合您下一步的格式。


