
Откройте PDF в JSON, чтобы экспортировать записи страниц, текстовые блоки и данные чертежей. Наш четырехстраничный PDF создает document.json плюс одно связанное PNG-изображение внутри ZIP.
Выберите страницы PDF
Загрузите PDF и оставьте Страницы пустыми для всего документа или введите нужный диапазон. Наш пример включает все четыре страницы.
Экспортируйте и храните ресурсы вместе
Выберите Начать. Экспорт с изображениями загружается в виде ZIP. Распакуйте весь архив и храните каталог images рядом с document.json.
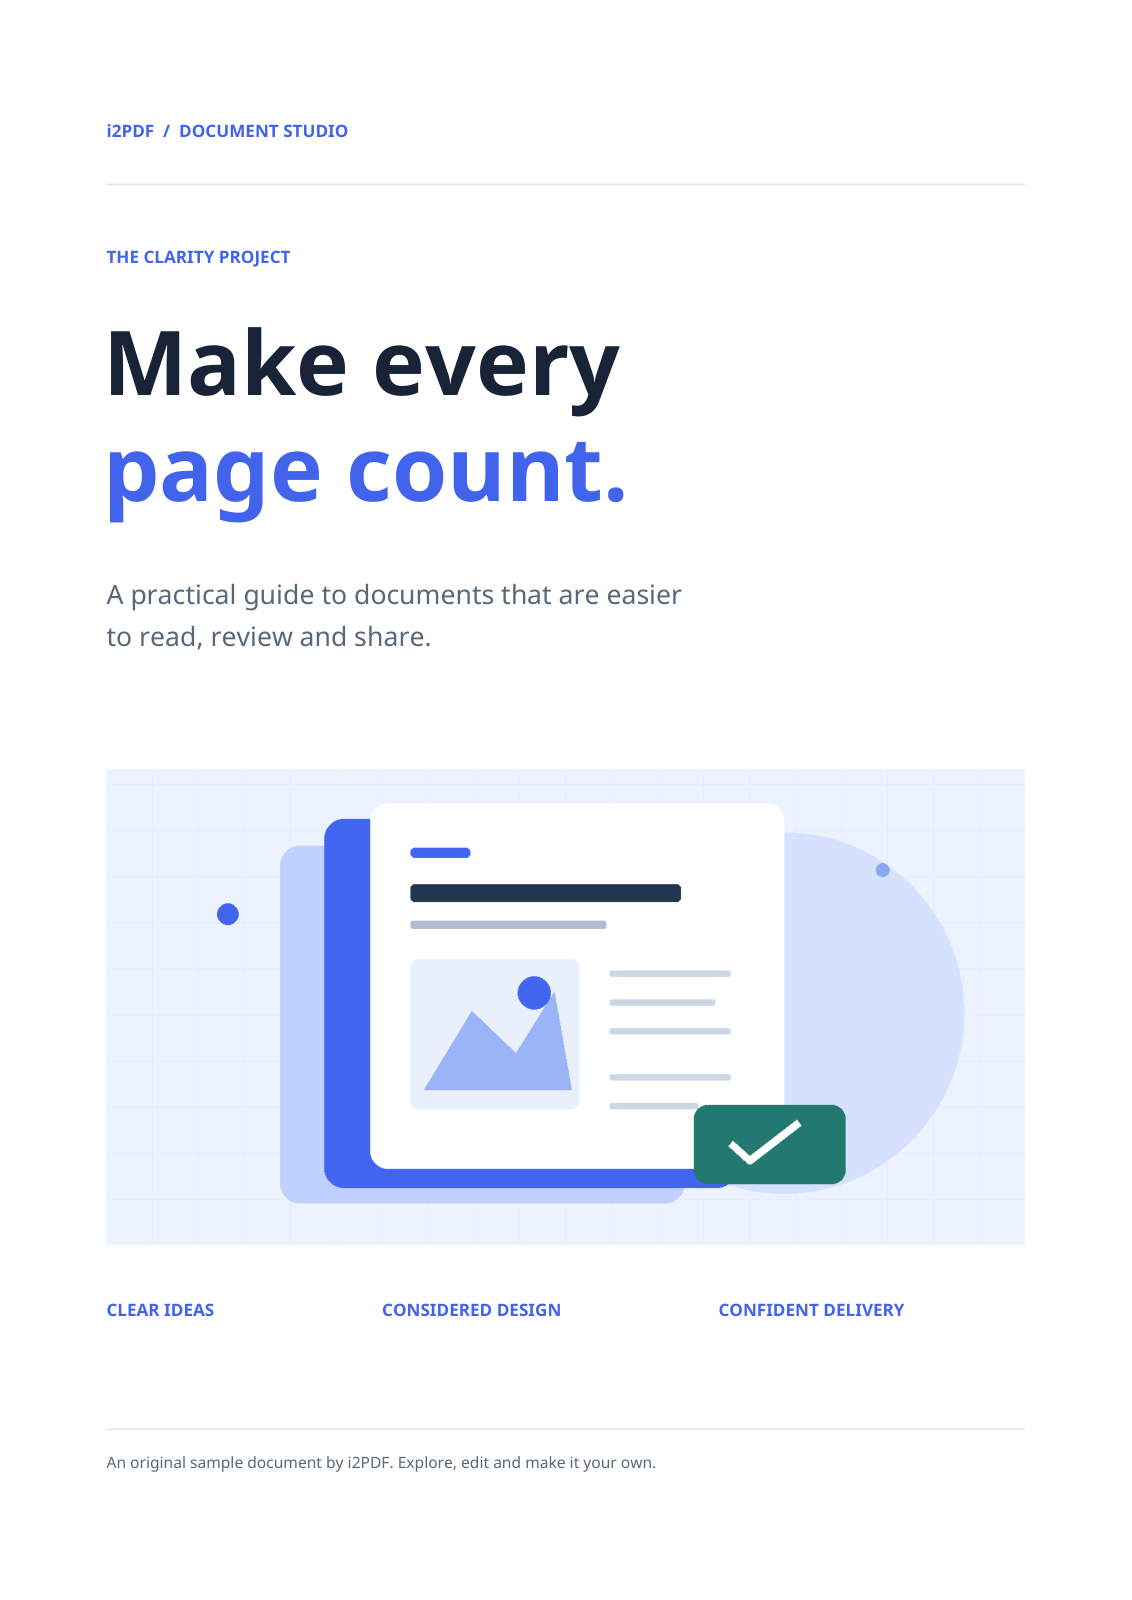
Пример включает images/page-001-image-005.png. Ссылки на изображения указывают на пути к ресурсам, а не встраивают бинарные данные в JSON. Экспорт без изображений можно скачать напрямую в формате .json.
Прочитайте структуру документа
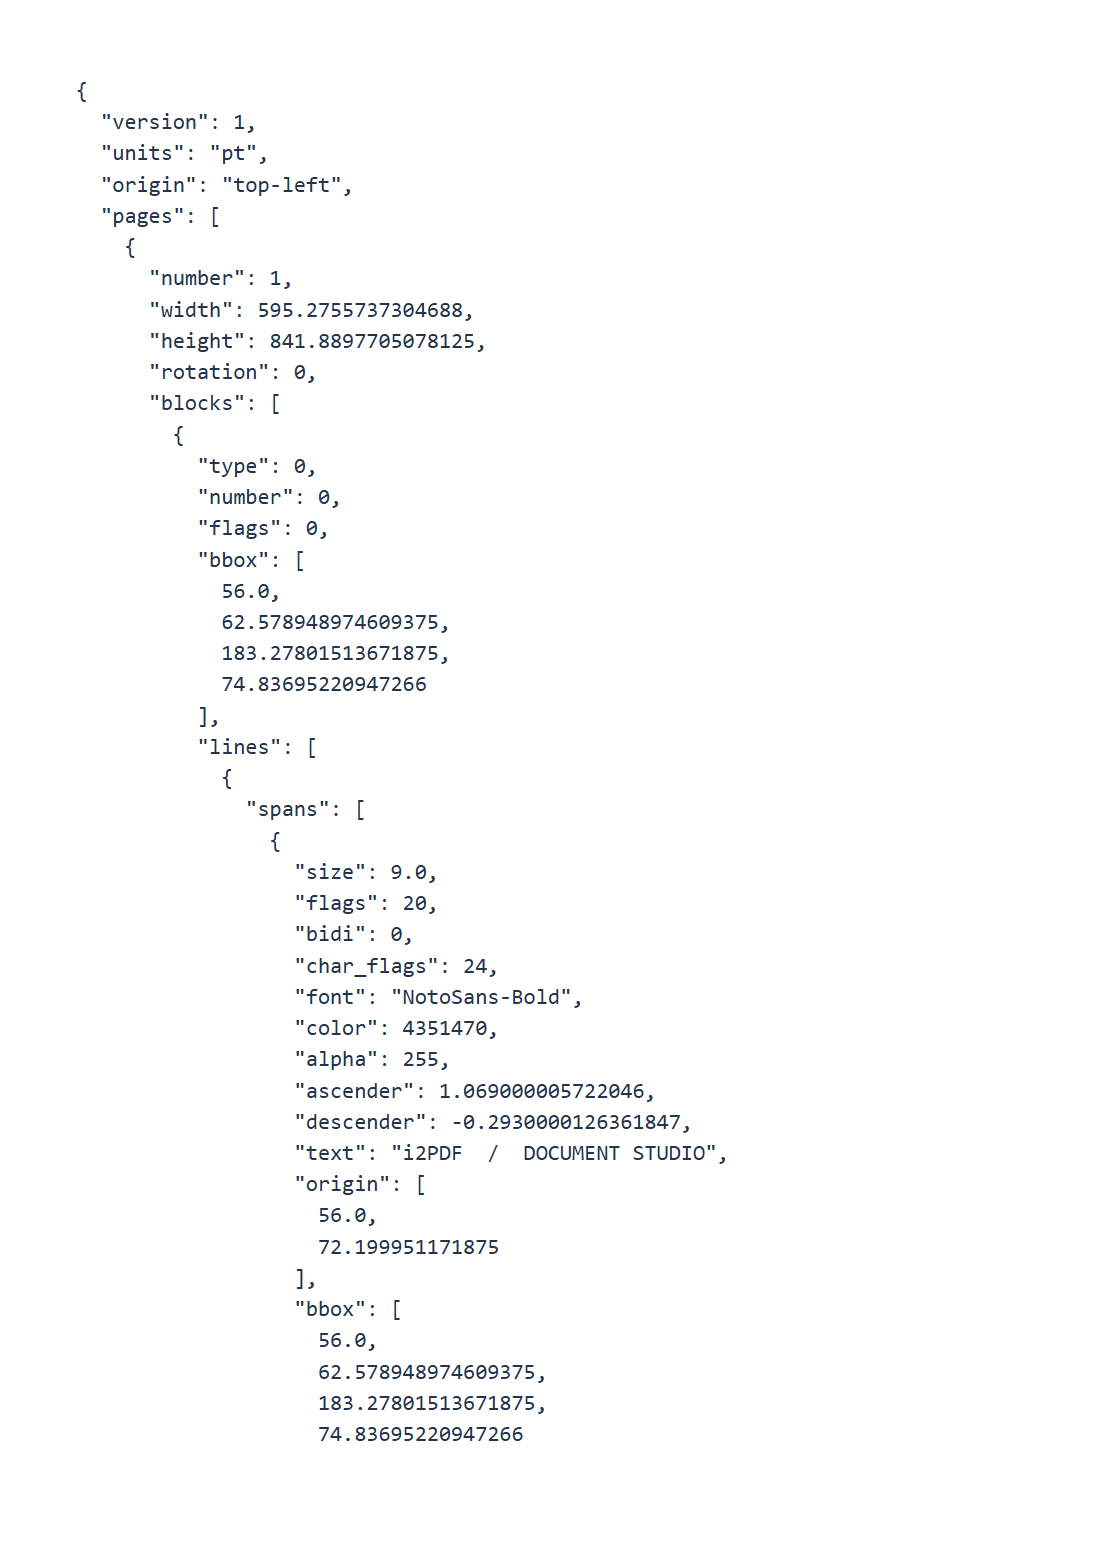
Пример объявляет версию 1, единицы измерения pt и начало координат top-left. Записи страниц включают номер исходной страницы, размеры, поворот, блоки и чертежи. Координаты описывают страницу без учета поворота; учитывайте поворот при наложении данных.
Разберите JSON с помощью парсера. Изучите блоки, строки и интервалы для текста и стилей, а также значения bbox для геометрии. Вложенные объекты описывают макет, а не просто текстовую строку.
Проверьте порядок чтения и ссылки на изображения в исходном PDF перед использованием данных в вашем рабочем процессе.
Часто задаваемые вопросы
Могу ли я точно восстановить исходный PDF?
Не предполагайте точную реконструкцию «туда и обратно». Экспорт описывает доступный контент и геометрию, в то время как функции и семантика PDF могут быть более сложными.
Почему я получил ZIP?
Пример содержит изображение. ZIP хранит document.json и связанный ресурс вместе, чтобы изображение можно было найти.
Попробуйте на своем документе
Просмотрите результат, затем сохраните нужную версию.