
打开 PDF 转 JSON 以导出页面记录、文本块和绘图数据。我们的四页 PDF 会生成 document.json 以及 ZIP 包内的一个引用 PNG 图像。
01
选择 PDF 页面
加载 PDF 并将 页面 留空以处理整个文档,或者输入您需要的子集。我们的示例包含所有四页。
02
导出并保持资源在一起
选择 开始。包含图像资源的导出文件将以 ZIP 格式下载。解压整个归档文件,并将 images 目录保留在 document.json 旁边。
示例包含 images/page-001-image-005.png。图像引用指向资源路径,而不是将二进制数据嵌入 JSON 中。不含图像资源的导出可以直接下载为 .json 文件。
03
读取文档结构
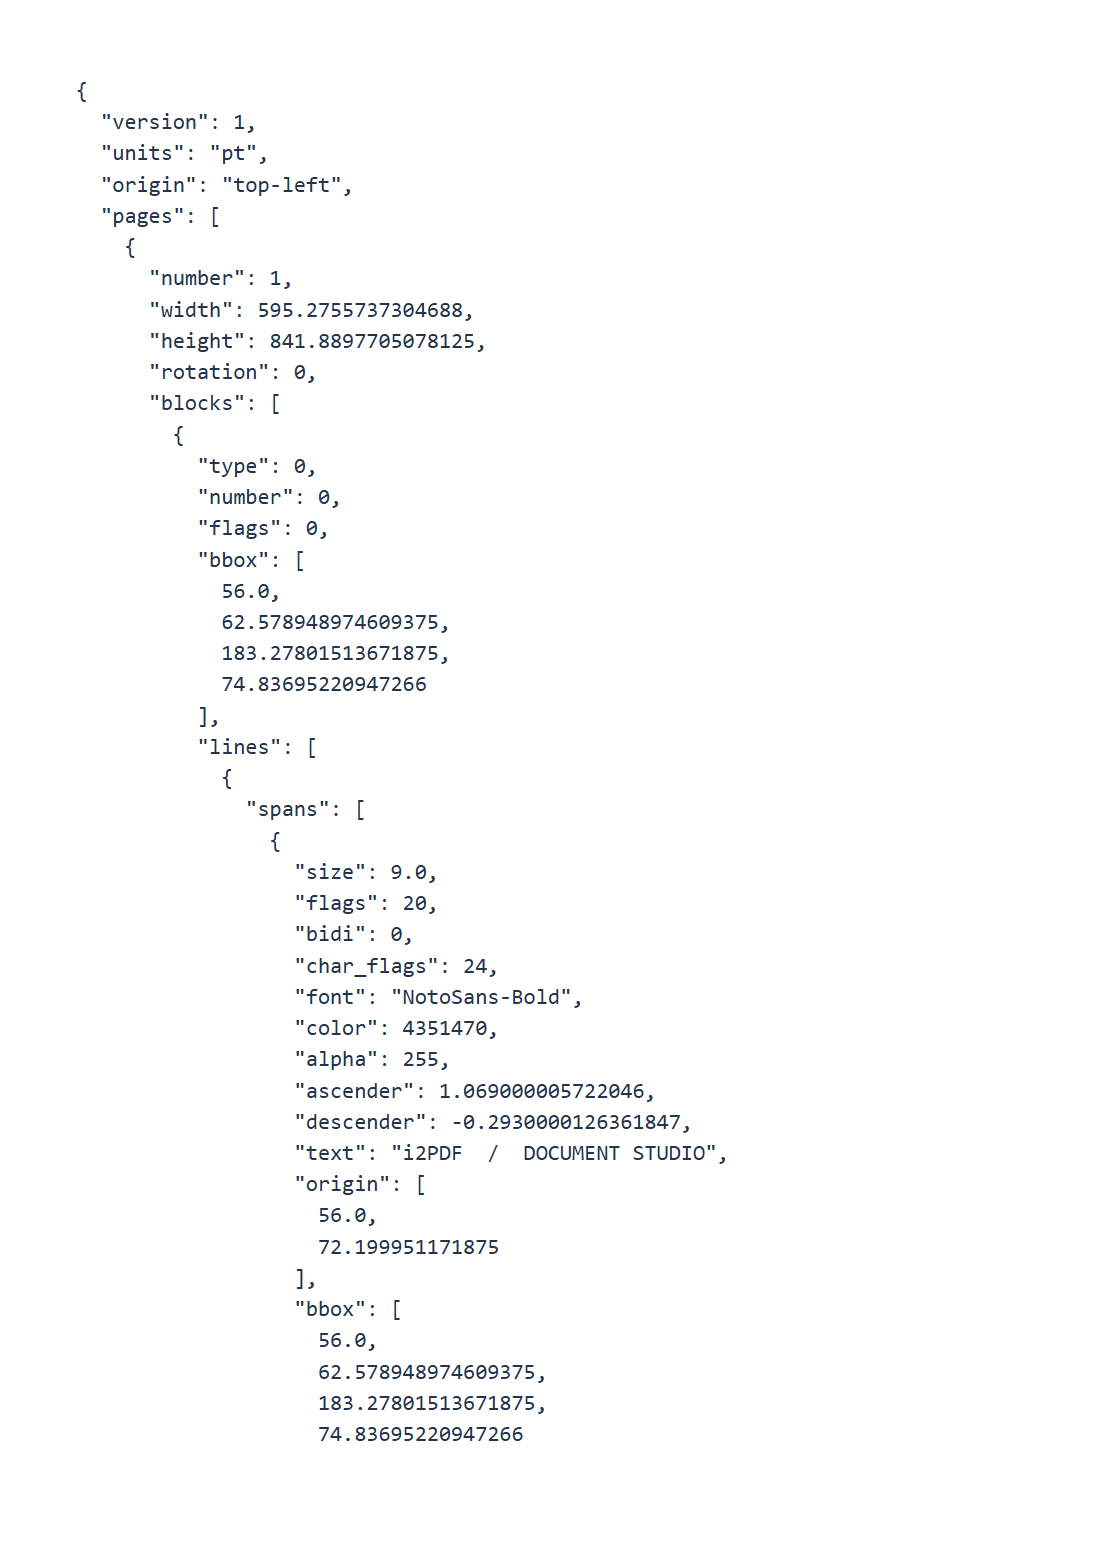
示例声明了版本 1、单位 pt 和 左上角 原点。页面记录包括源页码、尺寸、旋转、文本块和绘图。坐标描述的是未旋转的页面;在叠加数据时请考虑旋转因素。
使用 JSON 解析器解析 JSON。检查块、行和跨度以获取文本和样式,并检查 bbox 值以获取几何信息。嵌套对象描述的是布局,而不是单个文本字符串。
在您的处理工作流程中使用数据之前,请对照原始 PDF 检查阅读顺序和图像引用。
常见问题
我可以精确重建原始 PDF 吗?
不要假设可以进行精确的往返重建。导出内容描述的是可用内容和几何结构,而 PDF 的功能和语义可能更为复杂。
为什么我收到了一个 ZIP 文件?
示例包含一张图像。ZIP 文件将 document.json 和引用的资源保存在一起,以便能够定位图像。
轮到你了
打开 PDF 转 JSON 用您的文档试一试
查看结果,然后保存您需要的版本。