
Abra PDF a JSON para exportar registros de página, bloques de texto y datos de dibujo. Nuestro PDF de cuatro páginas produce document.json más una imagen PNG referenciada dentro de un ZIP.
Elija las páginas del PDF
Cargue el PDF y deje Páginas en blanco para todo el documento, o introduzca el subconjunto que necesite. Nuestro ejemplo incluye las cuatro páginas.
Exporte y mantenga los recursos juntos
Elija Iniciar. Una exportación con recursos de imagen se descarga como ZIP. Extraiga todo el archivo y mantenga el directorio images junto a document.json.
La muestra incluye images/page-001-image-005.png. Las referencias de imagen apuntan a rutas de recursos en lugar de incrustar datos binarios en el JSON. Una exportación sin recursos de imagen puede descargarse directamente como .json.
Lea la estructura del documento
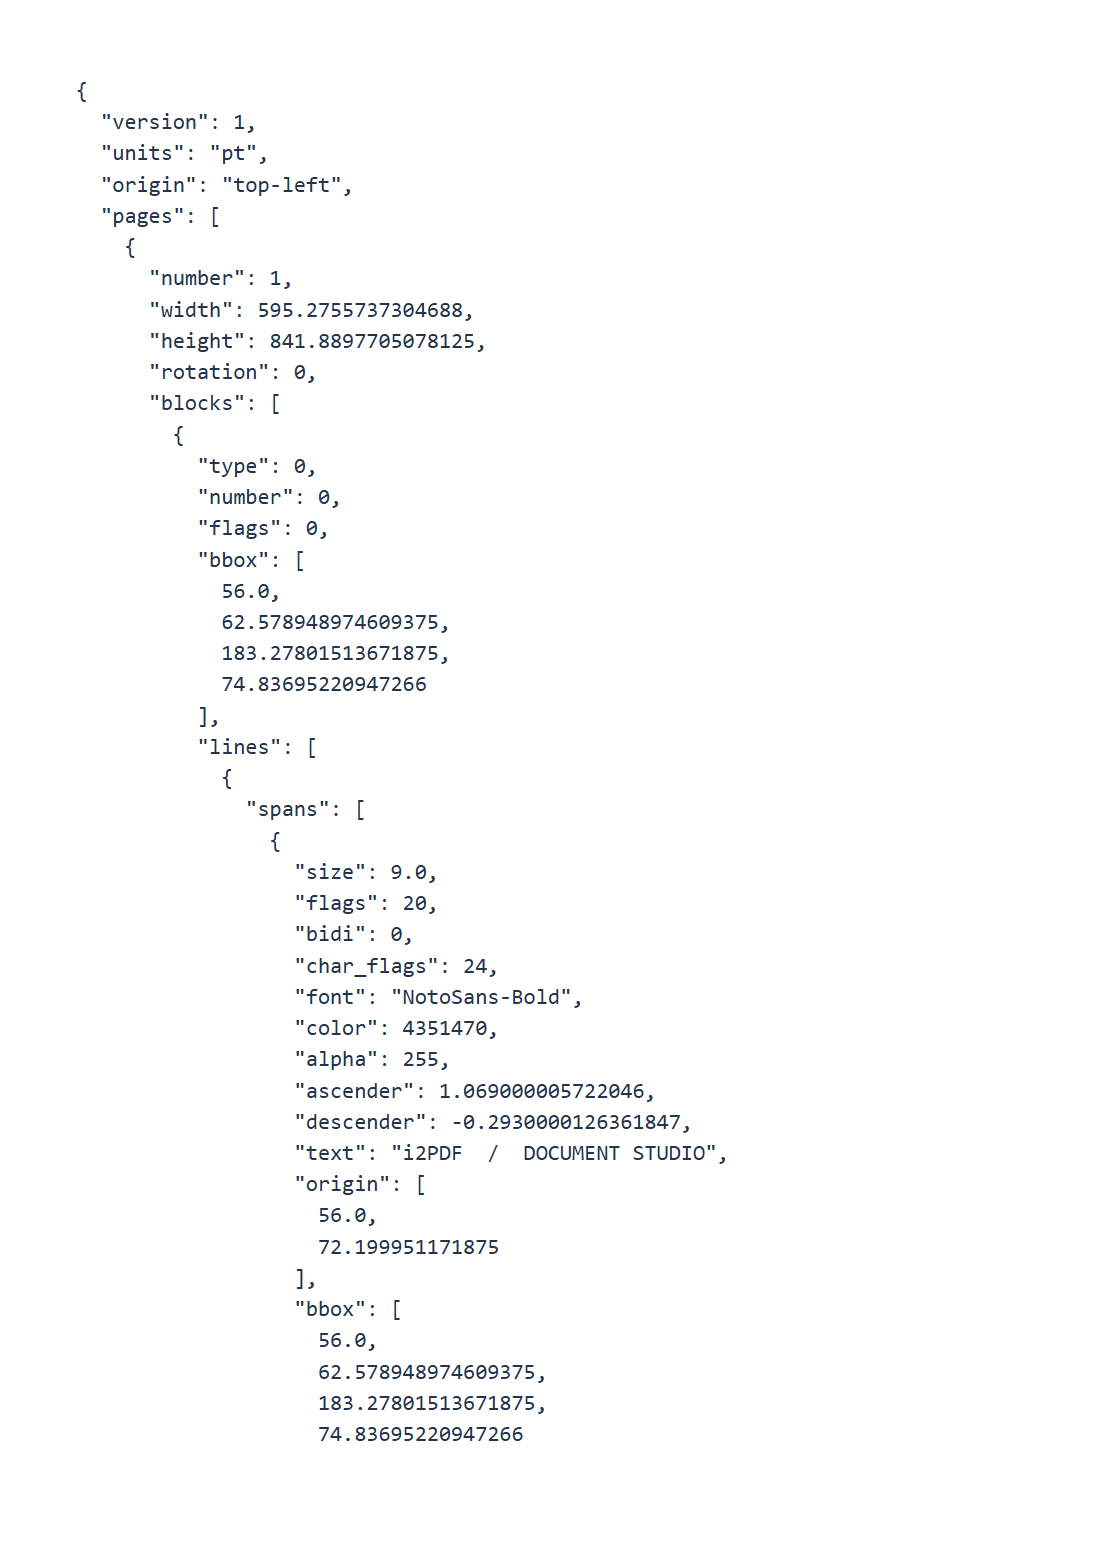
La muestra declara la versión 1, unidades pt y un origen superior izquierdo. Los registros de página incluyen el número de página de origen, dimensiones, rotación, bloques y dibujos. Las coordenadas describen la página sin rotar; tenga en cuenta la rotación al superponer los datos.
Analice el JSON con un analizador JSON. Inspeccione bloques, líneas y tramos para ver el texto y el estilo, y los valores bbox para la geometría. Los objetos anidados describen el diseño en lugar de una sola cadena de texto.
Compruebe el orden de lectura y las referencias de imagen con respecto al PDF original antes de utilizar los datos en su flujo de trabajo de procesamiento.
Preguntas frecuentes
¿Puedo reconstruir el PDF original exactamente?
No asuma una reconstrucción exacta de ida y vuelta. La exportación describe el contenido y la geometría disponibles, mientras que las características y la semántica del PDF pueden ser más complejas.
¿Por qué recibí un ZIP?
La muestra contiene una imagen. El ZIP mantiene document.json y el recurso referenciado juntos para que la imagen pueda ser localizada.
Pruébelo con su documento
Revise el resultado y luego guarde la versión que necesite.