
Open PDF naar JSON om paginarecords, tekstblokken en tekengegevens te exporteren. Onze PDF van vier pagina's produceert document.json plus één referentie-PNG-afbeelding in een ZIP-bestand.
Kies de PDF-pagina's
Laad de PDF en laat Pagina's leeg voor het hele document, of voer de subset in die je nodig hebt. Ons voorbeeld bevat alle vier de pagina's.
Exporteer en houd de bestanden bij elkaar
Kies Start. Een export met afbeeldingsbestanden wordt gedownload als ZIP. Pak het hele archief uit en bewaar de images-map naast document.json.
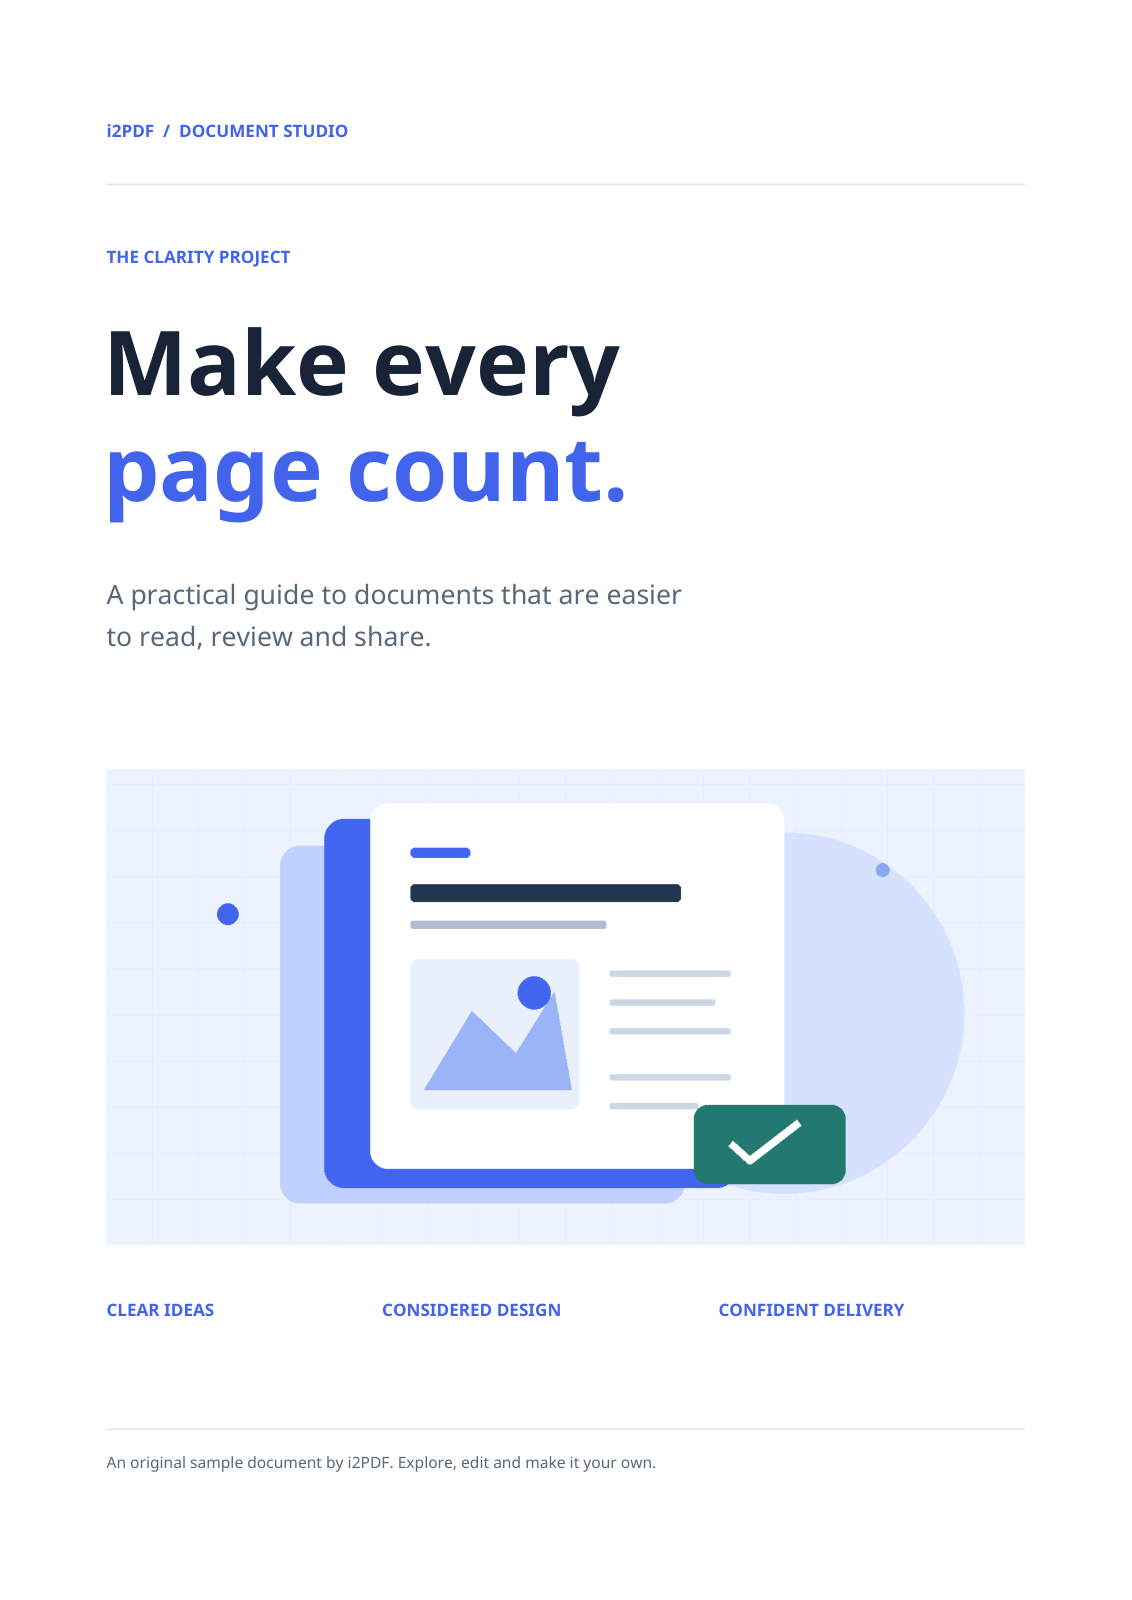
Het voorbeeld bevat images/page-001-image-005.png. Afbeeldingsverwijzingen wijzen naar bestandspaden in plaats van binaire data in de JSON in te sluiten. Een export zonder afbeeldingsbestanden kan direct als .json worden gedownload.
Lees de documentstructuur
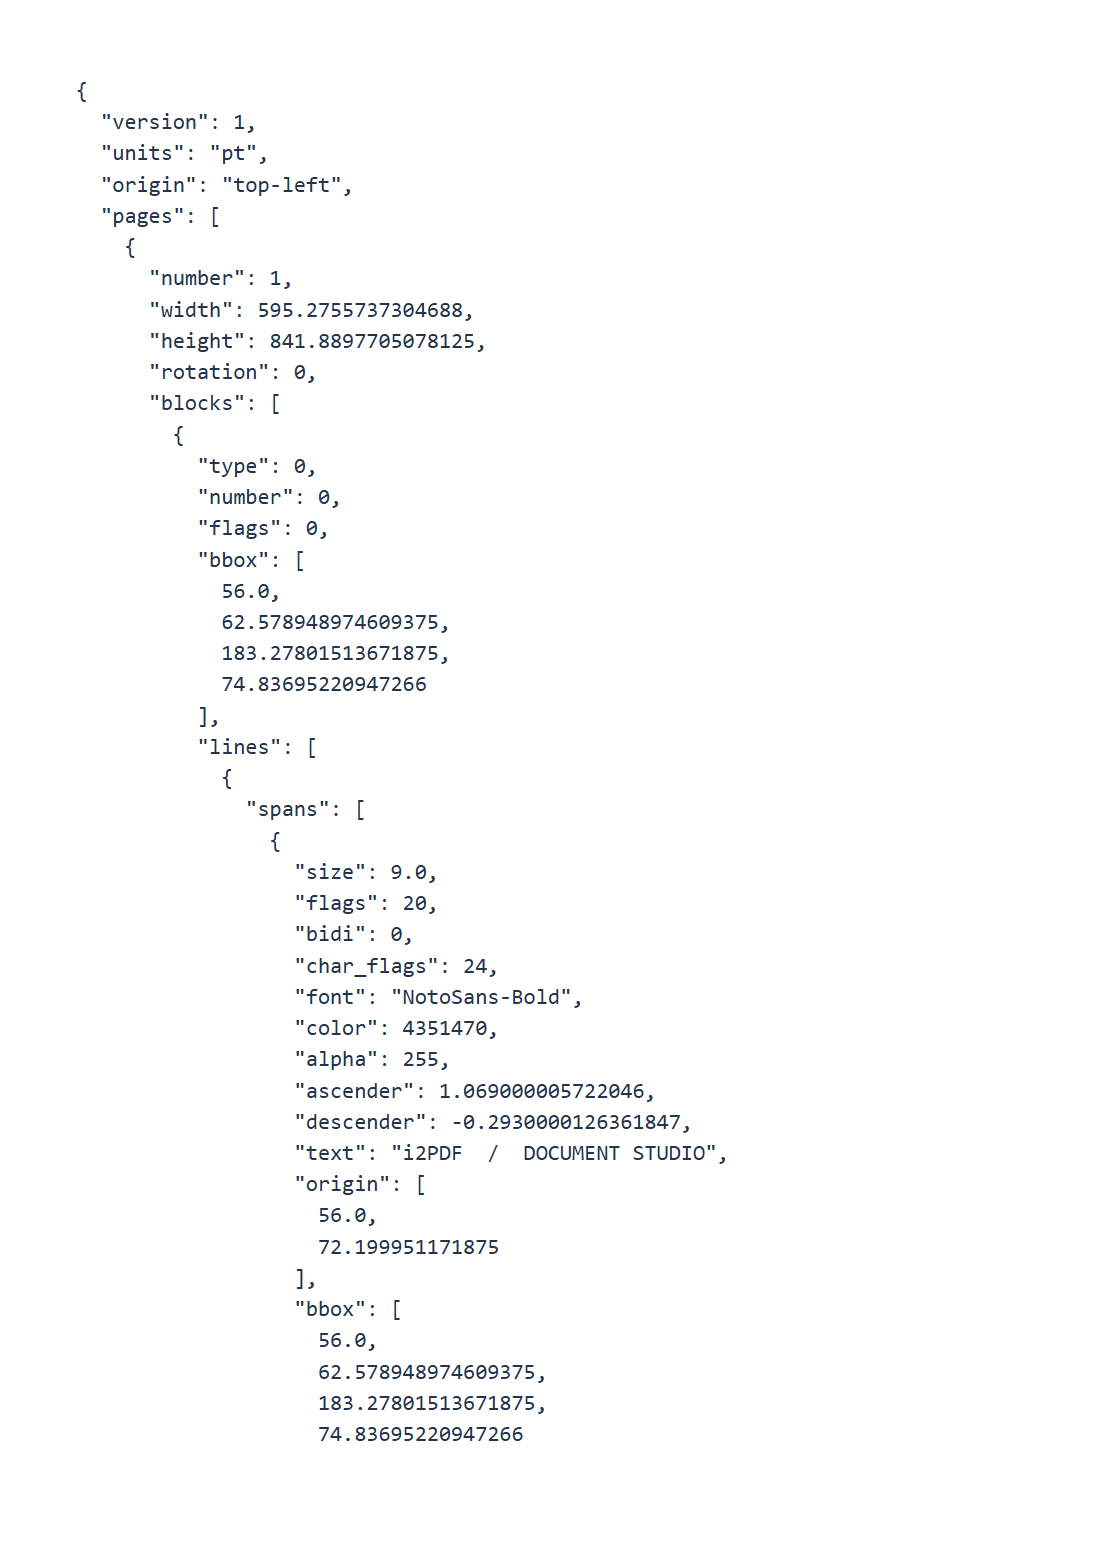
Het voorbeeld declareert versie 1, eenheden pt en een top-left oorsprong. Paginarecords bevatten het bronpaginanummer, dimensies, rotatie, blokken en tekeningen. Coördinaten beschrijven de niet-geroteerde pagina; houd rekening met rotatie bij het overlappen van de data.
Parse de JSON met een JSON-parser. Inspecteer blokken, regels en spans voor tekst en opmaak, en bbox-waarden voor geometrie. Geneste objecten beschrijven de lay-out in plaats van een enkele tekstreeks.
Controleer de leesvolgorde en afbeeldingsverwijzingen tegen de originele PDF voordat je de data in je verwerkingsworkflow gebruikt.
Veelgestelde vragen
Kan ik de originele PDF exact herbouwen?
Ga niet uit van een exacte round-trip reconstructie. De export beschrijft de beschikbare inhoud en geometrie, terwijl PDF-functies en semantiek complexer kunnen zijn.
Waarom heb ik een ZIP ontvangen?
Het voorbeeld bevat een afbeelding. ZIP houdt document.json en het referentiebestand bij elkaar zodat de afbeelding kan worden gevonden.
Probeer het met jouw document
Controleer het resultaat en sla vervolgens de versie op die je nodig hebt.