
Öffnen Sie PDF to JSON, um Seitendatensätze, Textblöcke und Zeichnungsdaten zu exportieren. Unser vierseitiges PDF erzeugt document.json sowie ein referenziertes PNG-Bild innerhalb einer ZIP-Datei.
Wählen Sie die PDF-Seiten
Laden Sie das PDF und lassen Sie Pages für das gesamte Dokument leer oder geben Sie die gewünschte Teilmenge ein. Unser Beispiel umfasst alle vier Seiten.
Exportieren und Assets zusammenhalten
Wählen Sie Start. Ein Export mit Bild-Assets wird als ZIP heruntergeladen. Entpacken Sie das gesamte Archiv und bewahren Sie das Verzeichnis images neben document.json auf.
Das Beispiel enthält images/page-001-image-005.png. Bildreferenzen verweisen auf Asset-Pfade, anstatt Binärdaten in das JSON einzubetten. Ein Export ohne Bild-Assets kann direkt als .json heruntergeladen werden.
Lesen Sie die Dokumentstruktur
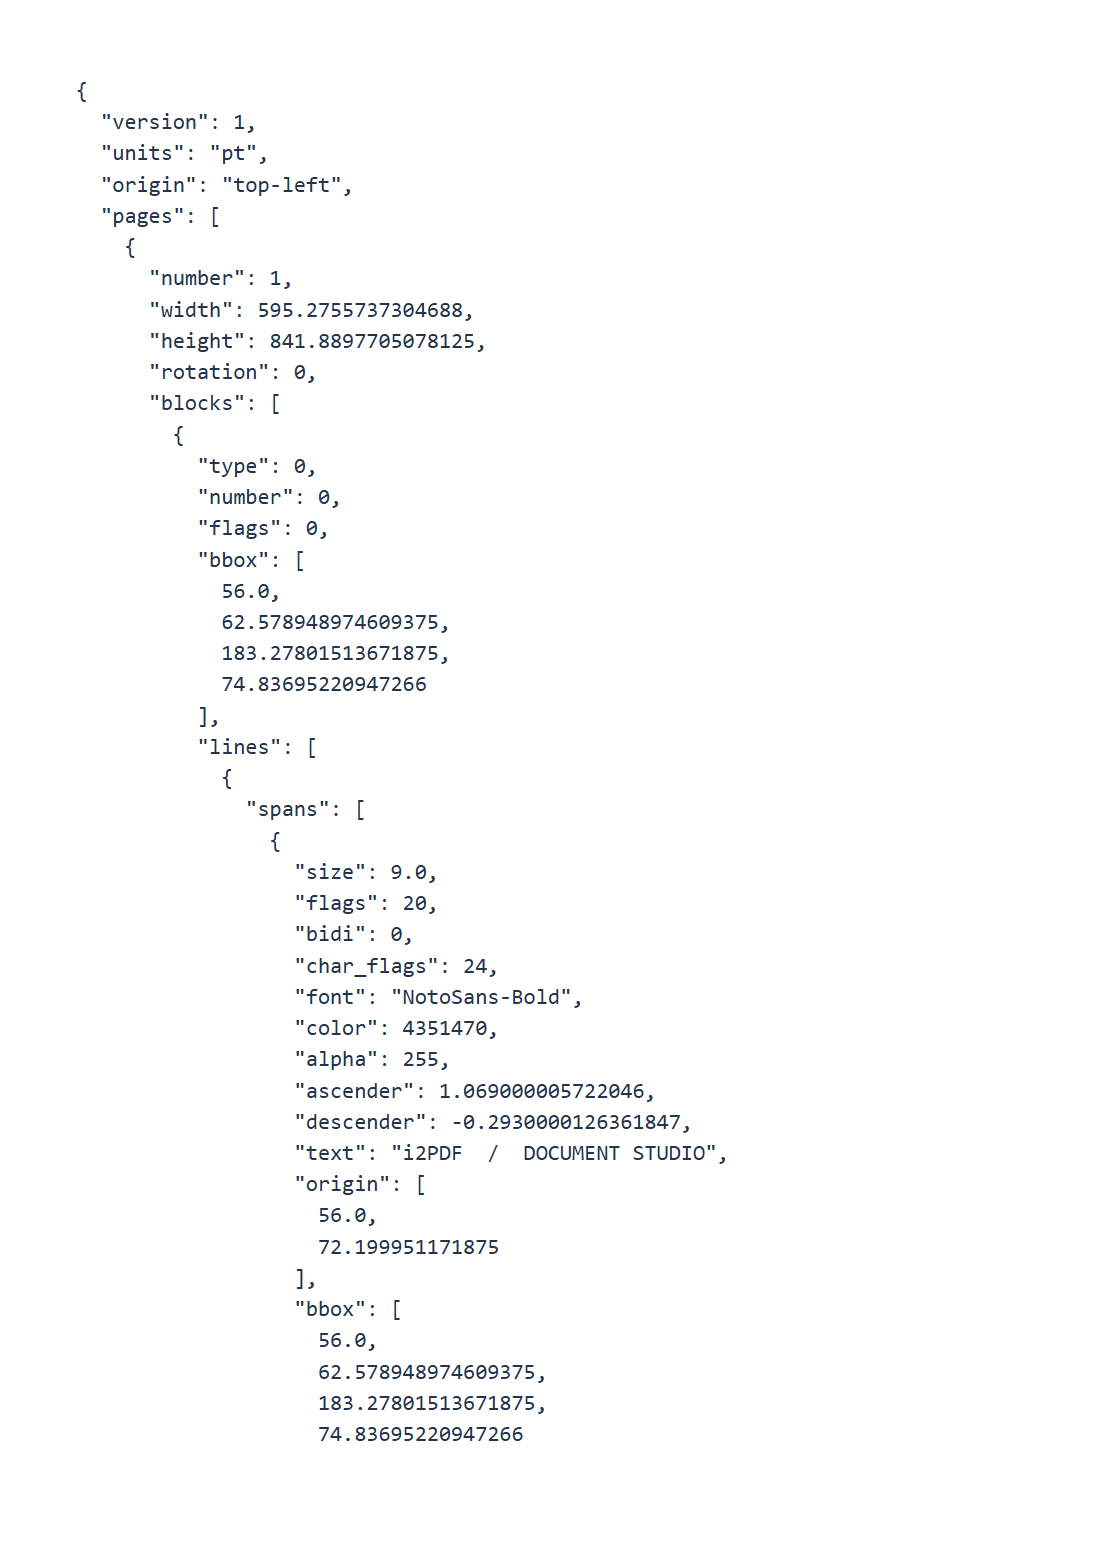
Das Beispiel deklariert Version 1, Einheiten pt und einen top-left Ursprung. Seitendatensätze enthalten die Quellseitennummer, Dimensionen, Drehung, Blöcke und Zeichnungen. Koordinaten beschreiben die ungedrehte Seite; berücksichtigen Sie die Drehung beim Überlagern der Daten.
Parsen Sie das JSON mit einem JSON-Parser. Untersuchen Sie Blöcke, Zeilen und Spannen auf Text und Formatierung sowie bbox-Werte für die Geometrie. Verschachtelte Objekte beschreiben das Layout anstelle einer einzelnen Textzeichenfolge.
Überprüfen Sie die Leserichtung und Bildreferenzen anhand des ursprünglichen PDFs, bevor Sie die Daten in Ihrem Verarbeitungsworkflow verwenden.
Häufige Fragen
Kann ich das ursprüngliche PDF exakt wiederherstellen?
Gehen Sie nicht von einer exakten Round-Trip-Rekonstruktion aus. Der Export beschreibt verfügbare Inhalte und Geometrie, während PDF-Funktionen und Semantik komplexer sein können.
Warum habe ich eine ZIP-Datei erhalten?
Das Beispiel enthält ein Bild. ZIP hält document.json und das referenzierte Asset zusammen, damit das Bild lokalisiert werden kann.
Probieren Sie es mit Ihrem Dokument aus
Überprüfen Sie das Ergebnis und speichern Sie dann die benötigte Version.