
გახსენით PDF JSON-ში გვერდის ჩანაწერების, ტექსტური ბლოკებისა და ნახაზის მონაცემების ექსპორტისთვის. ჩვენი ოთხგვერდიანი PDF წარმოქმნის document.json ფაილს და ერთ მითითებულ PNG სურათს ZIP არქივში.
აირჩიეთ PDF გვერდები
ჩატვირთეთ PDF და დატოვეთ გვერდები ცარიელი მთელი დოკუმენტისთვის, ან შეიყვანეთ საჭირო ქვესიმრავლე. ჩვენი მაგალითი მოიცავს ოთხივე გვერდს.
ექსპორტი და აქტივების ერთად შენახვა
აირჩიეთ დაწყება. სურათების აქტივებთან ერთად ექსპორტი ჩამოიტვირთება როგორც ZIP. ამოაარქივეთ მთელი არქივი და შეინახეთ images დირექტორია document.json-ის გვერდით.
ნიმუში მოიცავს images/page-001-image-005.png. სურათის მითითებები მიუთითებს აქტივების გზებზე და არა ბინარული მონაცემების ჩაშენებაზე JSON-ში. ექსპორტი სურათების აქტივების გარეშე შეიძლება ჩამოიტვირთოს პირდაპირ როგორც .json.
დოკუმენტის სტრუქტურის წაკითხვა
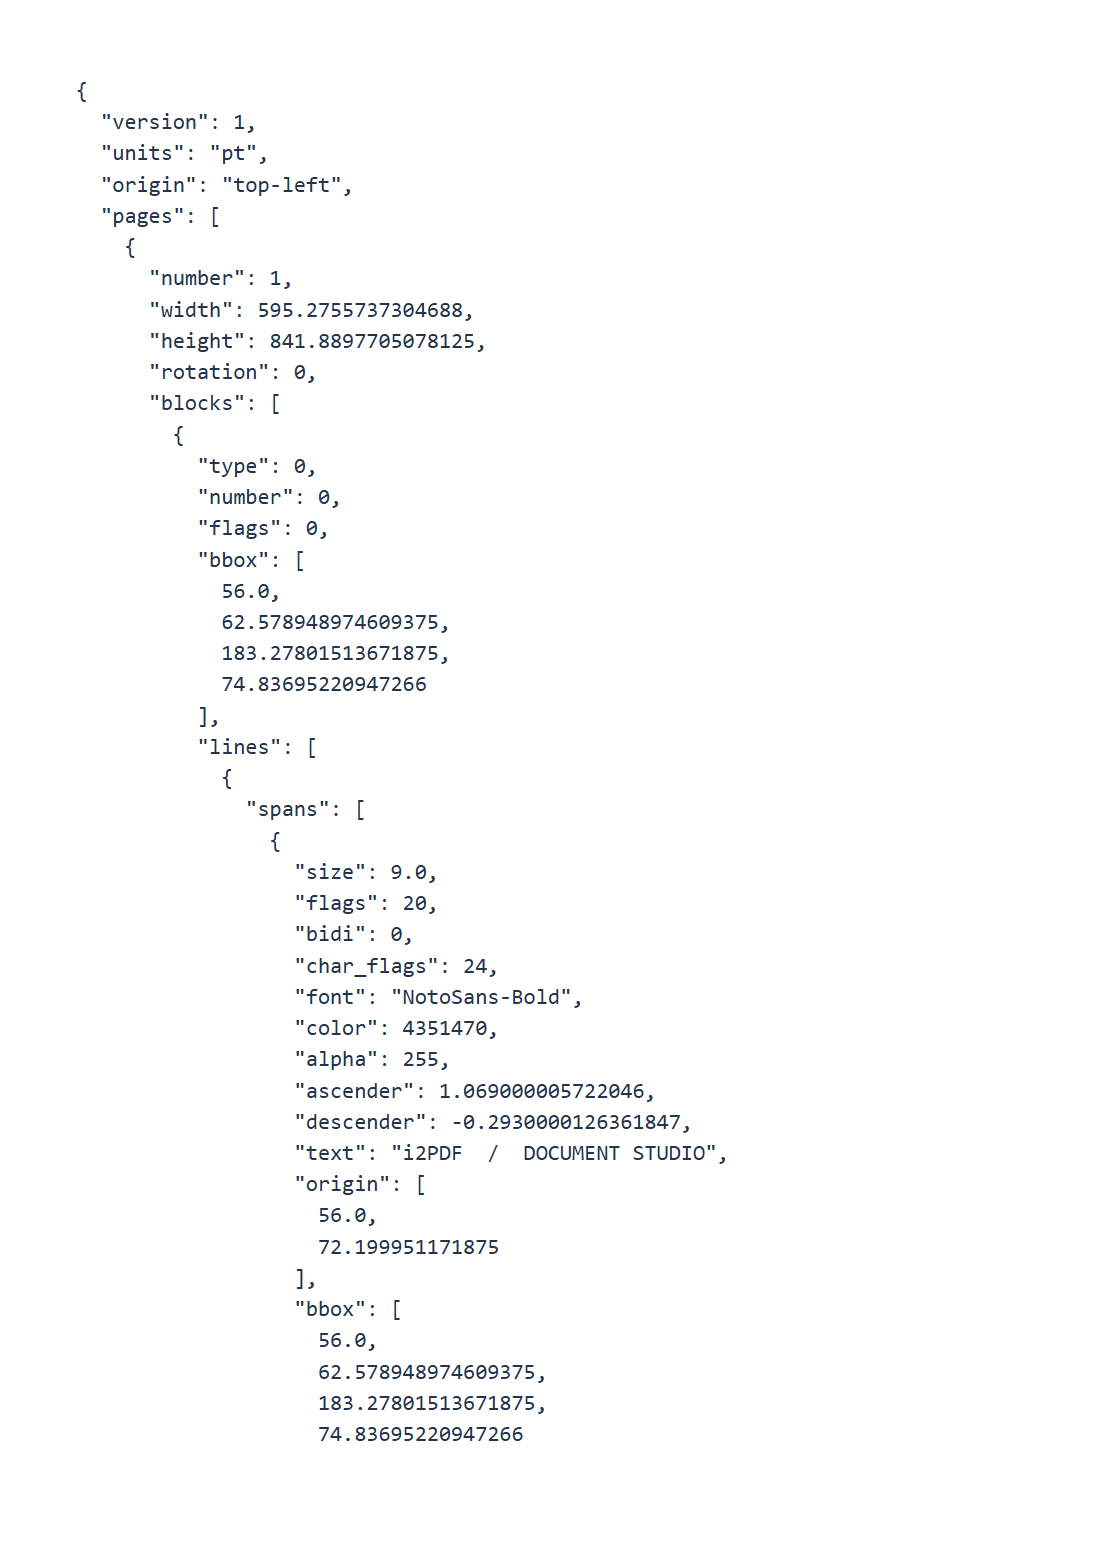
ნიმუში აცხადებს ვერსიას 1, ერთეულებს pt და ზედა-მარცხენა საწყის წერტილს. გვერდის ჩანაწერები მოიცავს წყაროს გვერდის ნომერს, ზომებს, როტაციას, ბლოკებსა და ნახაზებს. კოორდინატები აღწერს არაბრუნვად გვერდს; გაითვალისწინეთ როტაცია მონაცემების გადაფარვისას.
დააპარსეთ JSON შესაბამისი პარსერით. შეამოწმეთ ბლოკები, ხაზები და ინტერვალები ტექსტისა და სტილისთვის, ხოლო bbox მნიშვნელობები გეომეტრიისთვის. ჩადგმული ობიექტები აღწერს განლაგებას და არა ერთ ტექსტურ სტრიქონს.
შეამოწმეთ კითხვის თანმიმდევრობა და სურათის მითითებები ორიგინალ PDF-თან მიმართებაში, სანამ მონაცემებს გამოიყენებთ თქვენს სამუშაო პროცესში.
ხშირად დასმული კითხვები
შემიძლია თუ არა ორიგინალი PDF-ის ზუსტად აღდგენა?
ნუ ივარაუდებთ ზუსტ ორმხრივ რეკონსტრუქციას. ექსპორტი აღწერს ხელმისაწვდომ შიგთავსსა და გეომეტრიას, მაშინ როცა PDF-ის მახასიათებლები და სემანტიკა შეიძლება უფრო რთული იყოს.
რატომ მივიღე ZIP ფაილი?
ნიმუში შეიცავს სურათს. ZIP ინახავს document.json-ს და მითითებულ აქტივს ერთად, რათა სურათის პოვნა შესაძლებელი იყოს.
სცადეთ თქვენი დოკუმენტით
გადახედეთ შედეგს და შემდეგ შეინახეთ საჭირო ვერსია.