工具150

实用的 PDF 指南

如何将 PDF 转换为带有布局数据的 XML

获取结构化的页面数据以供您的工作流程使用。

将 PDF 文本、页面尺寸和绘图数据导出为 XML。保持引用图像的完整性,并在代码中使用前检查其结构。

跟随指南操作
真实的工具示例
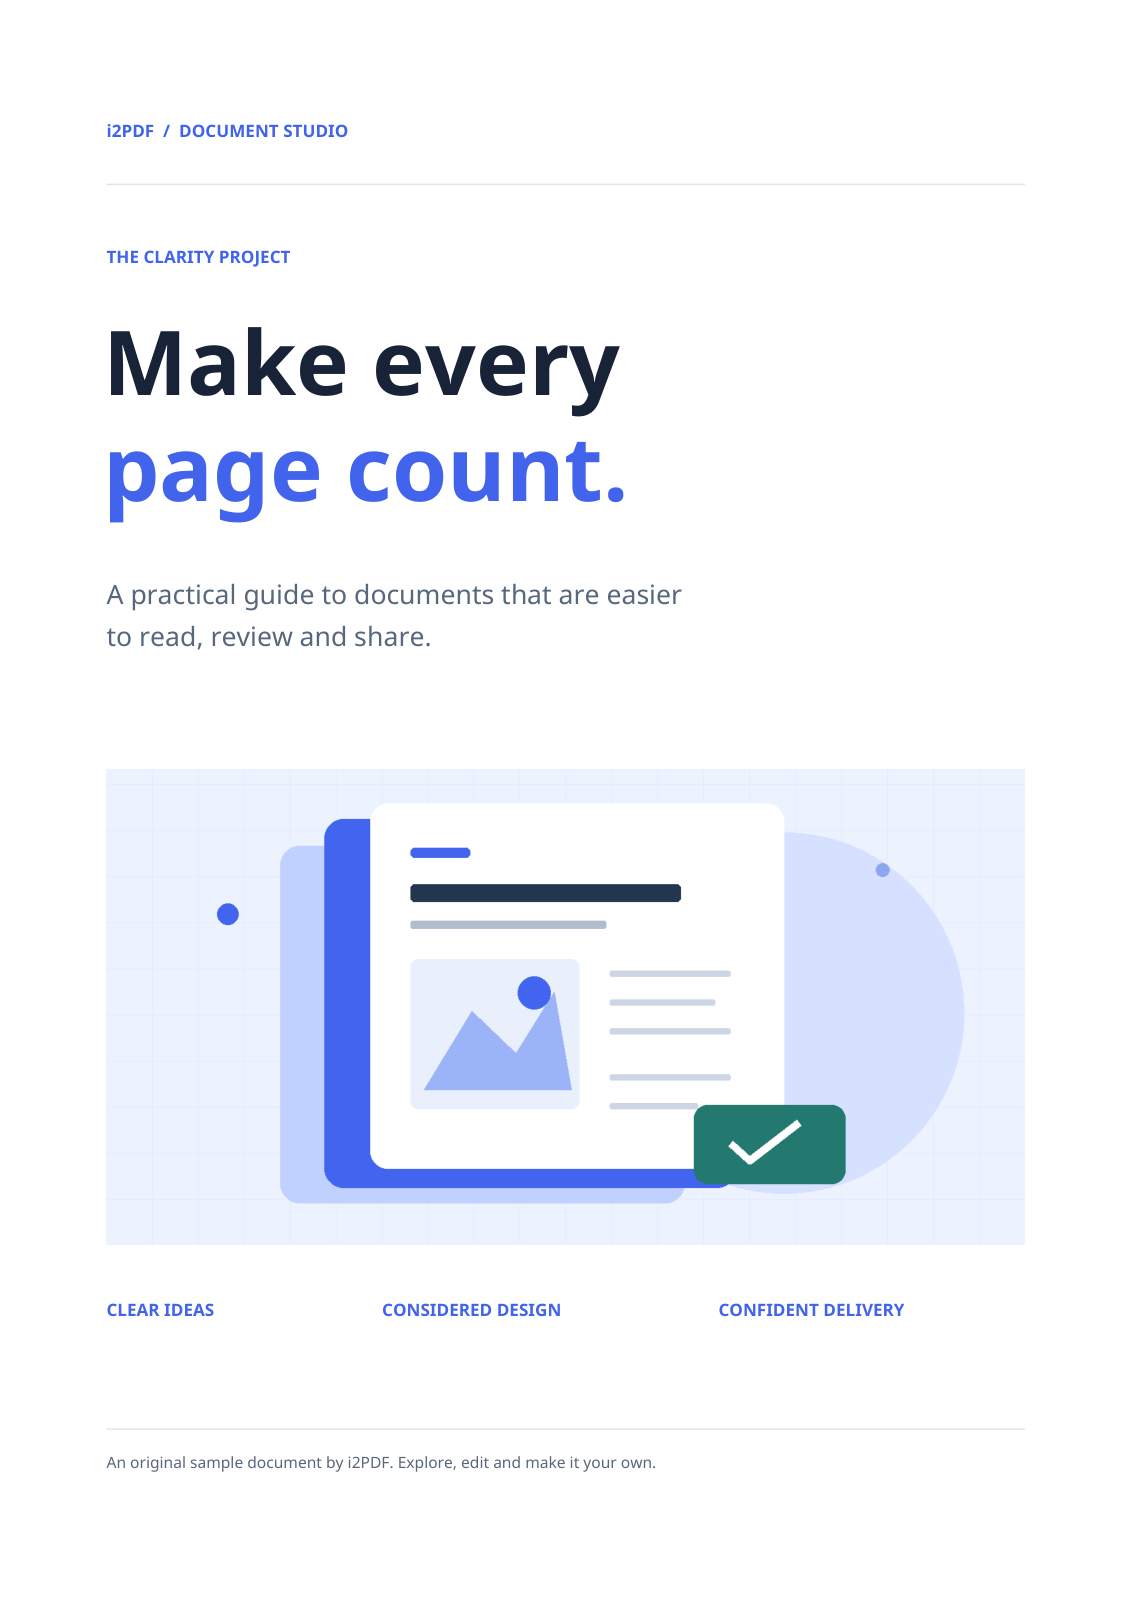
之前四页 PDF 源文件的第一页。
  • 4 个 PDF 页面
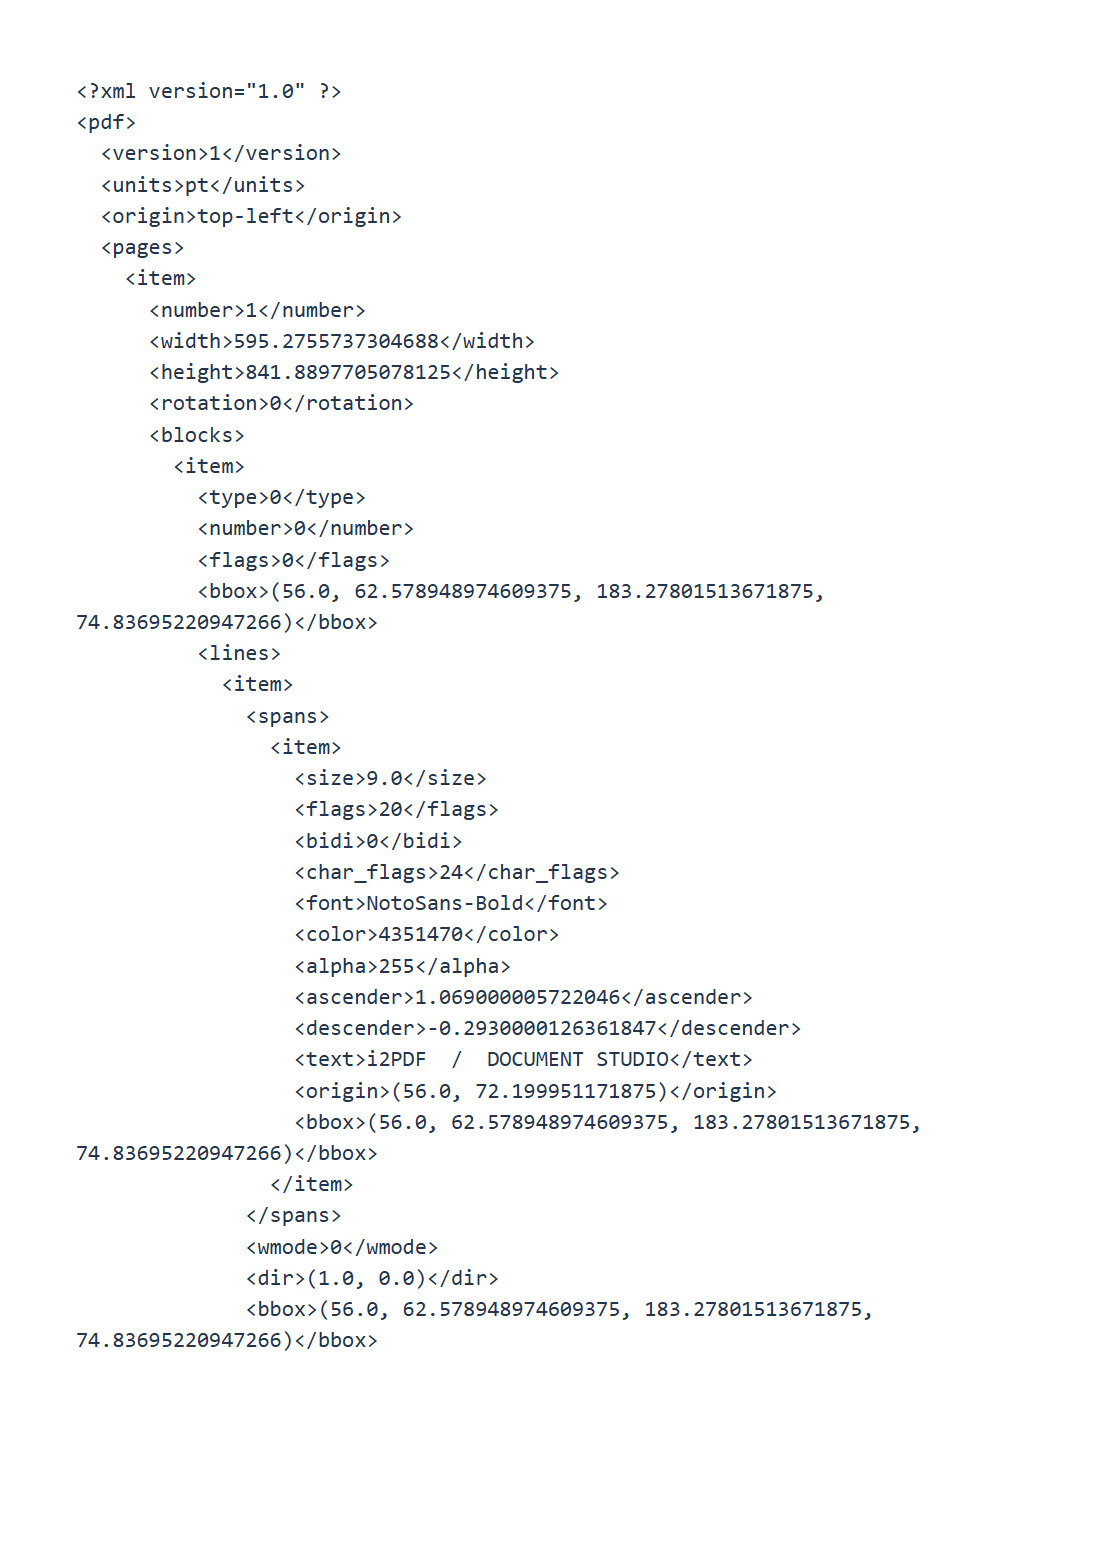
之后实际 document.xml 导出的格式化预览摘录。
  • document.xml · 4 条页面记录
  • 1 个引用的 PNG 资源
结果为结构化的 XML 数据,此处显示为摘录。完整导出包含所有四页内容及引用的图像资源。
Advertisements
快速视频教程 如何将 PDF 转换为带有布局数据的 XML 获取结构化的页面数据以供您的工作流程使用。 英语旁白 观看视频

如何将 PDF 转换为带有布局数据的 XML

Advertisements

打开 PDF 转 XML 以导出页面记录、文本块和绘图数据。我们的四页 PDF 生成 document.xml 以及 ZIP 包内的一个引用 PNG 图像。

01

选择 PDF 页面

加载 PDF,将 页面 留空以处理整个文档,或输入您需要的子集。我们的示例包含所有四页。

02

导出并保持资源在一起

选择 开始。包含图像资源的导出将以 ZIP 格式下载。解压整个归档文件,并将 images 目录保留在 document.xml 旁边。

示例包含 images/page-001-image-005.png。图像引用指向资源路径,而不是将二进制数据嵌入 XML 中。不含图像资源的导出可直接下载为 .xml 文件。

03

读取文档结构

示例声明了版本 1、单位 pt 和 左上角 原点。页面记录包括源页码、尺寸、旋转、文本块和绘图。坐标描述的是未旋转的页面;在叠加数据时请考虑旋转因素。

使用 XML 解析器解析 XML。重复值使用 item 元素;一些几何元组为文本值。请检查实际结构,而不是假设使用 DocBook 等发布架构。

在您的处理工作流程中使用数据之前,请对照原始 PDF 检查阅读顺序和图像引用。

一些有用的细节

常见问题

XML 是否包含语义章节?

它描述了提取的页面数据。标题含义、阅读顺序和文档语义可能需要您自行解读。

为什么我收到了一个 ZIP 文件?

示例包含一张图像。ZIP 将 document.xml 和引用的资源保存在一起,以便能够定位图像。

轮到您了

用您的文档试一试

查看结果,然后保存您需要的版本。

打开 PDF 转 XML

图片详情

Advertisements

語38

English العربية Français Italiano Deutsch Español Português Nederlands Русский Türkçe 日本語 中文 हिन्दी Bahasa Indonesia Bahasa Melayu 한국어 Tiếng Việt ไทย Polski Svenska Українська Norsk বাংলা Ελληνικά فارسی اردو Čeština Dansk Magyar Română Suomi Български Filipino ქართული Slovenčina Azərbaycanca עברית Slovenščina