

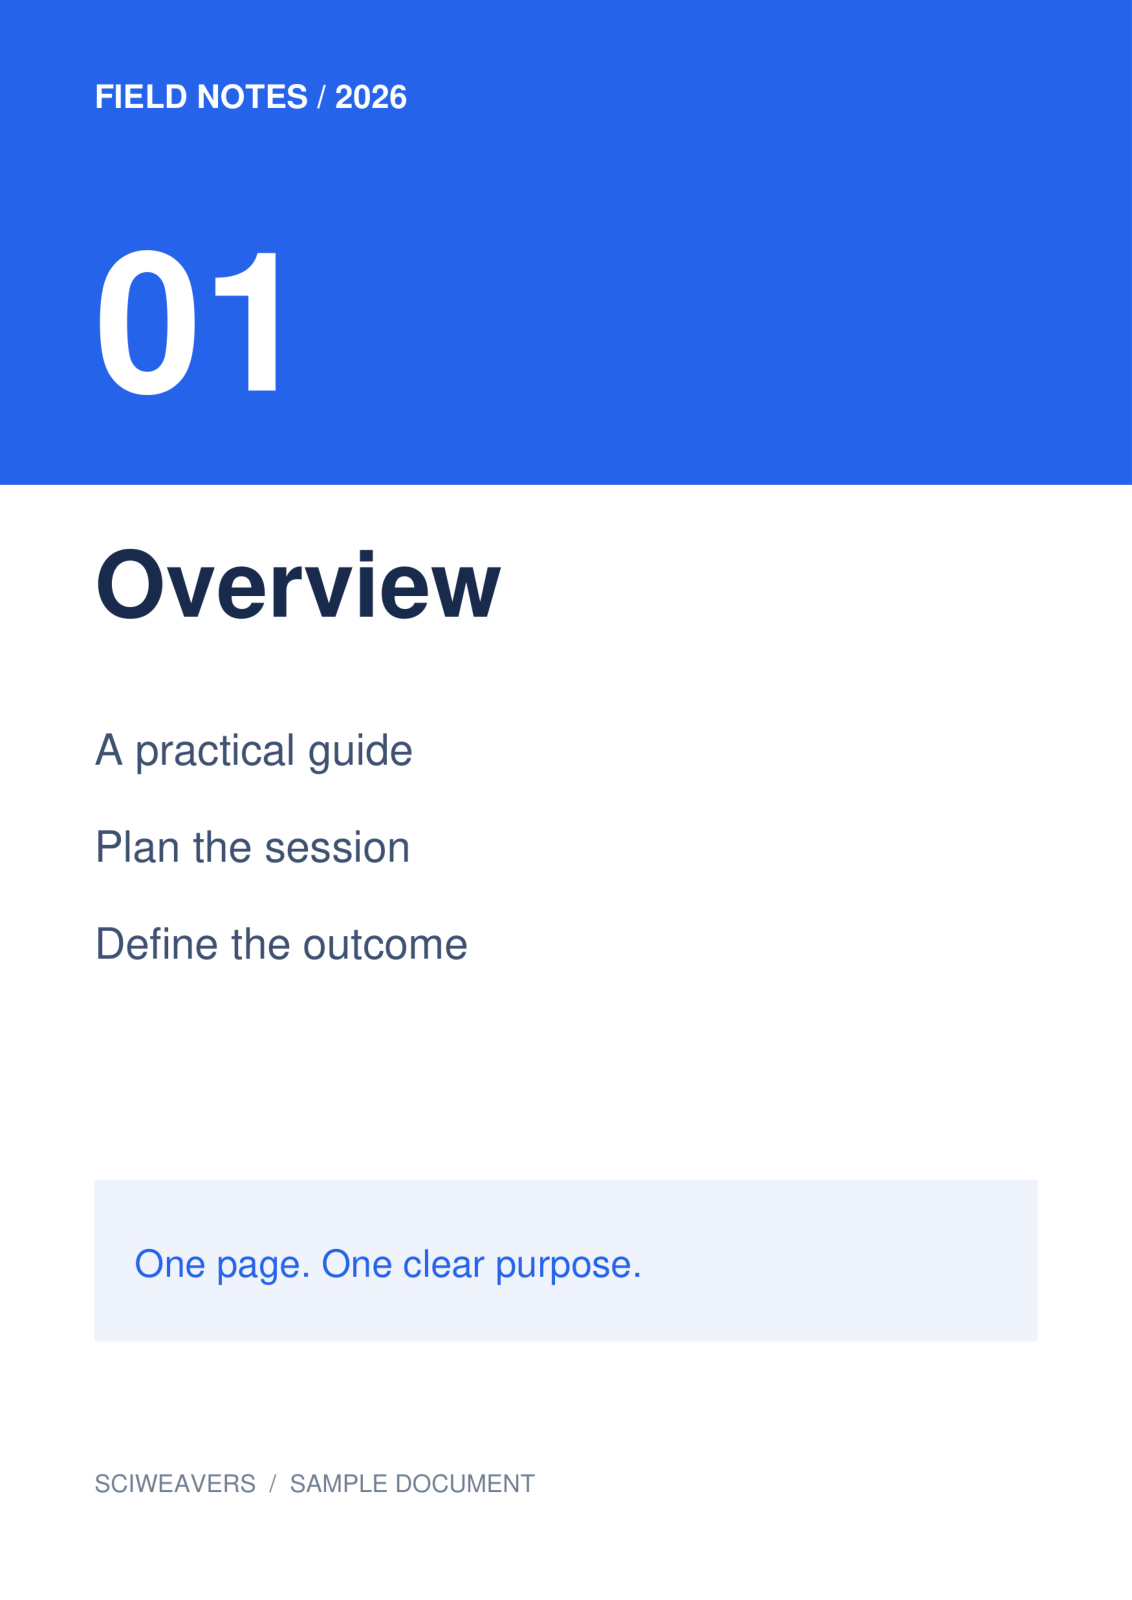
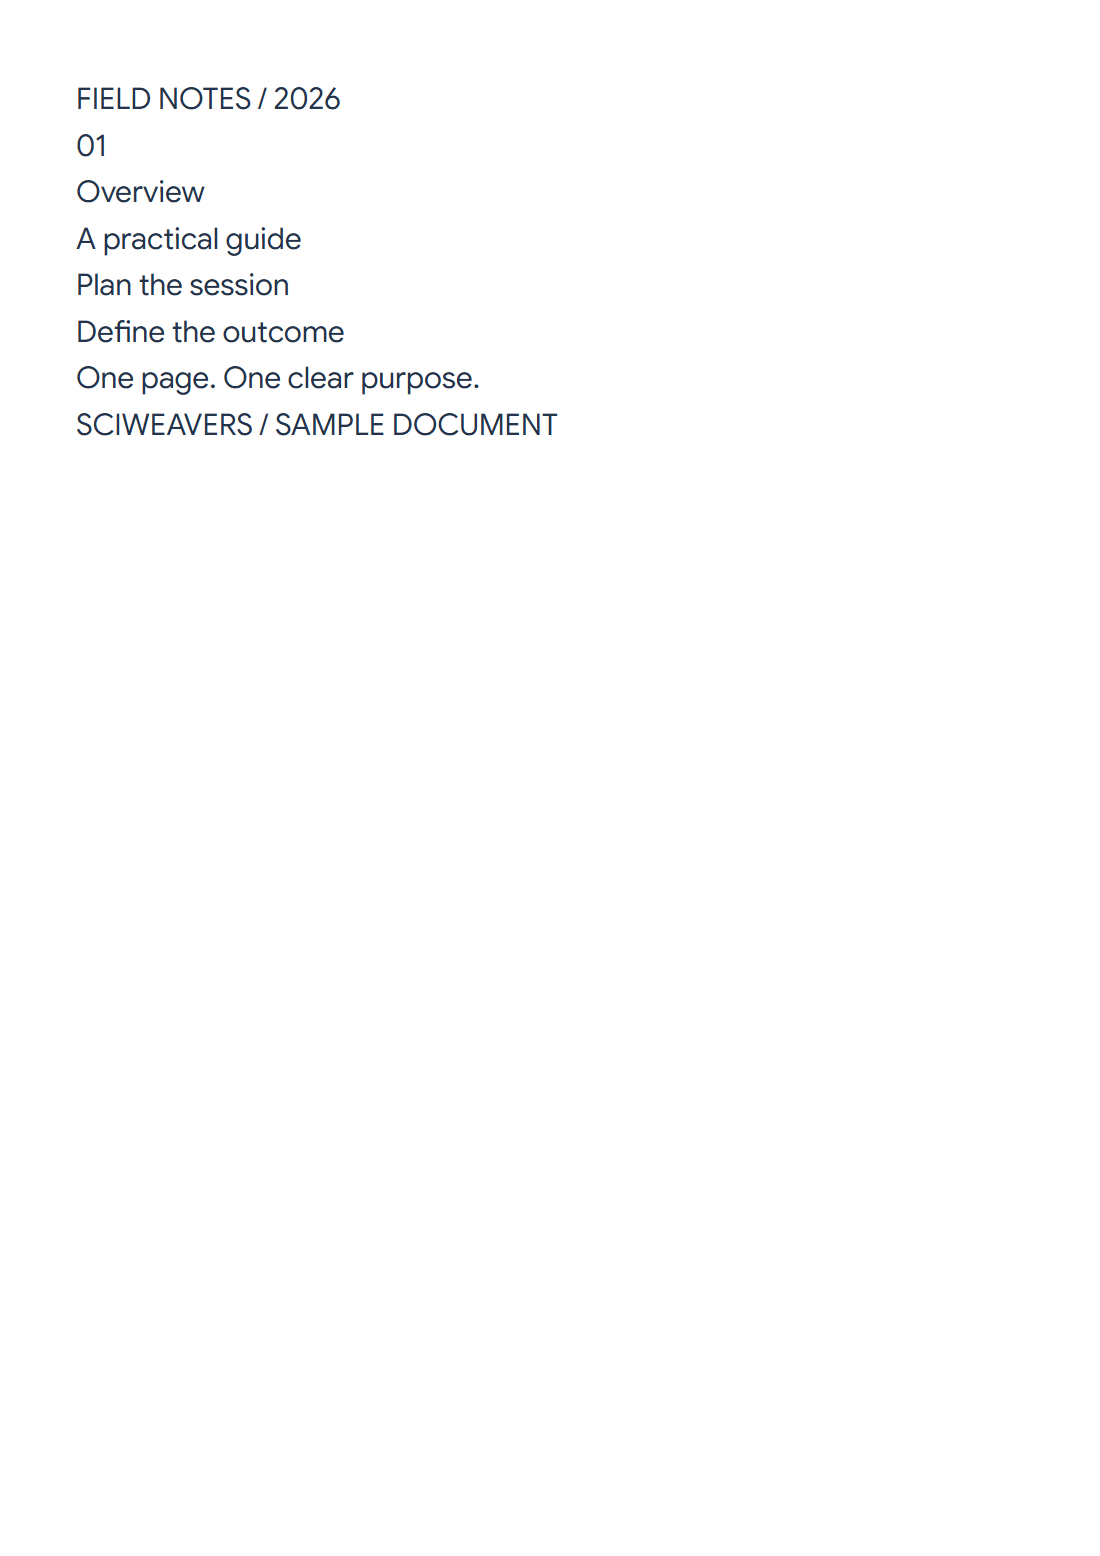

使用 PDF OCR 从页面图像中识别文字。我们的示例从一份四页的纯图像扫描件开始,将其第一页(概述)识别为可编辑文本。
选择页面或区域
加载 PDF 并导航至所需页面。使用整页或在所需文本周围调整选择矩形。本示例使用了第 1 页的全部内容。
其他页面或区域需要单独的识别操作。该工具不会自动处理上传 PDF 的每一页。
若扫描件模糊或带有标记,请选择页面预览上方的 增强图像。您可以调整亮度、对比度或进行背景清理;使用橡皮擦或绘制矩形来清除不需要的标记。对比 原始 和 已增强,然后选择 应用更改。编辑仅适用于当前页面。在开始 OCR 之前,请检查您的选择。
选择语言、引擎和格式
选择页面上印刷的语言。对于我们的英语示例,保持 Future 作为 OCR 引擎,并选择 可编辑文本 (.txt)。
当您需要可搜索的 PDF 时,请选择 Classic,它会保留原始图像并添加一个不可见的识别文本层。Future 提供可编辑文本、Word 以及重排后的纯文本 PDF。
识别、校对并下载
选择 开始 并完成显示的验证复选框。将识别结果与原始图像进行比对。我们的下载内容正确包含了“概述”、“规划会议”和“定义结果”。
在复制或下载文本之前,请更正名称、数字和不确定的词汇。更正内容会更新可编辑的导出文件;Classic 的定位搜索 PDF 保留了原始识别结果,因此请单独检查该文件。
使用智能编辑润色识别出的文本
对于 TXT 或 Word 结果,请选择 智能编辑(位于 复制 旁边)。选择一段文字进行处理,或不选择任何内容以处理整个草稿。选择 总结文本、改写文本、修正语法 或 建议标题,然后选择 应用。标题操作会在文本上方添加一个标题。
请对照扫描件检查每一处 AI 修改,特别是姓名、数字和遗漏的单词。建议内容会保留在 智能编辑 中,直到您选择 应用更改。TXT 和 Word 下载随后会使用编辑后的纯文本。智能编辑 默认下载 Word (.docx);如需其他格式的副本,请选择 PDF 或 HTML。原始扫描件和 经典 可搜索的 PDF 文本层不会发生变化。
常见问题
我可以只识别一个段落吗?
可以。在开始之前,在它周围选择一个矩形。检查边缘,确保附近的文本被排除在外,且重要的词汇没有被截断。
Future 会在 PDF 中保留原始页面设计吗?
其 PDF 是重排后的纯文本文件。当目的是保留带有文本层的扫描页面图像时,请选择 Classic 的可搜索 PDF。
智能编辑可以更改可搜索的 PDF 吗?
不能。智能编辑适用于 TXT 和 Word 结果。“应用更改”会更新可编辑文本;它不会重写扫描页面或之前生成的搜索 PDF。
用您的文档试一试
检查结果,然后保存您需要的版本。


