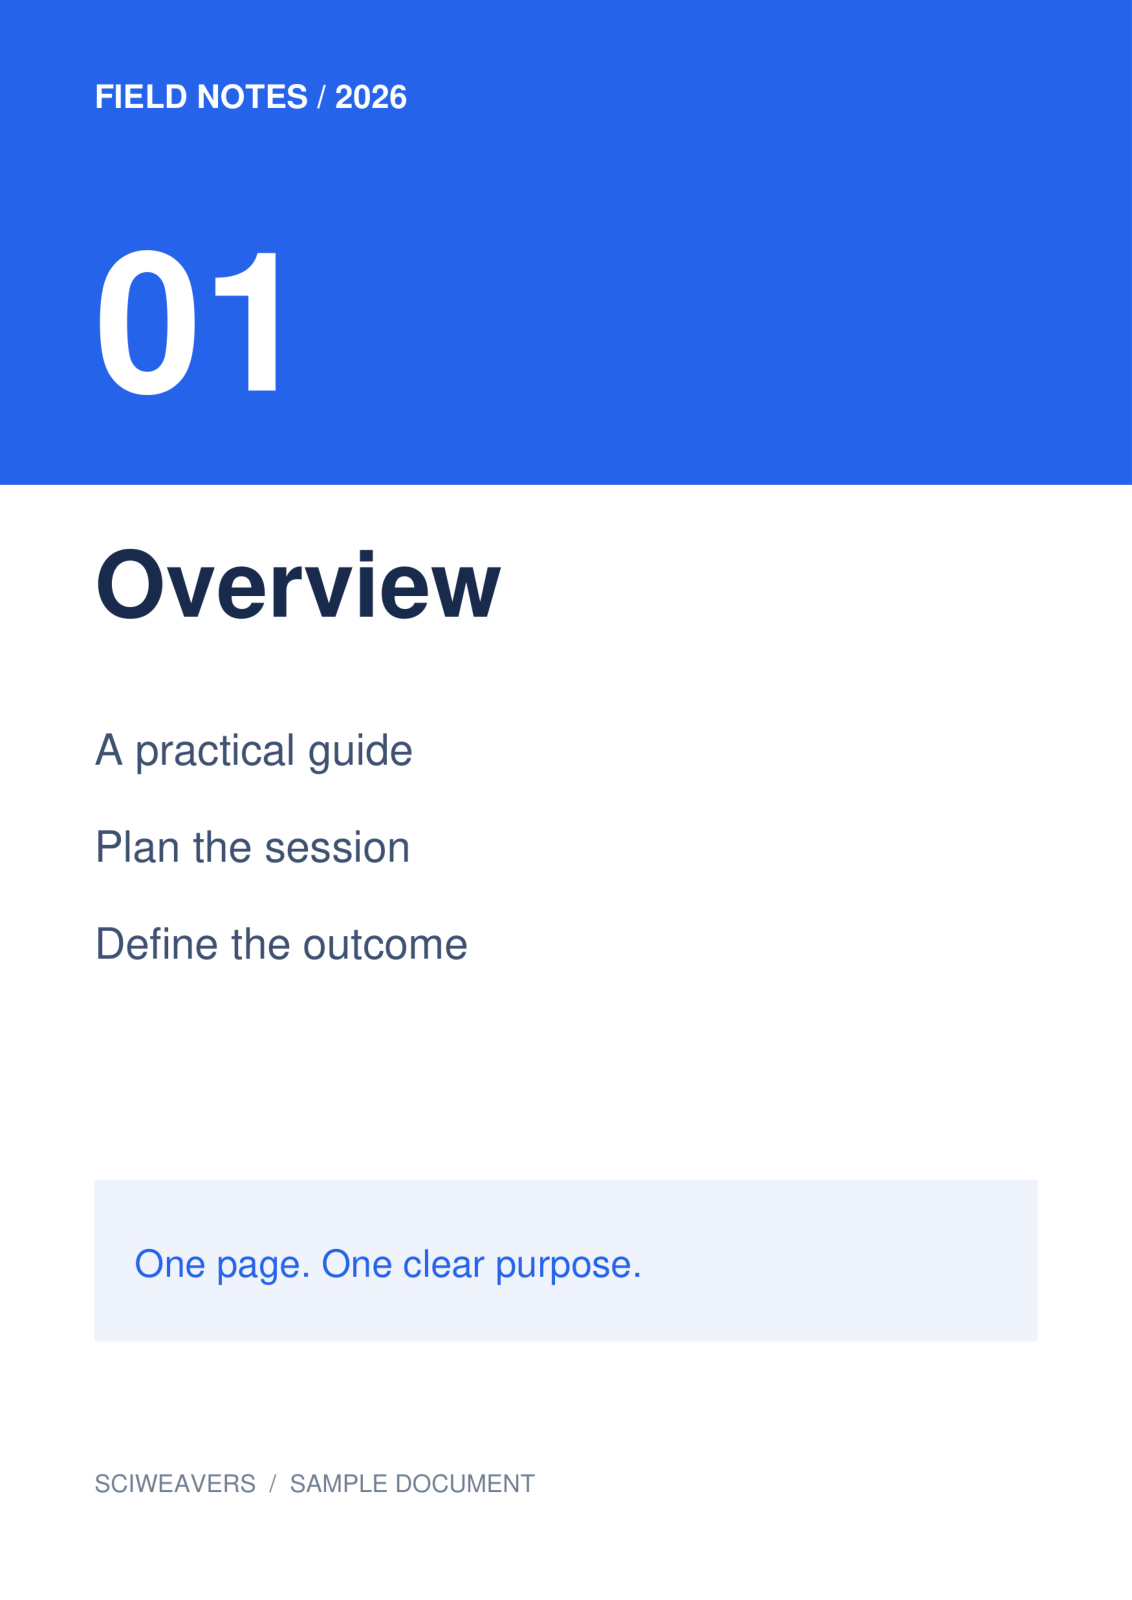
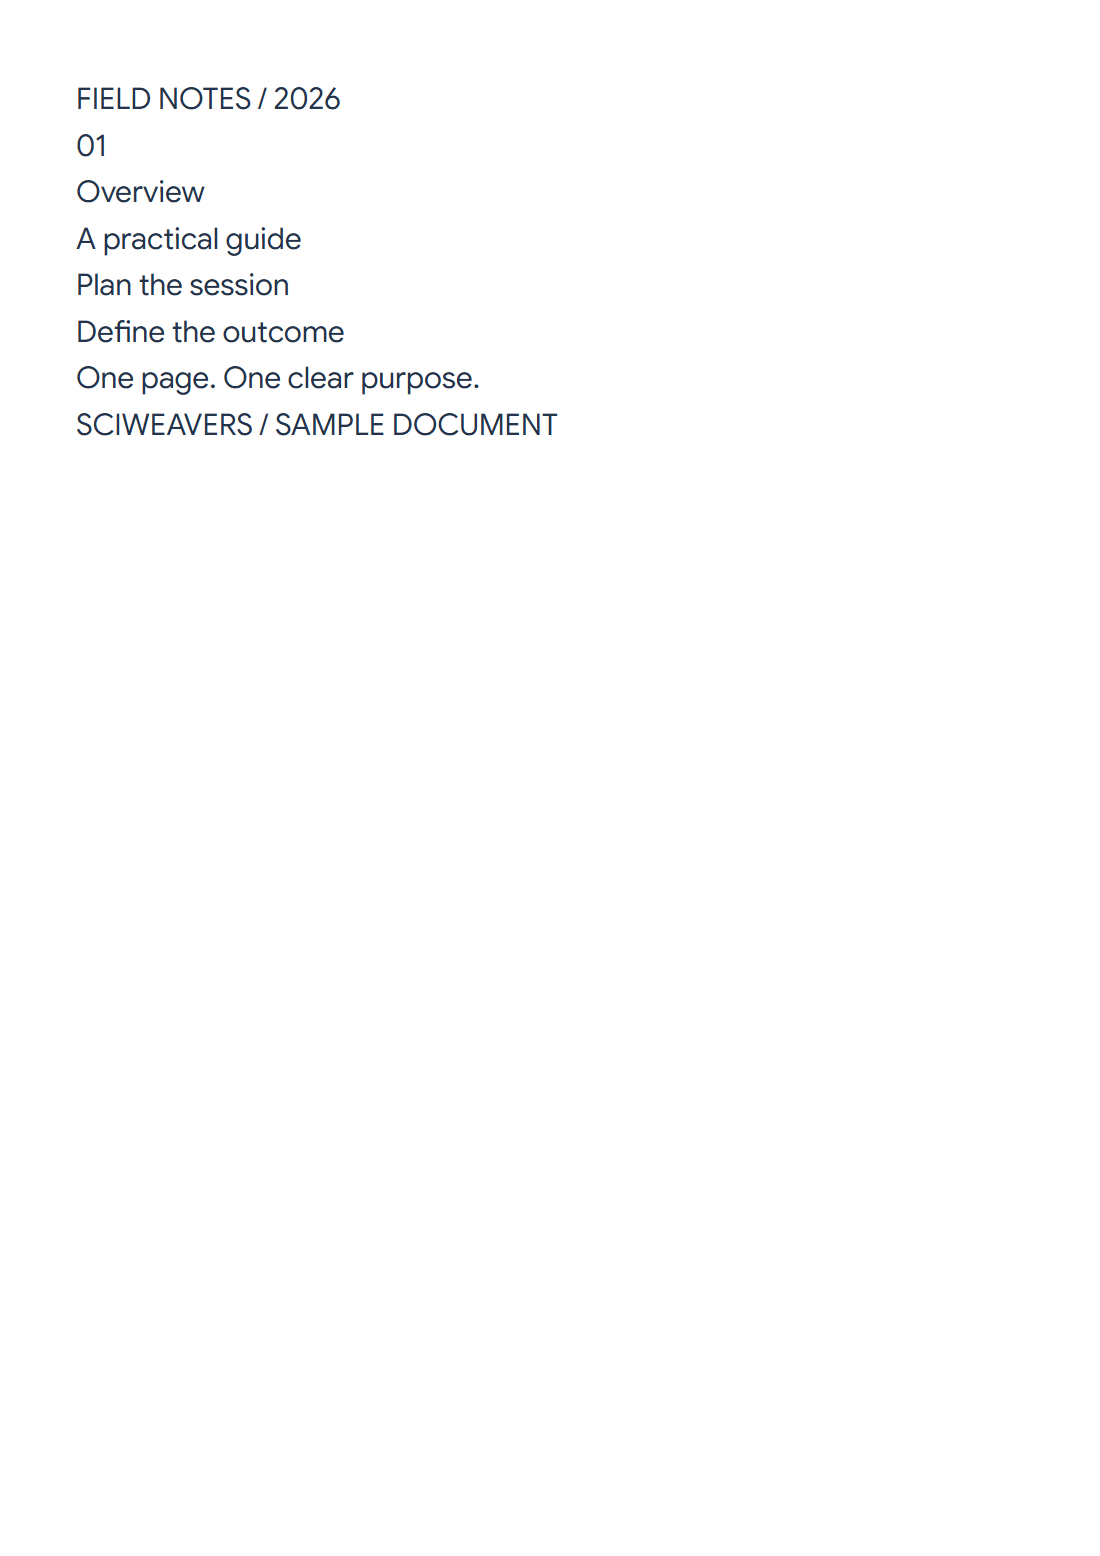

PDF OCRを使用して、画像化されたページから単語を認識します。この例では、4ページの画像のみのPDFスキャンから開始し、その1ページ目である「概要」を編集可能なテキストとして認識します。
ページまたは範囲を選択
PDFを読み込み、必要なページに移動します。ページ全体を使用するか、必要なテキストの周囲に選択範囲を調整します。この例では1ページ全体を使用しています。
別のページや領域を処理するには、個別の認識操作が必要です。このツールは、アップロードされたPDFのすべてのページを自動的に処理するわけではありません。
言語、エンジン、形式を選択
ページに印刷されている言語を選択します。英語のサンプルの場合は、OCRエンジンとしてFutureを維持し、編集可能なテキスト (.txt)を選択してください。
検索可能なPDFが必要な場合はClassicを選択してください。これは元の画像を保持し、その上に不可視の認識テキストレイヤーを重ねます。Futureは、編集可能なテキスト、Word、およびリフロー可能なテキストのみのPDFを提供します。
認識、修正、ダウンロード
開始を選択し、表示された確認チェックボックスを完了してください。認識結果と元の画像を比較します。ダウンロードには「Overview」、「Plan the session」、「Define the outcome」が正しく含まれています。
テキストをコピーまたはダウンロードする前に、名前、数字、不確かな単語を修正してください。修正内容は編集可能なエクスポートに反映されます。Classicの検索可能なPDFは元の認識結果を保持するため、そのファイルは別途確認してください。
「スマート編集」で認識されたテキストを調整
TXTまたはWord形式の結果を得るには、コピーの横にあるスマート編集を選択します。テキストの一部を選択して作業するか、何も選択せずにドラフト全体を使用します。テキストを要約、テキストを言い換え、文法を修正、またはタイトルを提案を選択し、適用をクリックします。タイトルアクションはテキストの上にヘッダーを追加します。
AIによる変更は、特に名前、数字、欠落している単語について、スキャン画像と照らし合わせてすべて確認してください。提案内容は変更を適用を選択するまでスマート編集内に保持されます。TXTおよびWordのダウンロードでは、編集済みのプレーンテキストが使用されます。書式付きコピーはエディタのスタイルを適用した別のHTMLファイルをダウンロードします。元のスキャン画像およびClassicの検索可能なPDFのテキストレイヤーは変更されません。
よくある質問
特定の段落のみを認識することはできますか?
はい。開始する前に、対象の周囲を長方形で選択してください。周囲のテキストが含まれず、重要な単語が切り取られないように端を確認してください。
FutureはPDFの元のページデザインを保持しますか?
そのPDFは、テキストのみを再構成したドキュメントです。スキャンしたページ画像とテキストレイヤーを保持することが目的の場合は、Classicの検索可能なPDFを選択してください。
スマート編集で検索可能なPDFを変更できますか?
いいえ。スマート編集はTXTおよびWord形式の結果で利用可能です。「変更を適用」は編集可能なテキストを更新するものであり、スキャンされたページや以前に生成された検索可能なPDFを書き換えるものではありません。
お手元のドキュメントでお試しください
結果を確認し、必要なバージョンを保存してください。