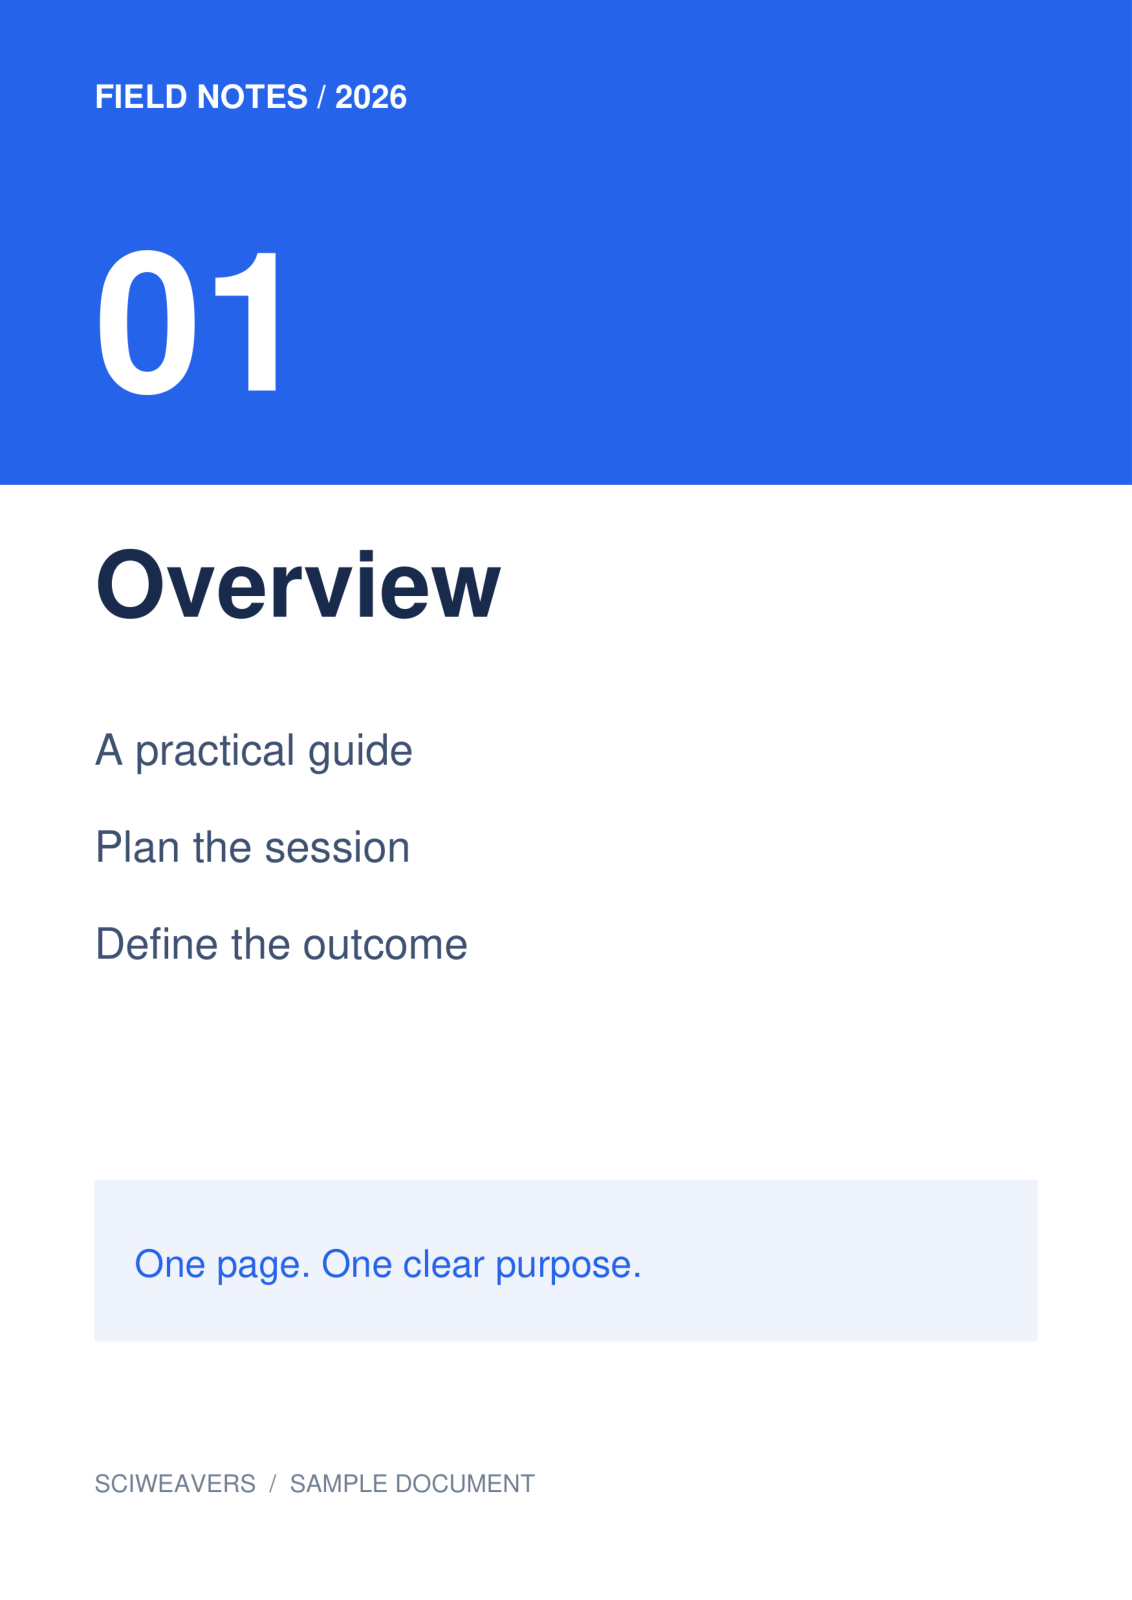
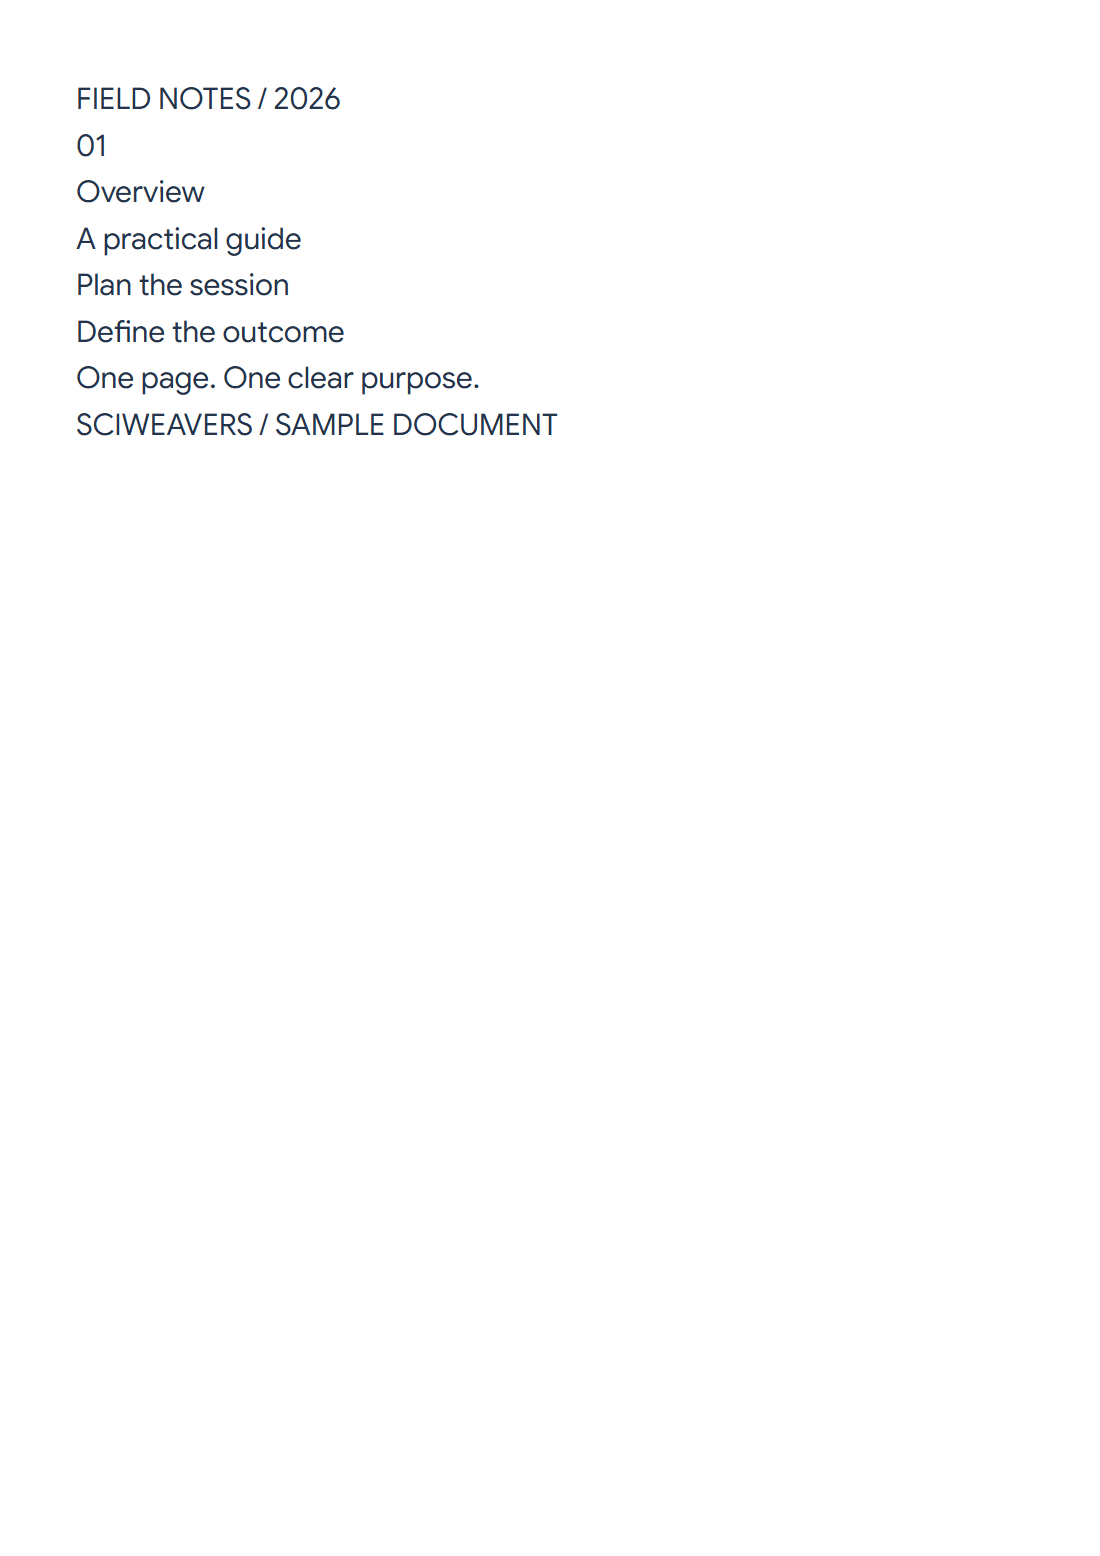

Verwenden Sie PDF OCR, um Wörter aus Seitenbildern zu erkennen. Unser Beispiel beginnt mit einem vierseitigen Scan, der nur aus Bildern besteht, und erkennt dessen erste Seite, Overview, als bearbeitbaren Text.
Wählen Sie eine Seite oder einen Bereich
Laden Sie das PDF und navigieren Sie zu der benötigten Seite. Verwenden Sie die ganze Seite oder passen Sie ein Auswahlrechteck um den benötigten Text an. Das Beispiel verwendet die gesamte Seite 1.
Eine weitere Seite oder ein weiterer Bereich erfordert einen separaten Erkennungsvorgang. Das Tool verarbeitet nicht automatisch jede Seite des hochgeladenen PDFs.
Wählen Sie Sprache, Engine und Format
Wählen Sie die auf der Seite gedruckte Sprache aus. Behalten Sie für unser englisches Beispiel Future als OCR-Engine bei und wählen Sie Bearbeitbarer Text (.txt).
Wählen Sie Classic, wenn Sie ein durchsuchbares PDF benötigen, das das Quellbild mit einer unsichtbaren Ebene aus erkanntem Text beibehält. Future bietet bearbeitbaren Text, Word und ein neu umgebrochenes PDF, das nur Text enthält.
Erkennen, korrigieren und herunterladen
Wählen Sie Start und füllen Sie das angezeigte Bestätigungs-Kontrollkästchen aus. Vergleichen Sie das erkannte Ergebnis mit dem Quellbild. Unser Download enthält korrekt Overview, Plan the session und Define the outcome.
Korrigieren Sie Namen, Zahlen und unsichere Wörter, bevor Sie den Text kopieren oder herunterladen. Korrekturen aktualisieren bearbeitbare Exporte; das positionierte, durchsuchbare PDF von Classic behält die ursprüngliche Erkennung bei, überprüfen Sie diese Datei daher separat.
Verfeinern Sie den erkannten Text mit Smart Edit
Für ein TXT- oder Word-Ergebnis wählen Sie Smart edit neben Copy. Wählen Sie eine Passage aus, um an diesem Text zu arbeiten, oder lassen Sie nichts ausgewählt, um den gesamten Entwurf zu verwenden. Wählen Sie Summarize text, Paraphrase text, Fix grammar oder Suggest a title und wählen Sie dann Apply. Die Titel-Aktion fügt eine Überschrift über dem Text hinzu.
Überprüfen Sie jede KI-Änderung anhand des Scans, insbesondere Namen, Zahlen und fehlende Wörter. Der Vorschlag bleibt in Smart Edit, bis Sie Apply Changes wählen. TXT- und Word-Downloads verwenden dann den bearbeiteten Klartext. Formatted copy lädt eine separate HTML-Datei mit Editor-Formatierung herunter; der ursprüngliche Scan und die Textebene des durchsuchbaren Classic-PDFs ändern sich nicht.
Häufige Fragen
Kann ich nur einen Absatz erkennen?
Ja. Wählen Sie vor dem Start ein Rechteck darum aus. Überprüfen Sie die Ränder, damit nahegelegener Text ausgeschlossen wird und wichtige Wörter nicht abgeschnitten werden.
Behält Future das ursprüngliche Seitenlayout in seinem PDF bei?
Das PDF ist ein neu umgebrochenes Dokument, das nur Text enthält. Wählen Sie das durchsuchbare PDF von Classic, wenn es darum geht, das gescannte Seitenbild mit einer Textebene beizubehalten.
Kann Smart Edit das durchsuchbare PDF ändern?
Nein. Smart Edit ist mit TXT- und Word-Ergebnissen verfügbar. Apply Changes aktualisiert den bearbeitbaren Text; es schreibt weder die gescannte Seite noch ein zuvor generiertes durchsuchbares PDF um.
Probieren Sie es mit Ihrem Dokument aus
Überprüfen Sie das Ergebnis und speichern Sie dann die benötigte Version.