Finance in operacije
Premaknite tabele poročil v preglednice
Ekstrahirajte finančne ali operativne tabele, nato preverite vsote, decimalna ločila in meje stolpcev.
Spremenite tabele PDF v ureljive Wordove tabele, preglednice in podatke za ponovno uporabo. Samodejno zaznajte tabele ali narišite svoja območja.
Izberite tabelo za predogled njenih celic. Uporabite Nariši tabele za dodajanje območja; povlecite izbrane okvirje ali njihove ročaje, da jih prilagodite.
Izberite tabelo na strani ali na seznamu, da preberete njene celice.
Pred prenosom preverite ekstrahirane celice. Kompleksne ali združene postavitve bodo morda potrebovale prilagoditve.
Prenesite svoje ekstrahirane tabele. Vaš izvirni PDF ostane nespremenjen.
Odprite en PDF, nato kliknite Zaznaj tabele za to stran ali vse strani. Prav tako lahko narišete svoja območja tabel.
Preglejte predogled celic, narišite ali prilagodite območja in izberite tabele, ki jih potrebujete.
Prenesite urejevalne Wordove tabele, Excelov delovni zvezek ali podatke tabele za ponovno uporabo.
Samodejno poiščite tabele v PDF-ju, ki ga je mogoče izbrati, ali narišite pravokotnik okoli vsake tabele. Preglejte ekstrahirane celice, izberite tabele za vključitev in nato izvozite v Word, Excel, CSV, TXT, HTML, JSON ali XML.
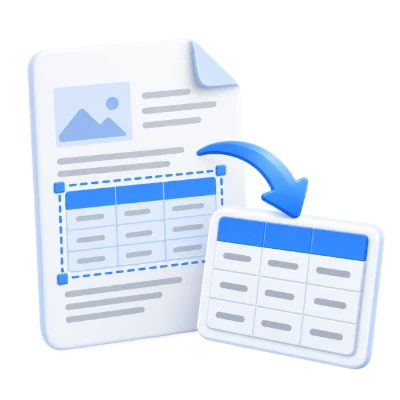
Ekstrahirajte finančne ali operativne tabele, nato preverite vsote, decimalna ločila in meje stolpcev.
Izberite samo tabele, ki jih potrebujete, in pred analizo primerjajte izvožene celice z izvornim PDF-jem.
Izberite CSV, JSON ali XML za kasnejšo obdelavo po pregledu zaznanih vrstic in stolpcev.
Zaženite zaznavanje za to stran ali vse strani, ali narišite ločen pravokotnik okoli vsake tabele.
Odpiranje datoteke PDF je ne skenira za tabele. Izberite To stran ali Vse strani in kliknite Zaznaj tabele, ko ste pripravljeni. Samodejno zaznavanje najprej išče črtane tabele in uporablja poravnavo besedila na straneh, kjer ni najdenih črtanih tabel. Izberite tabelo, da naložite njene ekstrahirane celice pod PDF-om. Označite ali odznačite tabele za nadzor izvoza.
V načinu Risanje tabel povlecite okoli vsake tabele. Obstoječe polje lahko premaknete ali spremenite njegovo velikost, dodate območja na drugih straneh, izbrišete območje in razveljavite spremembe. Knjižnica zazna celice znotraj vsakega pravokotnika; ni fiksne, enakomerno razporejene mreže. Za izbiro s tipkovnico se osredotočite na območje strani in pritisnite N za dodajanje regije, uporabite puščice za premikanje, Shift in puščice za spreminjanje velikosti ali Delete za odstranitev.
Prenesite Word, Excel, CSV, TXT, HTML, JSON ali XML, ali kopirajte tabelo v odložišče.
Word ustvari ureljive tabele in lahko vsako tabelo postavi na novo stran. Excel uporablja en delovni list na tabelo. CSV, TXT, HTML, JSON in XML lahko združijo izbrane tabele ali prenesejo ločene datoteke znotraj ZIP-a. Kopiranje tabele uporablja celice, ločene s tabulatorji, za preglednice.
Predogledi in izvozi tabel uporabljajo enako ekstrakcijo besedila. Word ohranja prvotne širine stolpcev, pisave in postavitev od desne proti levi, kjer je to podprto, namesto da vsiljuje enako velike stolpce. Manjkajoče preslikave pisav, nenavaden vrstni red branja ter zapletene ali združene celice lahko še vedno vplivajo na rezultat. Pred uporabo preglejte predogled in izvožene vrednosti.
Izvleček besedila bere besedilno plast; ne prepoznava črk v slikah.
Izvleček uporablja obstoječo besedilno plast in ne prepoznava črk v slikah strani. Če stran nima berljivega besedila, uporabite PDF OCR ločeno. Prazna stran prav tako morda ne bo dala besedila. Pri mešanih PDF-jih preglejte prazne ali neberljive strani posamično. OCR obdela eno izbrano stran naenkrat.
Uporabite sprejeto obliko in z dokumentom hranite zahtevane vire.
Pripona imena datoteke se mora ujemati z dejansko vrsto datoteke. Preimenovanje nepovezane datoteke je ne pretvori. Hranite vse zahtevane vire na voljo v dokumentu in uporabite nešifrirano datoteko, za katero ste pooblaščeni za obdelavo. Obdelava lahko ne uspe pri poškodovani, nepodprti ali nenavadno zapleteni vsebini, tudi če je njena velikost v bajtih znotraj omejitve za nalaganje.
Odprite en PDF do 50 MB in 750 strani. Za kompleksne dokumente lahko veljajo dodatne omejitve izhoda, pomnilnika in obdelave.
Obdelava uporablja naše strežnike. Izvorne datoteke, začasne datoteke in rezultati se izbrišejo z naših strežnikov v 30 minutah po končani obdelavi. Vsebine dokumentov ne delimo s tretjimi osebami in jih ne uporabljamo za usposabljanje modelov umetne inteligence.
Vedite, kaj pričakovati, preden začnete.
Začasna obdelava na strežnikuOdpiranje datoteke PDF je ne skenira za tabele. Izberite To stran ali Vse strani in kliknite Zaznaj tabele, ko ste pripravljeni. Samodejno zaznavanje najprej išče tabele z robovi in uporablja poravnavo besedila na straneh, kjer ni najdenih tabel z robovi. Izberite tabelo, da naložite njene pridobljene celice pod PDF-om. Označite ali odznačite tabele za nadzor izvoza.
Word ustvari ureljive tabele in lahko vsako tabelo postavi na novo stran. Excel uporablja en delovni list na tabelo. CSV, TXT, HTML, JSON in XML lahko združijo izbrane tabele ali prenesejo ločene datoteke v ZIP arhivu. Kopiranje tabele uporablja celice, ločene s tabulatorji, za preglednice.
Ekstrakcija uporablja obstoječo plast besedila in ne prepoznava črk na slikah strani. Če stran nima berljivega besedila, uporabite ločeno funkcijo PDF OCR. Prazna stran prav tako ne ustvari besedila. Pri mešanih datotekah PDF preglejte prazne ali neberljive strani posamično. OCR obdela eno izbrano stran naenkrat.
Odprite en PDF do 50 MB in 750 izvornih strani. Zaščitene datoteke potrebujejo odklenjeno kopijo, razen če to orodje izrecno ponuja vnos gesla. Velike ali zapletene strani lahko zahtevajo več pomnilnika ali dosežejo omejitve obdelave, tudi če je datoteka znotraj teh omejitev.
To orodje za obdelavo uporablja naše strežnike. Vaša izvirna datoteka ni prepisana; rezultat je ločen prenos. Predogled in pregled rezultatov sta na voljo, kjer je to mogoče, kopijo pa prenesite, preden začnete znova.