Finanzas y operaciones
Mover tablas de informes a hojas de cálculo
Extraiga tablas financieras u operativas, luego verifique los totales, separadores decimales y límites de columna.


Convierta tablas de PDF en tablas de Word editables, hojas de cálculo y datos reutilizables. Detecte tablas automáticamente o dibuje sus propias áreas.
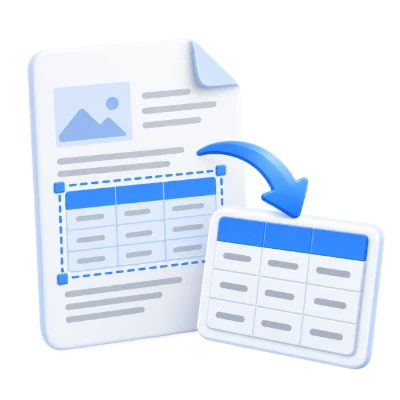
Seleccione una tabla para previsualizar sus celdas. Utilice Dibujar tablas para añadir un área; arrastre los cuadros seleccionados o sus controladores para ajustarlos.
Seleccione una tabla en la página o en la lista para leer sus celdas.
Compruebe las celdas extraídas antes de descargar. Los diseños complejos o combinados pueden necesitar ajustes.
Descargue sus tablas extraídas. Su PDF original permanece sin cambios.
Abra un PDF y luego haga clic en Detectar tablas para esta página o todas las páginas. También puede dibujar sus propias áreas de tabla.
Inspeccione la vista previa de la celda, dibuje o ajuste las áreas y seleccione las tablas que necesita.
Descargue tablas de Word editables, un libro de Excel o datos de tabla reutilizables.
Encuentre tablas automáticamente en todo un PDF seleccionable, o dibuje un rectángulo alrededor de cada tabla. Revise las celdas extraídas, elija qué tablas incluir y luego exporte a Word, Excel, CSV, TXT, HTML, JSON o XML.
Extraiga tablas financieras u operativas, luego verifique los totales, separadores decimales y límites de columna.
Seleccione solo las tablas que necesita y compare las celdas exportadas con el PDF de origen antes del análisis.
Elija CSV, JSON o XML para su posterior procesamiento después de revisar las filas y columnas detectadas.
Inicie la detección para esta página o todas las páginas, o dibuje un rectángulo separado alrededor de cada tabla.
Abrir un PDF no lo escanea en busca de tablas. Elija Esta página o Todas las páginas y haga clic en Detectar tablas cuando esté listo. La detección automática busca primero tablas con líneas y utiliza la alineación de texto en las páginas donde no se encuentran tablas con líneas. Seleccione una tabla para cargar sus celdas extraídas debajo del PDF. Marque o desmarque las tablas para controlar la exportación.
En el modo Dibujar tablas, arrastre alrededor de cada tabla. Puede mover o cambiar el tamaño de un cuadro existente, agregar áreas en otras páginas, eliminar un área y deshacer cambios. La biblioteca detecta celdas dentro de cada rectángulo; no hay una cuadrícula fija y espaciada uniformemente. Para la selección con teclado, enfoque el área de la página y presione N para agregar una región, use las flechas para moverla, Shift y las flechas para cambiar su tamaño, o Suprimir para eliminarla.
Descargue Word, Excel, CSV, TXT, HTML, JSON o XML, o copie una tabla al portapapeles.
Word crea tablas editables y puede colocar cada tabla en una página nueva. Excel utiliza una hoja de cálculo por tabla. CSV, TXT, HTML, JSON y XML pueden combinar tablas seleccionadas o descargar archivos separados dentro de un ZIP. Copiar tabla utiliza celdas separadas por tabulaciones para hojas de cálculo.
Las vistas previas y exportaciones de tablas utilizan la misma extracción de texto. Word conserva los anchos de columna, fuentes y diseño de derecha a izquierda originales donde sea compatible, en lugar de forzar columnas de igual tamaño. Los mapeos de fuentes faltantes, el orden de lectura inusual y las celdas complejas o combinadas aún pueden afectar el resultado. Revise la vista previa y los valores exportados antes de usarlos.
La extracción de texto lee una capa de texto; no reconoce letras en imágenes.
La extracción utiliza una capa de texto existente y no reconoce letras en las imágenes de la página. Si una página no tiene texto legible, usa PDF OCR por separado. Una página en blanco también puede no producir texto. Para PDFs mixtos, inspecciona las páginas vacías o ilegibles individualmente. El OCR procesa una página seleccionada a la vez.
Utilice el formato aceptado y mantenga los recursos necesarios con el documento.
La extensión del nombre de archivo debe coincidir con el tipo de archivo real. Cambiar el nombre de un archivo no relacionado no lo convierte. Mantenga los recursos necesarios disponibles dentro del documento y utilice un archivo sin cifrar que esté autorizado a procesar. El procesamiento puede fallar con contenido dañado, no compatible o inusualmente complejo, incluso cuando su tamaño en bytes esté dentro del límite de carga.
Abra un PDF de hasta 50 MB y 750 páginas fuente. Los archivos protegidos necesitan una copia desbloqueada a menos que esta herramienta ofrezca explícitamente la entrada de contraseña. Las páginas grandes o complejas pueden requerir más memoria o alcanzar límites de procesamiento incluso cuando el archivo está dentro de estos límites.
El procesamiento utiliza nuestros servidores. Los archivos de origen, los archivos temporales y los resultados se eliminan de nuestros servidores en un plazo de 30 minutos tras finalizar el procesamiento. No compartimos el contenido de los documentos con terceros ni los utilizamos para entrenar modelos de IA.
Sabe qué esperar antes de empezar.
Procesamiento temporal en servidorAbrir un PDF no lo escanea en busca de tablas. Elija Esta página o Todas las páginas y haga clic en Detectar tablas cuando esté listo. La detección automática busca primero tablas regladas y utiliza la alineación de texto en las páginas donde no se encuentran tablas regladas. Seleccione una tabla para cargar sus celdas extraídas debajo del PDF. Marque o desmarque las tablas para controlar la exportación.
Word crea tablas editables y puede poner cada tabla en una página nueva. Excel utiliza una hoja de cálculo por tabla. CSV, TXT, HTML, JSON y XML pueden combinar tablas seleccionadas o descargar archivos separados dentro de un ZIP. Copiar tabla utiliza celdas separadas por tabulaciones para hojas de cálculo.
La extracción utiliza una capa de texto existente y no reconoce letras en imágenes de página. Si una página no tiene texto legible, use PDF OCR por separado. Una página en blanco también puede no producir texto. Para PDF mixtos, inspeccione las páginas vacías o ilegibles individualmente. OCR procesa una página seleccionada a la vez.
Abra un PDF de hasta 50 MB y 750 páginas fuente. Los archivos protegidos necesitan una copia desbloqueada a menos que esta herramienta ofrezca explícitamente la entrada de contraseña. Las páginas grandes o complejas pueden requerir más memoria o alcanzar límites de procesamiento incluso cuando el archivo está dentro de estos límites.
Esta herramienta utiliza nuestros servidores para el procesamiento. Tu archivo original no se sobrescribe; el resultado es una descarga independiente. Previsualiza y revisa el resultado cuando esté disponible, y descarga la copia que necesites antes de empezar de nuevo.