Finanțe și operațiuni
Mutați tabelele de raport în foi de calcul
Extrageți tabele financiare sau operaționale, apoi verificați totalurile, separatoarele zecimale și limitele coloanelor.


Transformați tabelele PDF în tabele Word editabile, foi de calcul și date reutilizabile. Detectați tabelele automat sau desenați propriile zone.
Selectați un tabel pentru a previzualiza celulele sale. Folosiți „Desenează tabele” pentru a adăuga o zonă; trageți casetele selectate sau mânerele acestora pentru a le ajusta.
Selectați un tabel de pe pagină sau din listă pentru a-i citi celulele.
Verificați celulele extrase înainte de descărcare. Aspectele complexe sau îmbinate pot necesita ajustări.
Descărcați tabelele extrase. PDF-ul original rămâne neschimbat.
Deschideți un PDF, apoi faceți clic pe „Detectare tabele” pentru această pagină sau pentru toate paginile. De asemenea, puteți desena propriile zone de tabel.
Inspectați previzualizarea celulelor, desenați sau ajustați zonele și selectați tabelele de care aveți nevoie.
Descărcați tabele Word editabile, un registru de lucru Excel sau date de tabel reutilizabile.
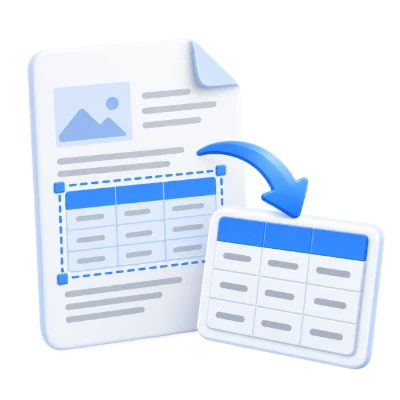
Găsiți tabele automat într-un PDF selectabil sau desenați un dreptunghi în jurul fiecărui tabel. Examinați celulele extrase, alegeți ce tabele să includeți, apoi exportați în Word, Excel, CSV, TXT, HTML, JSON sau XML.
Extrageți tabele financiare sau operaționale, apoi verificați totalurile, separatoarele zecimale și limitele coloanelor.
Selectați doar tabelele de care aveți nevoie și comparați celulele exportate cu PDF-ul sursă înainte de analiză.
Alegeți CSV, JSON sau XML pentru procesare ulterioară după examinarea rândurilor și coloanelor detectate.
Pornește detectarea pentru această pagină sau pentru toate paginile, sau desenează un dreptunghi separat în jurul fiecărui tabel.
Deschiderea unui PDF nu îl scanează pentru tabele. Alege Această pagină sau Toate paginile și dă clic pe Detectează tabele când ești gata. Detectarea automată caută mai întâi tabelele cu linii și utilizează alinierea textului pe paginile unde nu sunt găsite tabele cu linii. Selectează un tabel pentru a încărca celulele extrase sub PDF. Bifează sau debifează tabelele pentru a controla exportul.
În modul Desenează tabele, trage în jurul fiecărui tabel. Poți muta sau redimensiona o casetă existentă, poți adăuga zone pe alte pagini, poți șterge o zonă și poți anula modificările. Biblioteca detectează celulele din interiorul fiecărui dreptunghi; nu există o grilă fixă, egal spațiată. Pentru selecția de la tastatură, concentrează-te pe zona paginii și apasă N pentru a adăuga o regiune, folosește săgețile pentru a o muta, Shift și săgețile pentru a o redimensiona, sau Delete pentru a o elimina.
Descarcă Word, Excel, CSV, TXT, HTML, JSON sau XML, sau copiază un tabel în clipboard.
Word creează tabele editabile și poate pune fiecare tabel pe o pagină nouă. Excel utilizează o foaie de lucru per tabel. CSV, TXT, HTML, JSON și XML pot combina tabelele selectate sau pot descărca fișiere separate într-un ZIP. Copierea tabelului utilizează celule separate prin tab-uri pentru foile de calcul.
Previzualizările și exporturile de tabele utilizează aceeași extracție de text. Word păstrează lățimile originale ale coloanelor, fonturile și aspectul de la dreapta la stânga acolo unde este acceptat, în loc să forțeze coloane de dimensiuni egale. Mapările de fonturi lipsă, ordinea de citire neobișnuită și celulele complexe sau îmbinate pot afecta în continuare rezultatul. Revizuiește previzualizarea și valorile exportate înainte de a le utiliza.
Extracția textului citește un strat de text; aceasta nu recunoaște literele din imagini.
Extracția utilizează un strat de text existent și nu recunoaște literele din imaginile paginilor. Dacă o pagină nu are text lizibil, folosește PDF OCR separat. O pagină goală poate, de asemenea, să nu producă niciun text. Pentru PDF-uri mixte, inspectează individual paginile goale sau ilizibile. OCR procesează câte o pagină selectată pe rând.
Utilizați formatul acceptat și păstrați resursele necesare împreună cu documentul.
Extensia numelui fișierului trebuie să corespundă tipului real de fișier. Redenumirea unui fișier necorelat nu îl convertește. Păstrați orice resurse necesare disponibile în cadrul documentului și utilizați un fișier necriptat pe care sunteți autorizat să îl procesați. Procesarea poate eșua în cazul conținutului deteriorat, nesuportat sau neobișnuit de complex, chiar dacă dimensiunea sa în octeți se încadrează în limita de încărcare.
Deschideți un PDF de până la 50 MB și 750 pagini sursă. Fișierele protejate au nevoie de o copie deblocată, cu excepția cazului în care acest instrument oferă explicit introducerea parolei. Paginile mari sau complexe pot necesita mai multă memorie sau pot atinge limitele de procesare chiar și atunci când fișierul se încadrează în aceste limite.
Procesarea utilizează serverele noastre. Fișierele sursă, fișierele temporare și rezultatele sunt șterse de pe serverele noastre în termen de 30 de minute după finalizarea procesării. Nu partajăm conținutul documentelor cu terțe părți și nu îl folosim pentru a antrena modele AI.
Știți la ce să vă așteptați înainte de a începe.
Procesare temporară pe serverDeschiderea unui PDF nu îl scanează pentru tabele. Alegeți Această pagină sau Toate paginile și faceți clic pe Detectare tabele când sunteți gata. Detectarea automată caută mai întâi tabelele cu linii și utilizează alinierea textului pe paginile unde nu sunt găsite tabele cu linii. Selectați un tabel pentru a încărca celulele extrase sub PDF. Bifați sau debifați tabelele pentru a controla exportul.
Word creează tabele editabile și poate pune fiecare tabel pe o pagină nouă. Excel utilizează o foaie de lucru per tabel. CSV, TXT, HTML, JSON și XML pot combina tabelele selectate sau pot descărca fișiere separate într-o arhivă ZIP. Copierea tabelului utilizează celule separate prin tabulatori pentru foile de calcul.
Extracția utilizează un strat de text existent și nu recunoaște literele din imaginile paginilor. Dacă o pagină nu are text lizibil, utilizați separat OCR PDF. O pagină goală poate, de asemenea, să nu producă niciun text. Pentru PDF-uri mixte, inspectați individual paginile goale sau ilizibile. OCR procesează câte o pagină selectată pe rând.
Deschideți un PDF de până la 50 MB și 750 pagini sursă. Fișierele protejate au nevoie de o copie deblocată, cu excepția cazului în care acest instrument oferă explicit introducerea parolei. Paginile mari sau complexe pot necesita mai multă memorie sau pot atinge limitele de procesare chiar și atunci când fișierul se încadrează în aceste limite.
Acest instrument utilizează serverele noastre pentru procesare. Fișierul original nu este suprascris; rezultatul este o descărcare separată. Previzualizați și verificați rezultatul acolo unde este disponibil și descărcați copia de care aveți nevoie înainte de a începe din nou.