Finans og drift
Flyt rapporttabeller til regneark
Udtræk finansielle eller operationelle tabeller, og verificer derefter totaler, decimalseparatorer og kolontegrænser.
Gør PDF-tabeller til redigerbare Word-tabeller, regneark og genanvendelige data. Find tabeller automatisk eller tegn dine egne områder.
Vælg en tabel for at forhåndsvise dens celler. Brug Tegn tabeller for at tilføje et område; træk i valgte felter eller deres håndtag for at justere dem.
Vælg en tabel på siden eller på listen for at læse dens celler.
Tjek de udtrukne celler før download. Komplekse eller sammenføjede layouts kan kræve justeringer.
Download dine udtrukne tabeller. Din originale PDF forbliver uændret.
Åbn én PDF, og klik derefter på Registrér tabeller for denne side eller alle sider. Du kan også tegne dine egne tabelområder.
Inspicér celle-forhåndsvisningen, tegn eller juster områder, og vælg de tabeller, du har brug for.
Download redigerbare Word-tabeller, en Excel-projektmappe eller genanvendelige tabeldata.
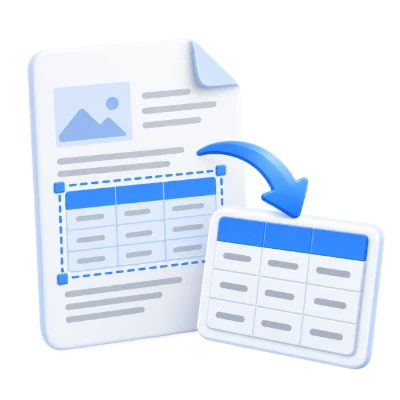
Find tabeller automatisk i en valgbar PDF, eller tegn et rektangel omkring hver tabel. Gennemgå de udtrukne celler, vælg hvilke tabeller der skal inkluderes, og eksporter derefter til Word, Excel, CSV, TXT, HTML, JSON eller XML.
Udtræk finansielle eller operationelle tabeller, og verificer derefter totaler, decimalseparatorer og kolontegrænser.
Vælg kun de tabeller, du har brug for, og sammenlign de eksporterede celler med kilde-PDF'en før analyse.
Vælg CSV, JSON eller XML til senere behandling efter at have gennemgået de detekterede rækker og kolonner.
Start detektering for denne side eller alle sider, eller tegn et separat rektangel omkring hver tabel.
Åbning af en PDF scanner den ikke for tabeller. Vælg Denne side eller Alle sider og klik på Detekter tabeller, når du er klar. Automatisk detektering leder først efter linjebaserede tabeller og bruger tekstjustering på sider, hvor der ikke findes linjebaserede tabeller. Vælg en tabel for at indlæse dens udtrukne celler under PDF'en. Markér eller fjern markeringen af tabeller for at styre eksporten.
I tilstanden Tegn tabeller skal du trække omkring hver tabel. Du kan flytte eller ændre størrelsen på en eksisterende boks, tilføje områder på andre sider, slette et område og fortryde ændringer. Biblioteket detekterer celler inde i hvert rektangel; der er ikke et fast, ligeligt fordelt gitter. For tastaturvalg skal du fokusere på sideområdet og trykke på N for at tilføje et område, bruge piletasterne til at flytte det, Shift og piletasterne til at ændre størrelsen, eller Delete for at fjerne det.
Download Word, Excel, CSV, TXT, HTML, JSON eller XML, eller kopiér en tabel til udklipsholderen.
Word opretter redigerbare tabeller og kan placere hver tabel på en ny side. Excel bruger ét regneark pr. tabel. CSV, TXT, HTML, JSON og XML kan kombinere valgte tabeller eller downloade separate filer i en ZIP-fil. Kopiér tabel bruger tabulatorseparerede celler til regneark.
Tabelvisninger og eksporter bruger den samme tekstudtrækning. Word bevarer de originale kolonnebredder, skrifttyper og layout fra højre mod venstre, hvor det understøttes, i stedet for at tvinge kolonner med samme størrelse. Manglende skrifttype-mappings, usædvanlig læserækkefølge og komplekse eller sammenflettede celler kan stadig påvirke resultatet. Gennemse forhåndsvisningen og de eksporterede værdier, før du bruger dem.
Tekstudtrækning læser et tekstlag; den genkender ikke bogstaver i billeder.
Udtrækning bruger et eksisterende tekstlag og genkender ikke bogstaver i sidebilleder. Hvis en side ikke har læsbar tekst, skal du bruge PDF OCR separat. En blank side kan også resultere i ingen tekst. For blandede PDF'er skal du inspicere tomme eller ulæselige sider individuelt. OCR behandler én valgt side ad gangen.
Brug det accepterede format og behold de nødvendige ressourcer sammen med dokumentet.
Filnavnets endelse skal matche den faktiske filtype. Omdøbning af en ikke-relateret fil konverterer den ikke. Hold alle nødvendige ressourcer tilgængelige i dokumentet, og brug en ukrypteret fil, som du har tilladelse til at behandle. Behandling kan mislykkes ved beskadiget, ikke-understøttet eller usædvanligt komplekst indhold, selv når dens byte-størrelse er inden for upload-grænsen.
Åbn én PDF på op til 50 MB og 750 sider. Yderligere grænser for output, hukommelse og behandling kan gælde for komplekse dokumenter.
Behandlingen bruger vores servere. Kildefiler, midlertidige filer og resultater slettes fra vores servere inden for 30 minutter efter, at behandlingen er afsluttet. Vi deler ikke dokumentindhold med tredjeparter eller bruger det til at træne AI-modeller.
Vid hvad du kan forvente, før du starter.
Midlertidig serverbehandlingÅbning af en PDF scanner den ikke for tabeller. Vælg Denne side eller Alle sider og klik på Registrer tabeller, når du er klar. Automatisk registrering leder først efter linjebaserede tabeller og bruger tekstjustering på sider, hvor der ikke findes linjebaserede tabeller. Vælg en tabel for at indlæse dens udtrukne celler under PDF'en. Marker eller fjern markering af tabeller for at styre eksporten.
Word opretter redigerbare tabeller og kan placere hver tabel på en ny side. Excel bruger ét regneark pr. tabel. CSV, TXT, HTML, JSON og XML kan kombinere valgte tabeller eller downloade separate filer inde i en ZIP-fil. Kopier tabel bruger tabulatorseparerede celler til regneark.
Udtrækning bruger et eksisterende tekstlag og genkender ikke bogstaver i sidebilleder. Hvis en side ikke har læsbar tekst, skal du bruge PDF OCR separat. En blank side kan også resultere i ingen tekst. For blandede PDF'er skal du inspicere tomme eller ulæselige sider individuelt. OCR behandler én valgt side ad gangen.
Åbn én PDF på op til 50 MB og 750 kildesider. Beskyttede filer kræver en ulåst kopi, medmindre dette værktøj eksplicit tilbyder adgangskodeindtastning. Store eller komplekse sider kan kræve mere hukommelse eller nå behandlingsgrænser, selv når filen er inden for disse grænser.
Dette værktøj bruger vores servere til behandling. Din originale fil bliver ikke overskrevet; resultatet er en separat download. Se og gennemgå resultatet, hvor det er muligt, og download den kopi, du har brug for, før du starter forfra.