
PDF به XML را باز کنید تا رکوردهای صفحه، بلوکهای متنی و دادههای ترسیمی را خروجی بگیرید. فایل PDF چهار صفحهای ما، document.xml به همراه یک تصویر PNG ارجاعشده در داخل فایل ZIP تولید میکند.
صفحات PDF را انتخاب کنید
فایل PDF را بارگذاری کنید و Pages را برای کل سند خالی بگذارید، یا زیرمجموعه مورد نیاز خود را وارد کنید. مثال ما شامل هر چهار صفحه است.
خروجی بگیرید و داراییها را کنار هم نگه دارید
Start را انتخاب کنید. خروجی به همراه داراییهای تصویری به صورت ZIP دانلود میشود. کل آرشیو را استخراج کنید و دایرکتوری images را در کنار document.xml نگه دارید.
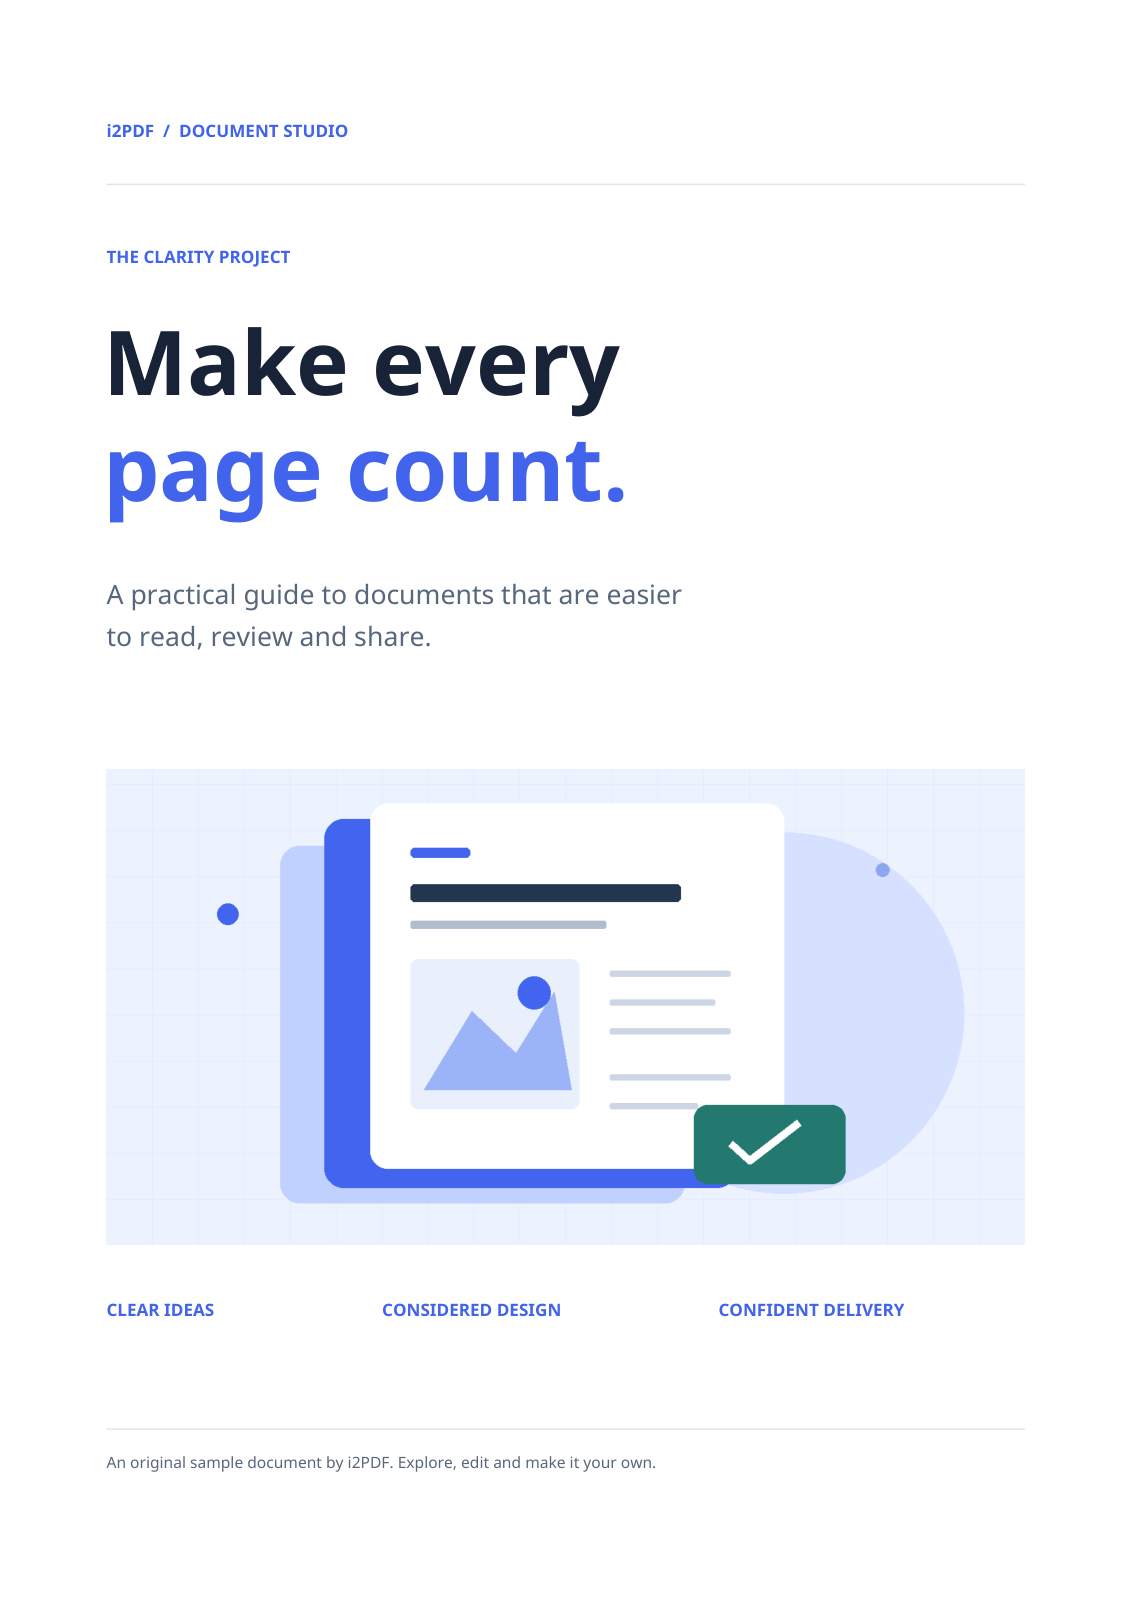
نمونه شامل images/page-001-image-005.png است. ارجاعات تصویر به جای جاسازی دادههای باینری در XML، به مسیرهای دارایی اشاره میکنند. خروجی بدون داراییهای تصویری میتواند مستقیماً به صورت .xml دانلود شود.
ساختار سند را بخوانید
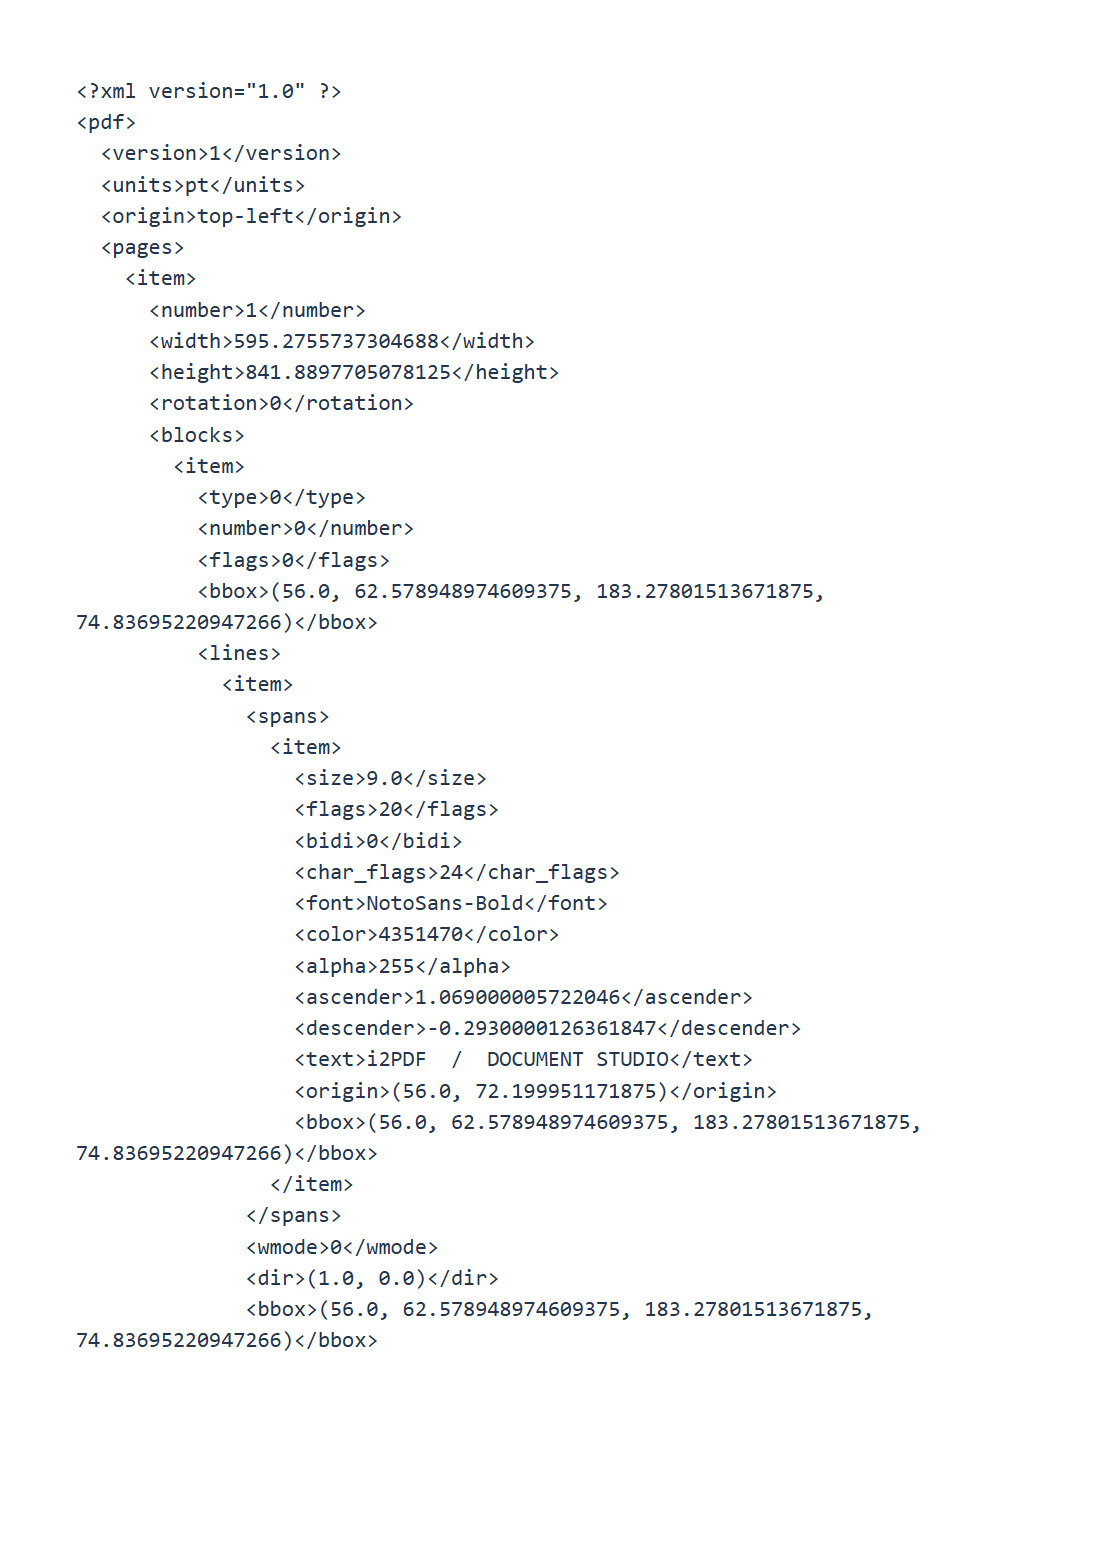
نمونه نسخه 1، واحد pt و مبدأ top-left را اعلام میکند. رکوردهای صفحه شامل شماره صفحه منبع، ابعاد، چرخش، بلوکها و ترسیمات هستند. مختصات، صفحه بدون چرخش را توصیف میکنند؛ هنگام همپوشانی دادهها، چرخش را در نظر بگیرید.
XML را با یک تجزیهکننده XML تحلیل کنید. مقادیر تکراری از عناصر آیتم استفاده میکنند؛ برخی از چندتاییهای هندسی مقادیر متنی هستند. به جای فرض کردن یک طرحواره انتشاراتی مانند DocBook، ساختار واقعی را بررسی کنید.
قبل از استفاده از دادهها در گردش کار پردازش خود، ترتیب خواندن و ارجاعات تصویر را با PDF اصلی مطابقت دهید.
سوالات متداول
آیا XML شامل فصلهای معنایی است؟
این دادههای استخراجشده صفحه را توصیف میکند. معنای سرتیتر، ترتیب خواندن و معناشناسی سند ممکن است نیاز به تفسیر شخصی شما داشته باشد.
چرا یک فایل ZIP دریافت کردم؟
نمونه حاوی یک تصویر است. فایل ZIP فایل document.xml و دارایی ارجاعشده را کنار هم نگه میدارد تا تصویر قابل مکانیابی باشد.
آن را با سند خود امتحان کنید
نتیجه را مرور کنید، سپس نسخه مورد نیاز خود را ذخیره کنید.