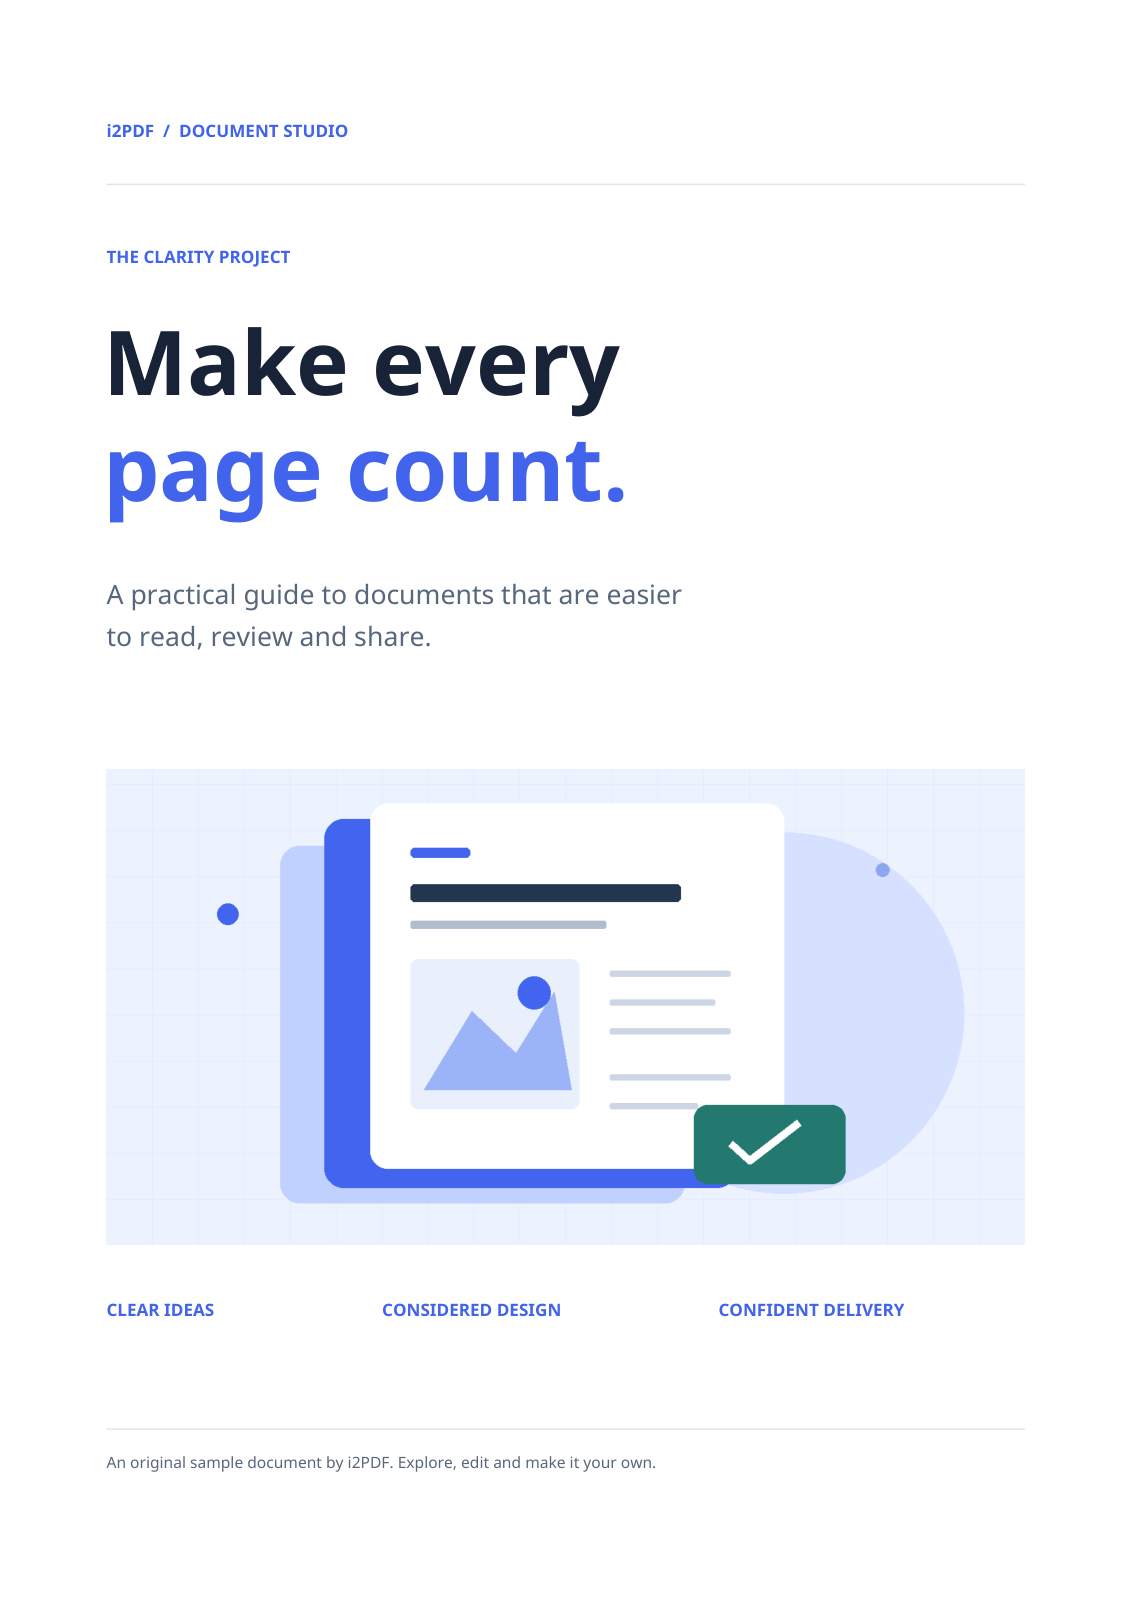
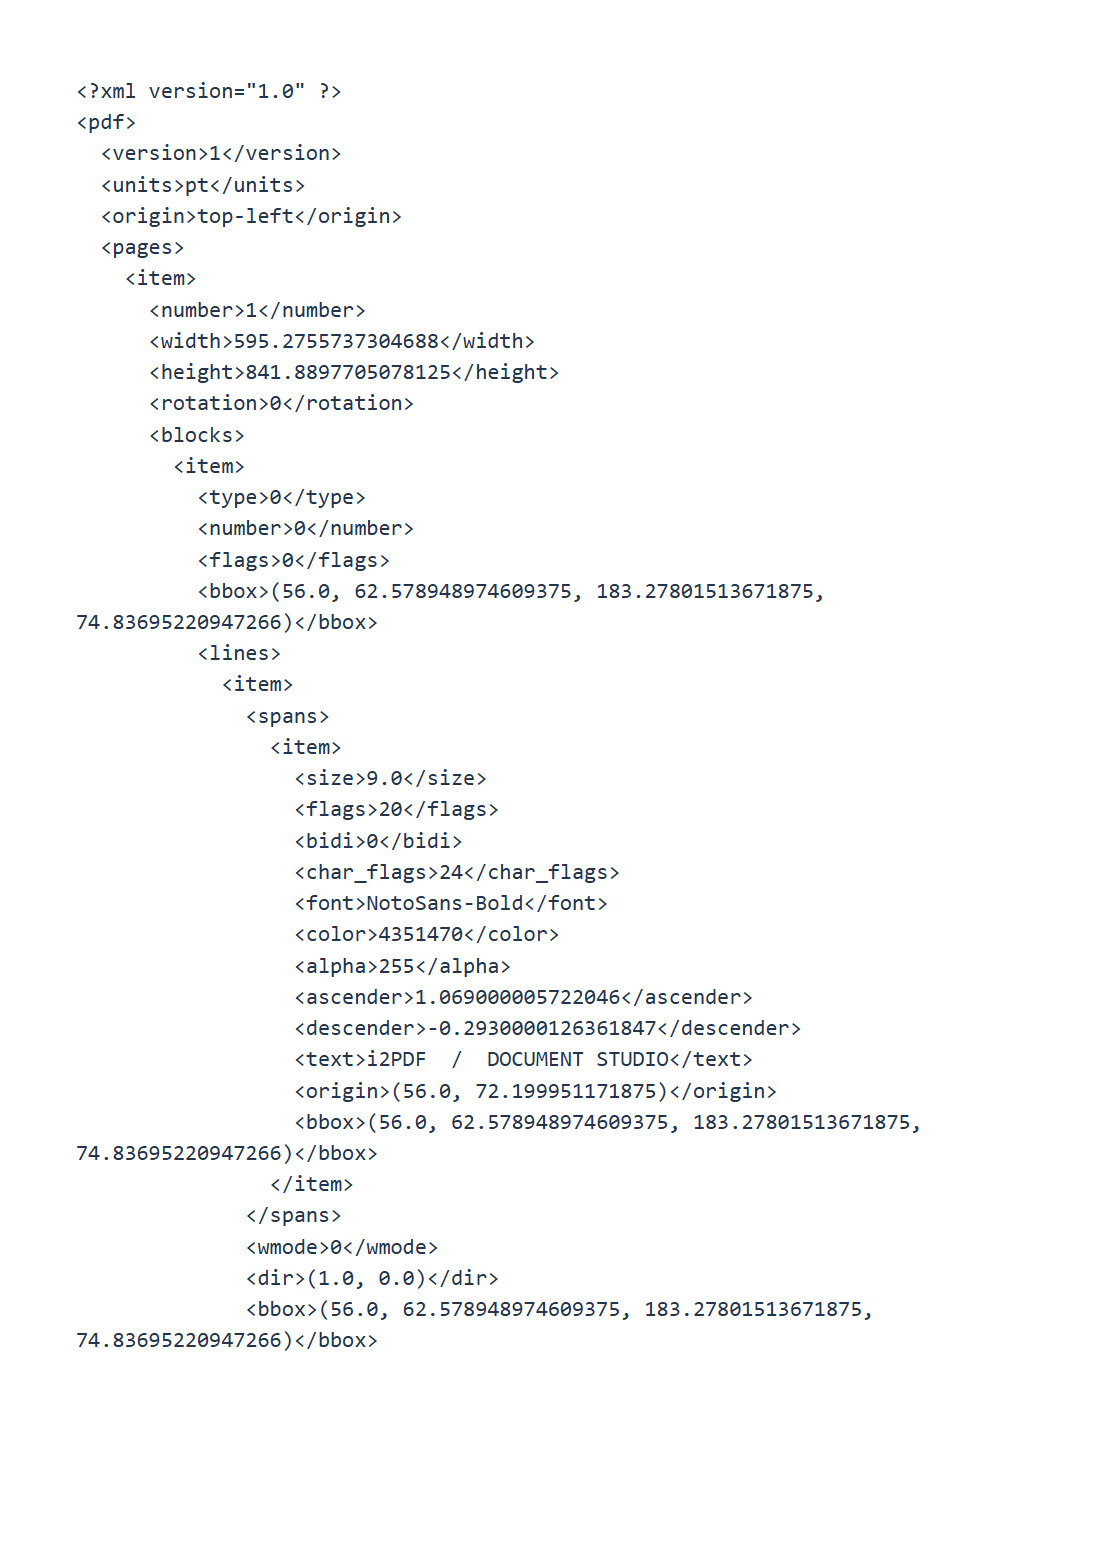

Deschide PDF to XML pentru a exporta înregistrările paginilor, blocurile de text și datele de desenare. PDF-ul nostru de patru pagini produce document.xml plus o imagine PNG referențiată în interiorul unui fișier ZIP.
Alege paginile PDF
Încarcă PDF-ul și lasă Pages gol pentru întregul document sau introdu subsetul de care ai nevoie. Exemplul nostru include toate cele patru pagini.
Exportă și păstrează resursele împreună
Alege Start. Un export cu resurse de imagine se descarcă sub formă de ZIP. Extrage întreaga arhivă și păstrează directorul images lângă document.xml.
Exemplul include images/page-001-image-005.png. Referințele de imagine indică spre căile resurselor în loc să includă date binare în XML. Un export fără resurse de imagine se poate descărca direct ca .xml.
Citește structura documentului
Exemplul declară versiunea 1, unitățile pt și o origine top-left. Înregistrările paginilor includ numărul paginii sursă, dimensiunile, rotația, blocurile și desenele. Coordonatele descriu pagina nerotită; ține cont de rotație atunci când suprapui datele.
Analizează XML-ul cu un parser XML. Valorile repetate folosesc elemente de tip item; unele tupluri geometrice sunt valori text. Inspectează structura reală în loc să presupui o schemă de publicare precum DocBook.
Verifică ordinea de citire și referințele imaginilor față de PDF-ul original înainte de a utiliza datele în fluxul tău de procesare.
Întrebări frecvente
Conține XML-ul capitole semantice?
Descrie datele extrase din pagină. Semnificația titlurilor, ordinea de citire și semantica documentului pot necesita propria ta interpretare.
De ce am primit un fișier ZIP?
Exemplul conține o imagine. ZIP-ul păstrează document.xml și resursa referențiată împreună, astfel încât imaginea să poată fi localizată.
Încearcă cu documentul tău
Revizuiește rezultatul, apoi salvează versiunea de care ai nevoie.