
Otevřete PDF do XML pro export záznamů stránek, textových bloků a dat o kresbách. Naše čtyřstránkové PDF vytvoří document.xml a jeden odkazovaný obrázek PNG uvnitř ZIPu.
Vyberte stránky PDF
Nahrajte PDF a nechte Stránky prázdné pro celý dokument, nebo zadejte podmnožinu, kterou potřebujete. Náš příklad obsahuje všechny čtyři stránky.
Exportujte a ponechte podklady pohromadě
Zvolte Start. Export s obrazovými podklady se stáhne jako ZIP. Rozbalte celý archiv a ponechte adresář images vedle document.xml.
Ukázka obsahuje images/page-001-image-005.png. Odkazy na obrázky směřují na cesty k souborům namísto vkládání binárních dat do XML. Export bez obrazových podkladů lze stáhnout přímo jako .xml.
Přečtěte strukturu dokumentu
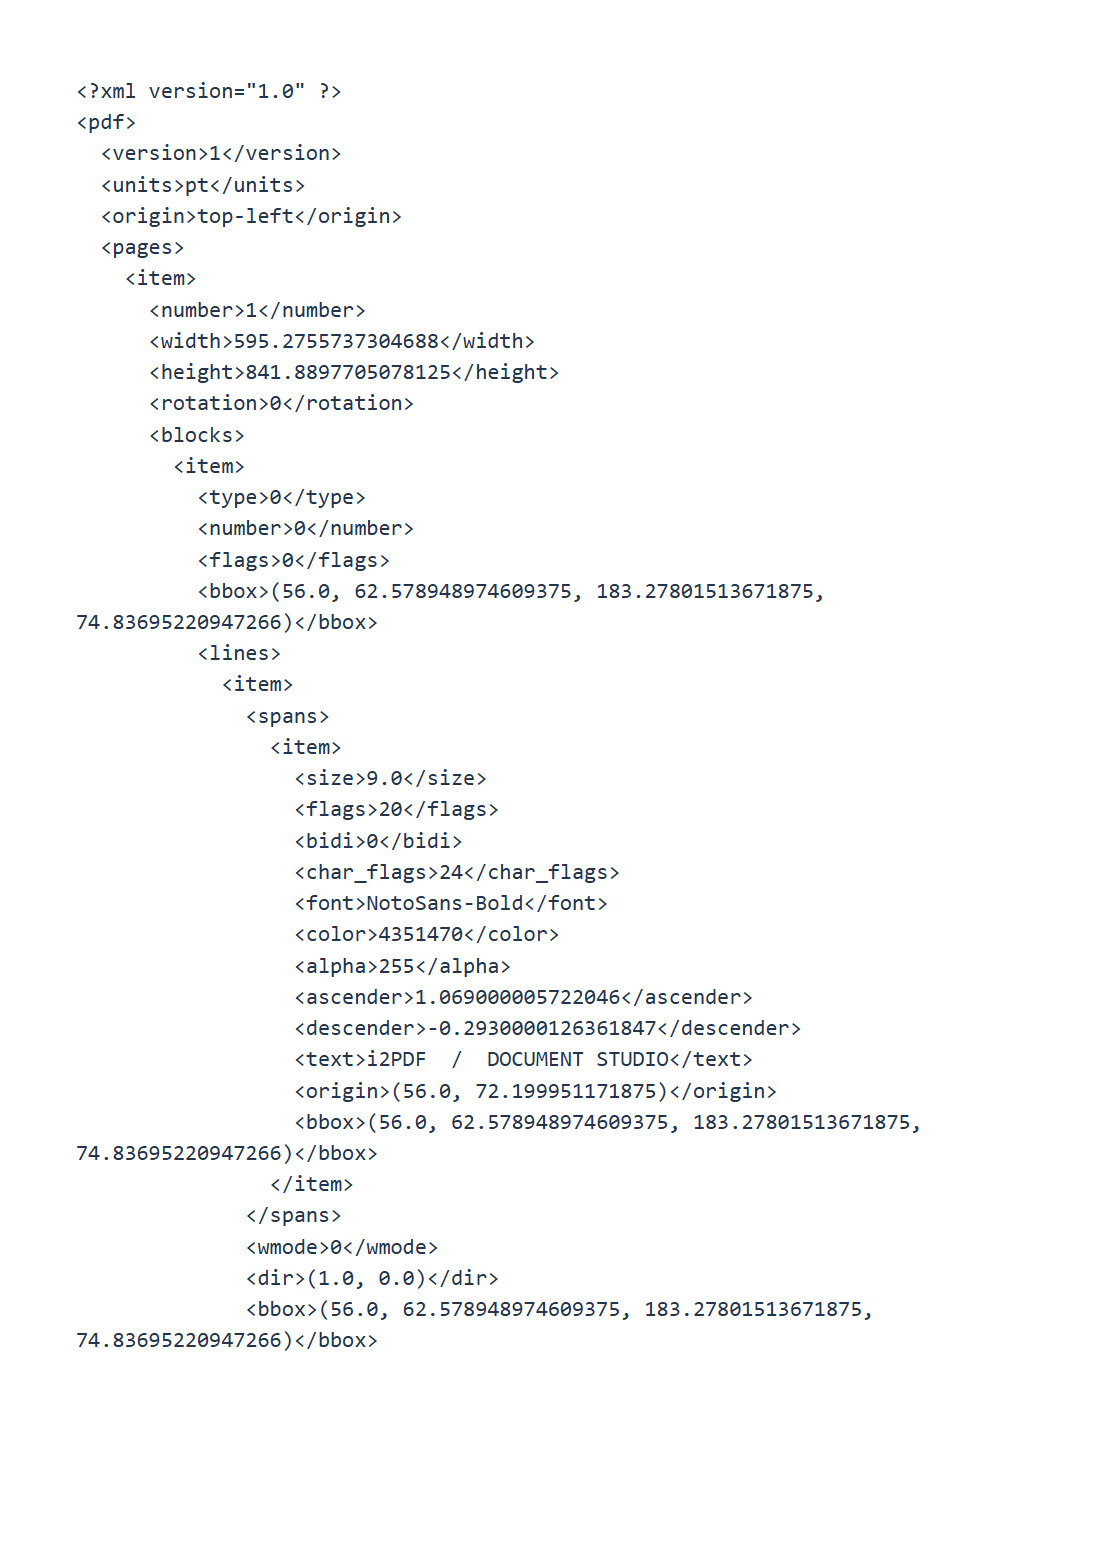
Ukázka deklaruje verzi 1, jednotky pt a počátek vlevo nahoře. Záznamy stránek obsahují číslo zdrojové stránky, rozměry, rotaci, bloky a kresby. Souřadnice popisují neotočenou stránku; při překrývání dat zohledněte rotaci.
Analyzujte XML pomocí parseru XML. Opakované hodnoty používají prvky položek; některé geometrické n-tice jsou textové hodnoty. Prozkoumejte skutečnou strukturu namísto předpokládání publikačního schématu, jako je DocBook.
Před použitím dat ve svém pracovním postupu zkontrolujte pořadí čtení a odkazy na obrázky oproti původnímu PDF.
Časté dotazy
Obsahuje XML sémantické kapitoly?
Popisuje extrahovaná data stránek. Význam nadpisů, pořadí čtení a sémantika dokumentu mohou vyžadovat vaši vlastní interpretaci.
Proč jsem obdržel ZIP?
Ukázka obsahuje obrázek. ZIP udržuje document.xml a odkazovaný soubor pohromadě, aby bylo možné obrázek najít.
Vyzkoušejte to se svým dokumentem
Zkontrolujte výsledek a poté uložte verzi, kterou potřebujete.