
Abra PDF para XML para exportar registros de página, blocos de texto e dados de desenho. Nosso PDF de quatro páginas produz document.xml mais uma imagem PNG referenciada dentro do ZIP.
Escolha as páginas do PDF
Carregue o PDF e deixe Páginas em branco para o documento inteiro, ou insira o subconjunto que você precisa. Nosso exemplo inclui todas as quatro páginas.
Exporte e mantenha os ativos juntos
Escolha Iniciar. Uma exportação com ativos de imagem é baixada como ZIP. Extraia todo o arquivo e mantenha o diretório images ao lado de document.xml.
A amostra inclui images/page-001-image-005.png. As referências de imagem apontam para caminhos de ativos em vez de incorporar dados binários no XML. Uma exportação sem ativos de imagem pode ser baixada diretamente como .xml.
Leia a estrutura do documento
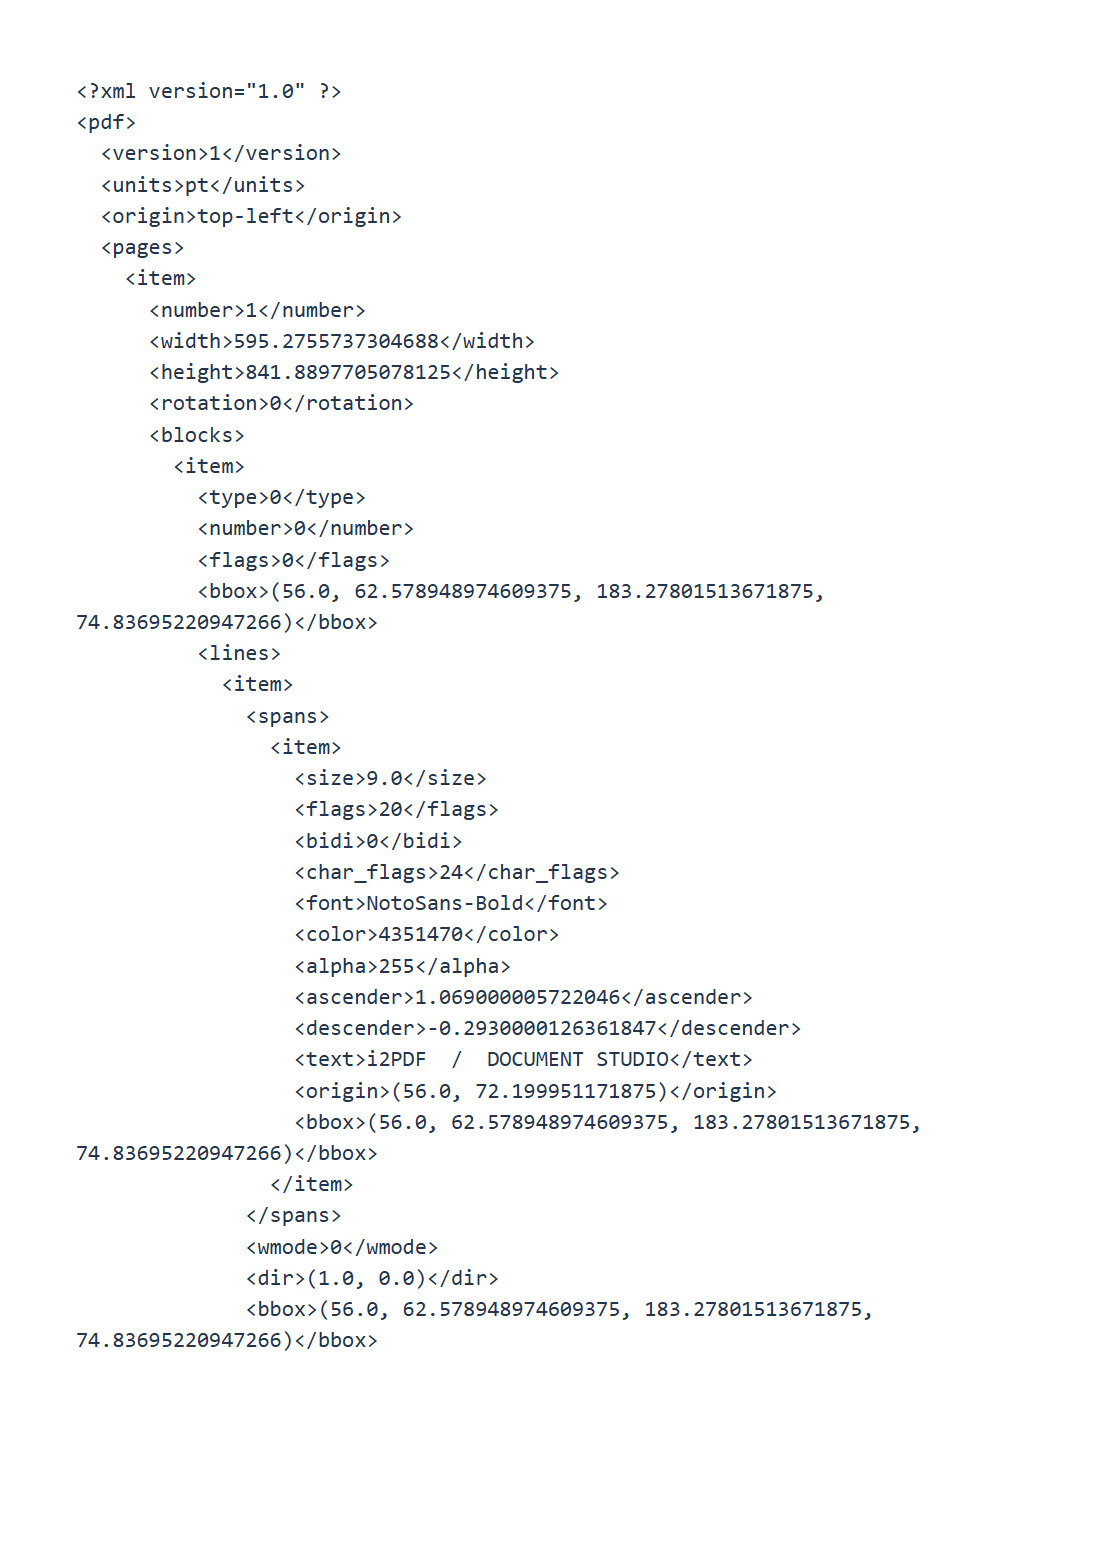
A amostra declara a versão 1, unidades pt e uma origem superior esquerda. Os registros de página incluem número da página de origem, dimensões, rotação, blocos e desenhos. As coordenadas descrevem a página não rotacionada; leve em conta a rotação ao sobrepor os dados.
Analise o XML com um analisador XML. Valores repetidos usam elementos de item; algumas tuplas geométricas são valores de texto. Inspecione a estrutura real em vez de assumir um esquema de publicação como DocBook.
Verifique a ordem de leitura e as referências de imagem em relação ao PDF original antes de usar os dados em seu fluxo de trabalho de processamento.
Perguntas comuns
O XML contém capítulos semânticos?
Ele descreve os dados de página extraídos. O significado do cabeçalho, a ordem de leitura e a semântica do documento podem precisar da sua própria interpretação.
Por que recebi um ZIP?
A amostra contém uma imagem. O ZIP mantém o document.xml e o ativo referenciado juntos para que a imagem possa ser localizada.
Experimente com seu documento
Revise o resultado e, em seguida, salve a versão que você precisa.