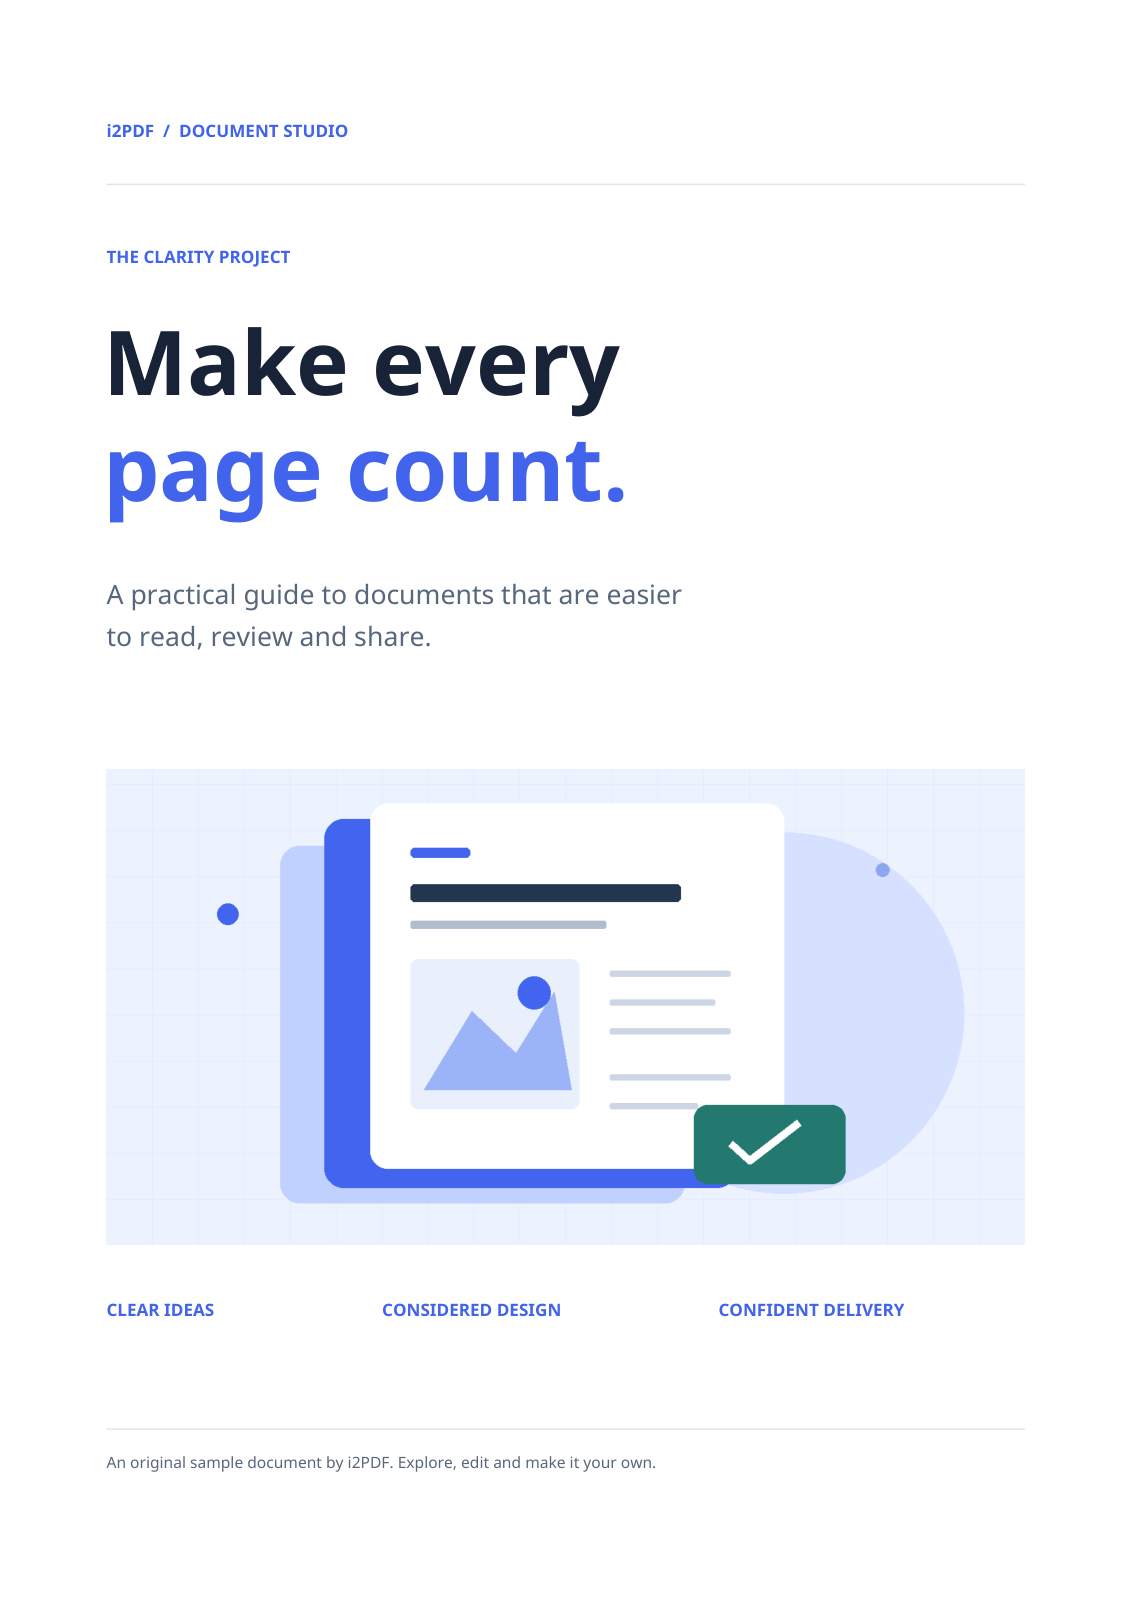
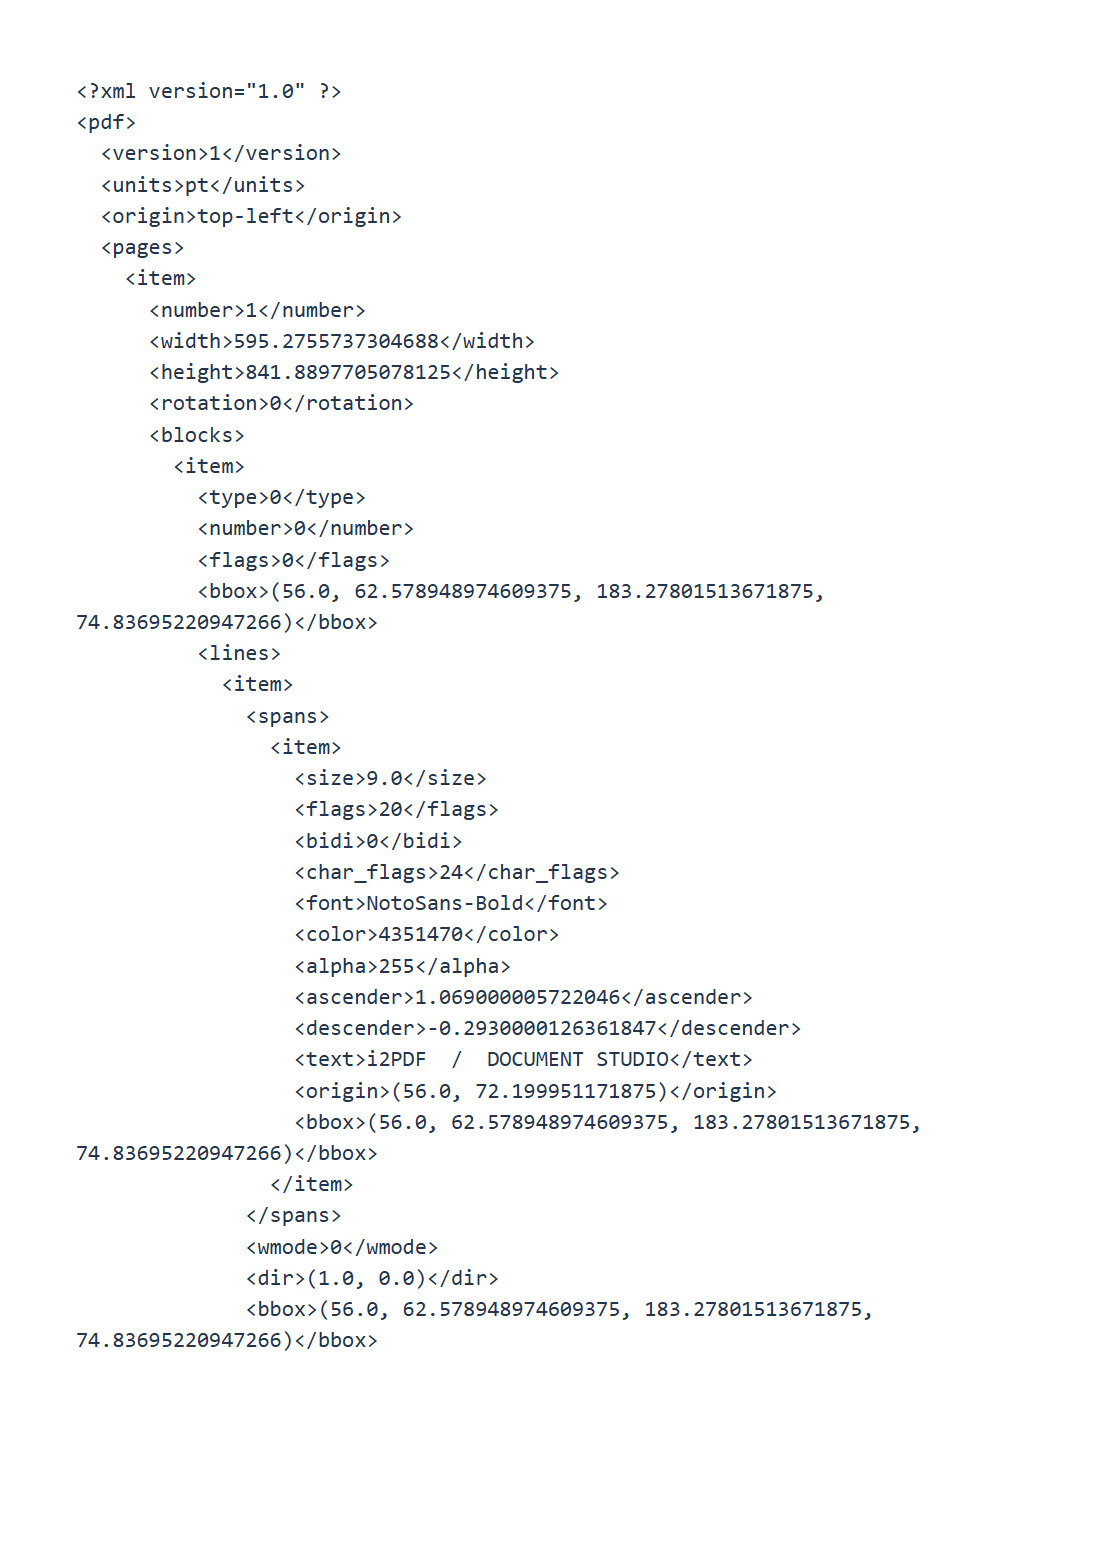

PDF to XML을 열어 페이지 레코드, 텍스트 블록 및 드로잉 데이터를 내보내세요. 4페이지 PDF는 document.xml과 ZIP 내부의 참조된 PNG 이미지 1개를 생성합니다.
PDF 페이지 선택
PDF를 로드하고 Pages를 비워두어 전체 문서를 처리하거나 필요한 하위 집합을 입력하세요. 예제에는 4페이지 전체가 포함되어 있습니다.
내보내기 및 에셋 유지
Start을 선택하세요. 이미지 에셋이 포함된 내보내기 파일은 ZIP으로 다운로드됩니다. 전체 아카이브의 압축을 풀고 document.xml 옆에 images 디렉토리를 유지하세요.
샘플에는 images/page-001-image-005.png이 포함되어 있습니다. 이미지 참조는 XML에 바이너리 데이터를 포함하는 대신 에셋 경로를 가리킵니다. 이미지 에셋이 없는 내보내기는 .xml로 직접 다운로드할 수 있습니다.
문서 구조 읽기
샘플은 버전 1, 단위 pt 및 top-left 원점을 선언합니다. 페이지 레코드에는 소스 페이지 번호, 치수, 회전, 블록 및 드로잉이 포함됩니다. 좌표는 회전되지 않은 페이지를 설명하므로 데이터를 오버레이할 때 회전을 고려하세요.
XML 파서로 XML을 구문 분석하세요. 반복되는 값은 항목 요소를 사용하며, 일부 기하학적 튜플은 텍스트 값입니다. DocBook과 같은 게시 스키마를 가정하는 대신 실제 구조를 검사하세요.
데이터를 처리 워크플로우에 사용하기 전에 원본 PDF와 비교하여 읽기 순서와 이미지 참조를 확인하세요.
자주 묻는 질문
XML에 의미론적 챕터가 포함되어 있나요?
추출된 페이지 데이터를 설명합니다. 제목 의미, 읽기 순서 및 문서 의미론은 직접 해석해야 할 수도 있습니다.
왜 ZIP 파일을 받았나요?
샘플에 이미지가 포함되어 있습니다. ZIP은 document.xml과 참조된 에셋을 함께 유지하여 이미지를 찾을 수 있도록 합니다.
문서로 시도해 보세요
결과를 검토한 다음 필요한 버전을 저장하세요.