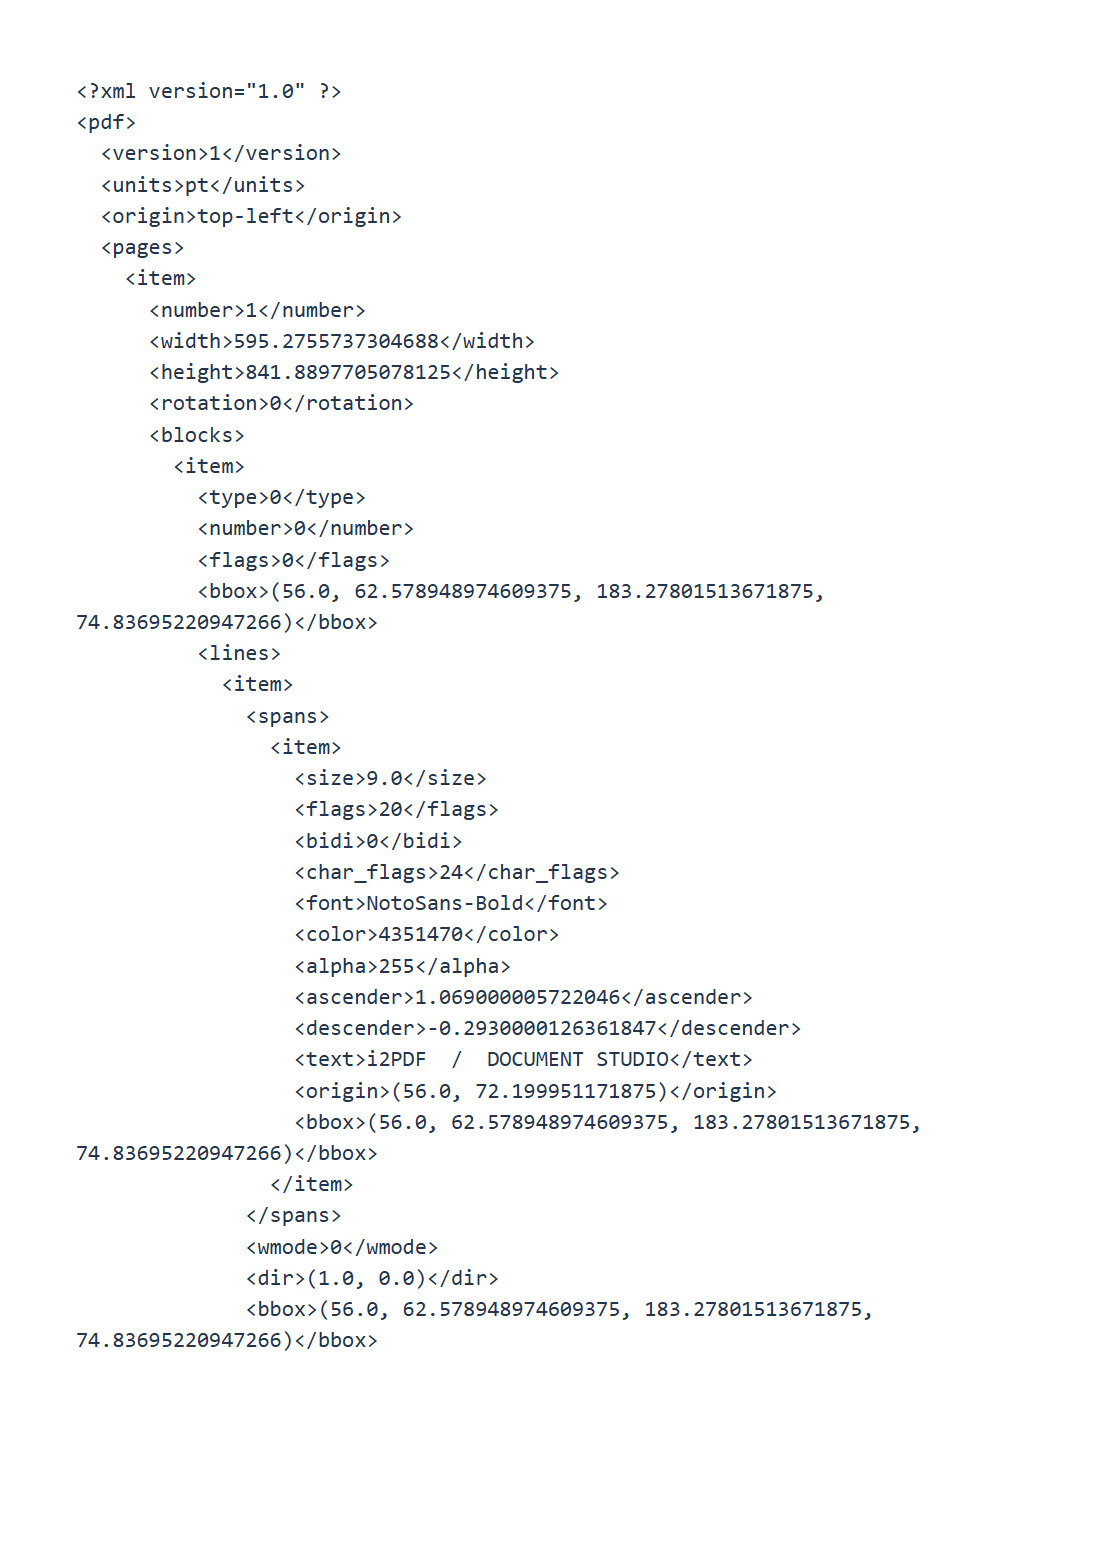

PDFからXMLへを開き、ページレコード、テキストブロック、描画データをエクスポートします。当社の4ページPDFは、document.xmlと、ZIP内の参照されたPNG画像1点を生成します。
PDFページを選択
PDFを読み込み、ページを空のままにするとドキュメント全体が対象となります。必要なサブセットを入力することも可能です。この例では全4ページを含めています。
エクスポートしてアセットをまとめて保持
開始を選択します。画像アセットを含むエクスポートはZIPとしてダウンロードされます。アーカイブ全体を解凍し、document.xmlの横にimagesディレクトリを保持してください。
サンプルにはimages/page-001-image-005.pngが含まれています。画像参照はXML内にバイナリデータを埋め込むのではなく、アセットパスを指し示します。画像アセットを含まないエクスポートは、直接.xmlとしてダウンロードできます。
ドキュメント構造を読み取る
サンプルではバージョン 1、単位 pt、および top-left 原点が宣言されています。ページレコードには、ソースページ番号、寸法、回転、ブロック、および図面が含まれます。座標は回転前のページを表しているため、データをオーバーレイする際は回転を考慮してください。
XMLパーサーを使用してXMLを解析してください。繰り返し値にはitem要素が使用され、一部の幾何学的タプルはテキスト値となっています。DocBookのようなパブリッシングスキーマを前提とするのではなく、実際の構造を調査してください。
処理ワークフローでデータを使用する前に、読み取り順序と画像参照が元のPDFと一致しているか確認してください。
よくある質問
XMLにはセマンティックな章が含まれていますか?
これは抽出されたページデータを記述するものです。見出しの意味、読み取り順序、およびドキュメントのセマンティクスについては、独自に解釈する必要がある場合があります。
なぜZIPファイルが届いたのですか?
サンプルには画像が含まれています。ZIPファイルはdocument.xmlと参照されているアセットをまとめて保持するため、画像を特定することができます。
お手元のドキュメントでお試しください
結果を確認し、必要なバージョンを保存してください。