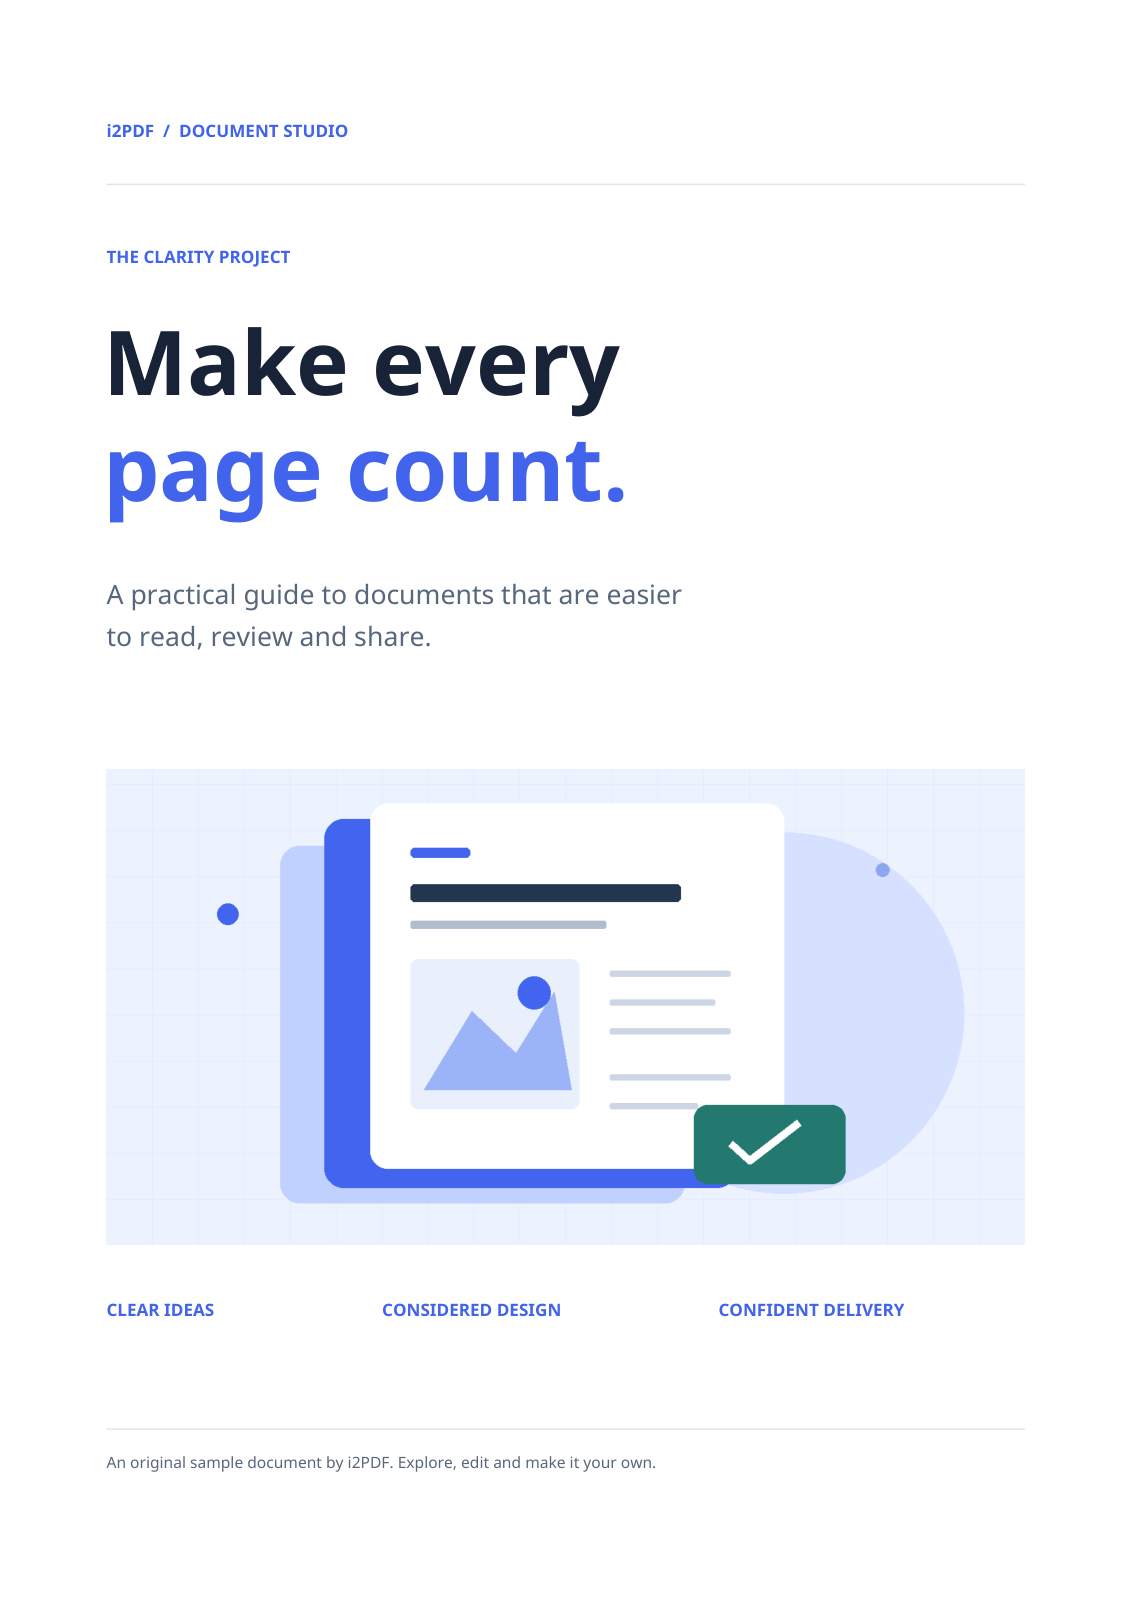
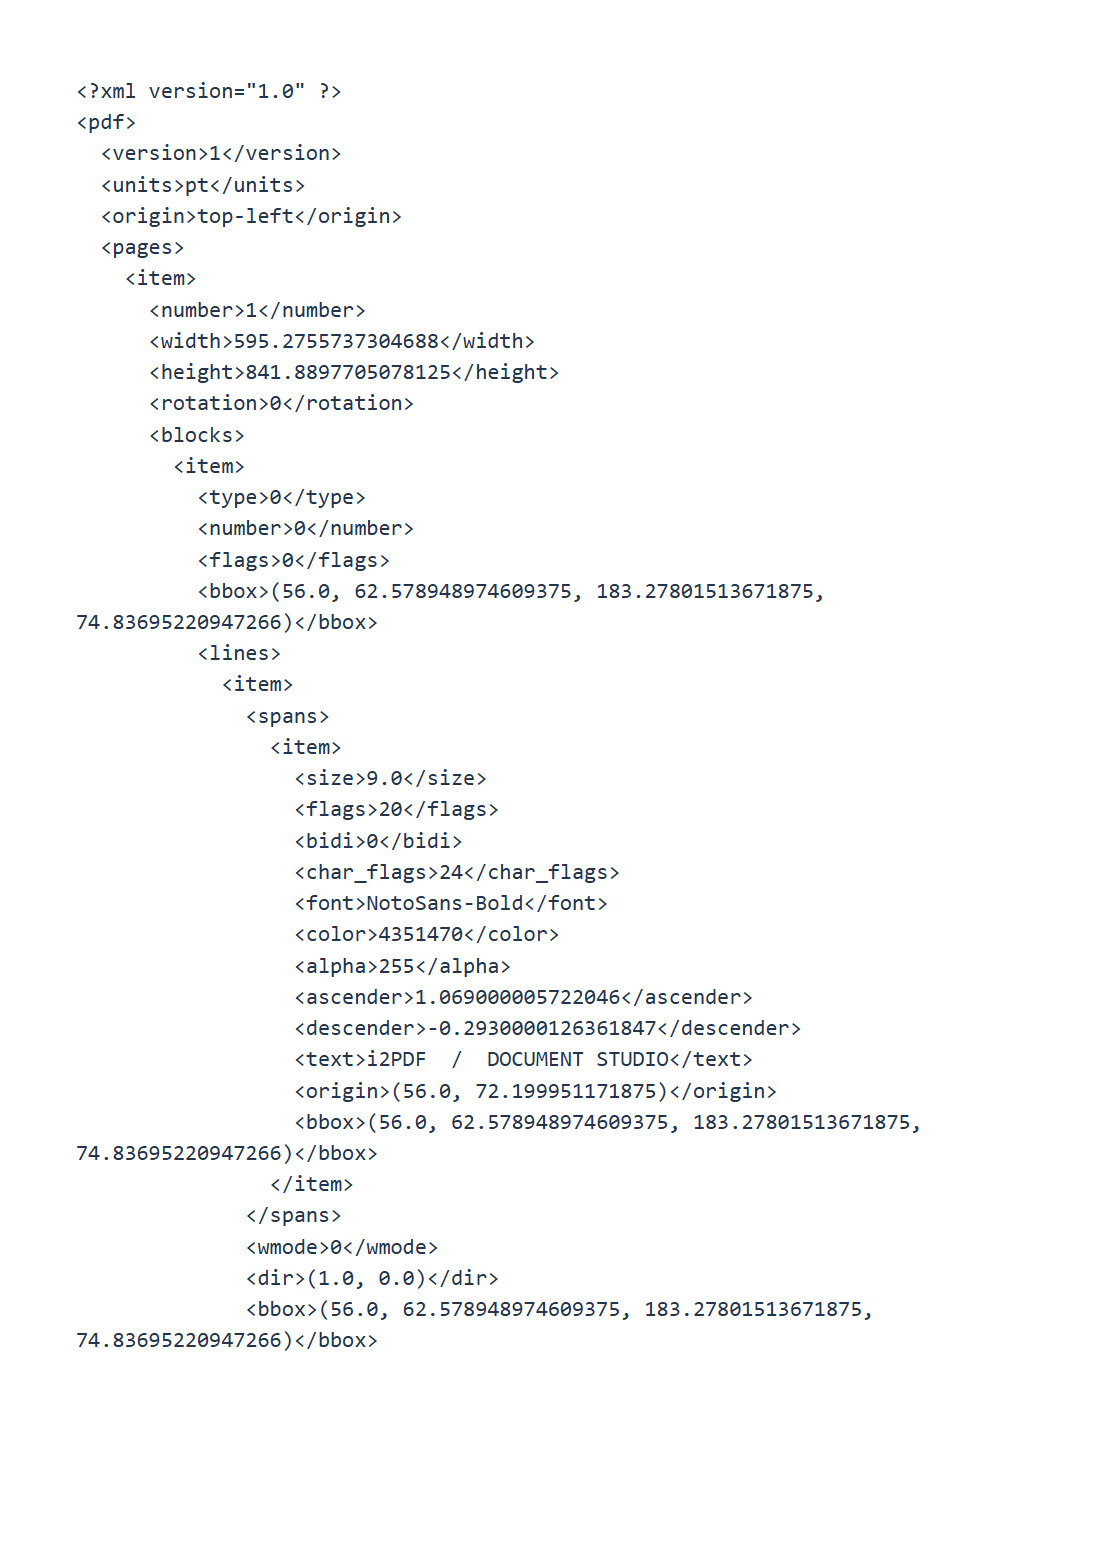

Buksan ang PDF to XML para i-export ang mga record ng pahina, text block, at drawing data. Ang aming apat na pahinang PDF ay gumagawa ng document.xml at isang referenced PNG image sa loob ng ZIP.
Piliin ang mga pahina ng PDF
I-load ang PDF at iwanang blangko ang Pages para sa buong dokumento, o ilagay ang subset na kailangan mo. Ang aming halimbawa ay kinabibilangan ng lahat ng apat na pahina.
I-export at panatilihing magkasama ang mga asset
Piliin ang Start. Ang isang export na may mga image asset ay mada-download bilang ZIP. I-extract ang buong archive at panatilihin ang images directory sa tabi ng document.xml.
Ang sample ay kinabibilangan ng images/page-001-image-005.png. Ang mga reference ng imahe ay tumuturo sa mga asset path sa halip na i-embed ang binary data sa XML. Ang isang export na walang mga image asset ay maaaring direktang ma-download bilang .xml.
Basahin ang istruktura ng dokumento
Ang sample ay nagdedeklara ng bersyon 1, mga unit na pt, at top-left na pinagmulan. Ang mga record ng pahina ay kinabibilangan ng source page number, mga dimensyon, pag-ikot, mga block, at mga drawing. Ang mga coordinate ay naglalarawan ng pahinang hindi pa naiikot; isaalang-alang ang pag-ikot kapag ipinapatong ang data.
I-parse ang XML gamit ang isang XML parser. Ang mga paulit-ulit na value ay gumagamit ng mga item element; ang ilang geometric tuple ay mga text value. Suriin ang aktwal na istruktura sa halip na umasa sa isang publishing schema gaya ng DocBook.
Suriin ang pagkakasunod-sunod ng pagbabasa at mga reference ng imahe laban sa orihinal na PDF bago gamitin ang data sa iyong processing workflow.
Mga karaniwang tanong
Naglalaman ba ang XML ng mga semantic chapter?
Inilalarawan nito ang na-extract na page data. Ang kahulugan ng heading, pagkakasunod-sunod ng pagbabasa, at semantics ng dokumento ay maaaring mangailangan ng sarili mong interpretasyon.
Bakit ako nakatanggap ng ZIP?
Ang sample ay naglalaman ng isang imahe. Pinapanatili ng ZIP ang document.xml at ang referenced asset nang magkasama upang mahanap ang imahe.
Subukan ito sa iyong dokumento
Suriin ang resulta, pagkatapos ay i-save ang bersyong kailangan mo.