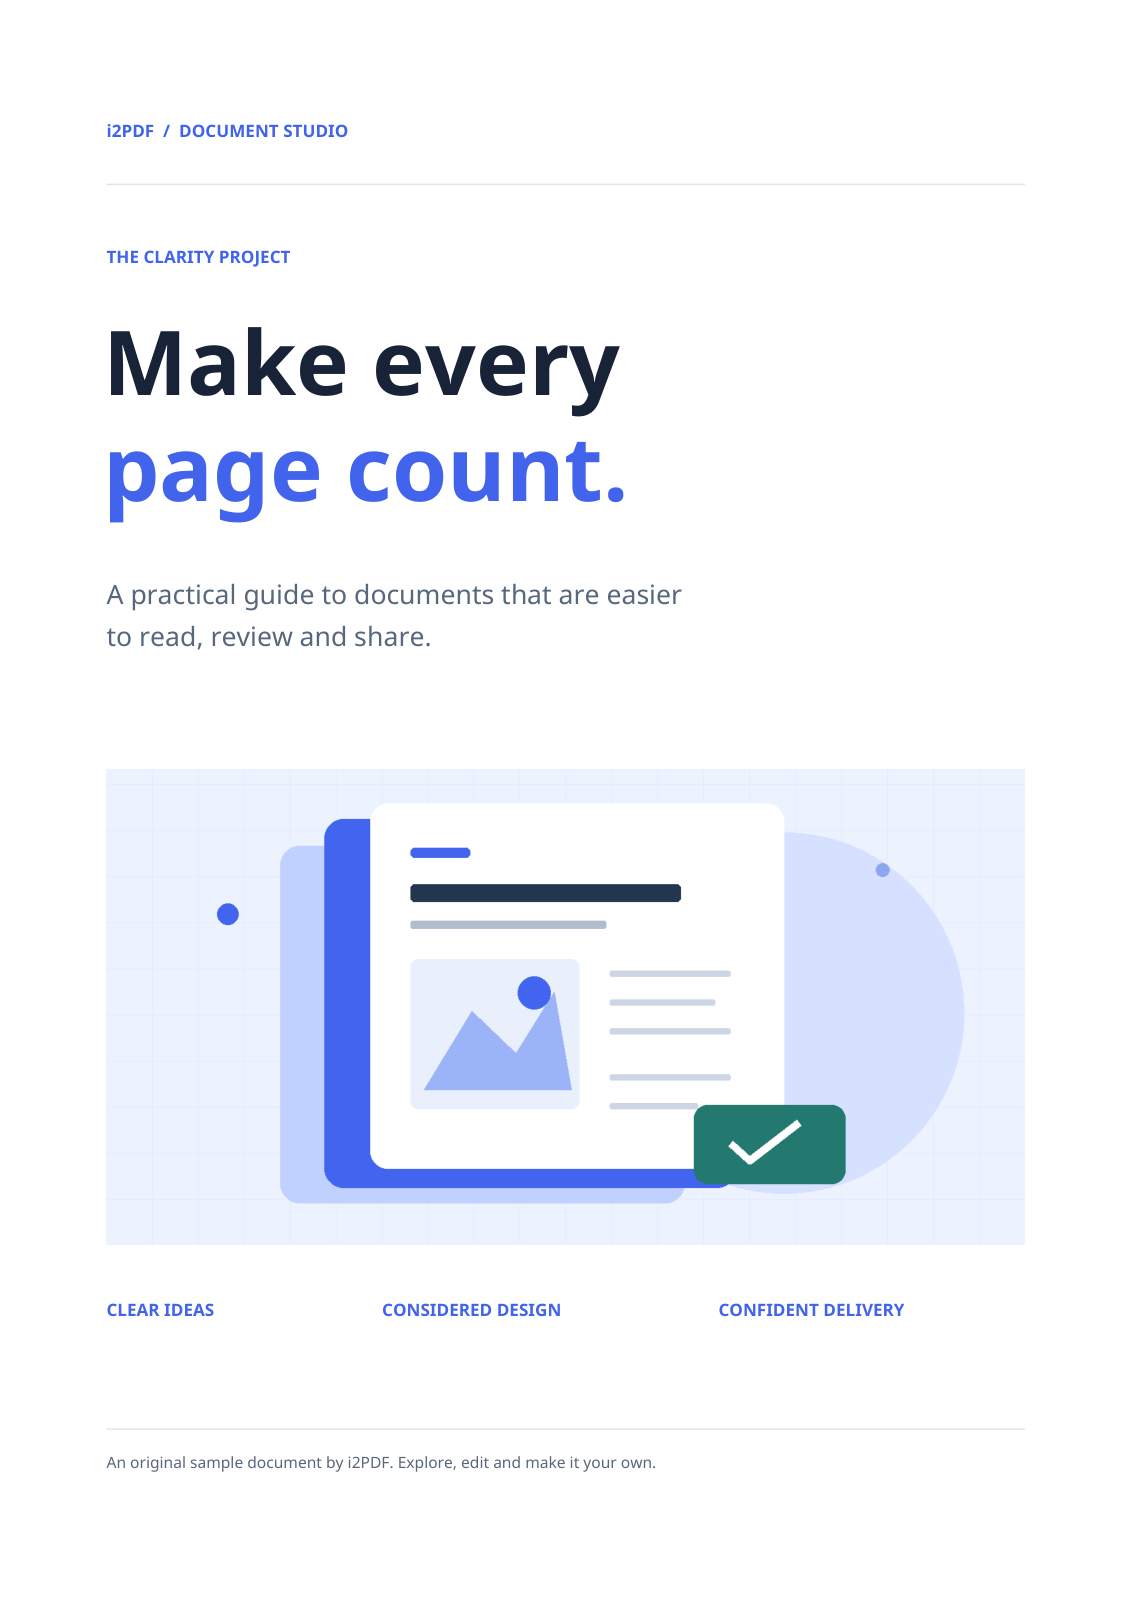
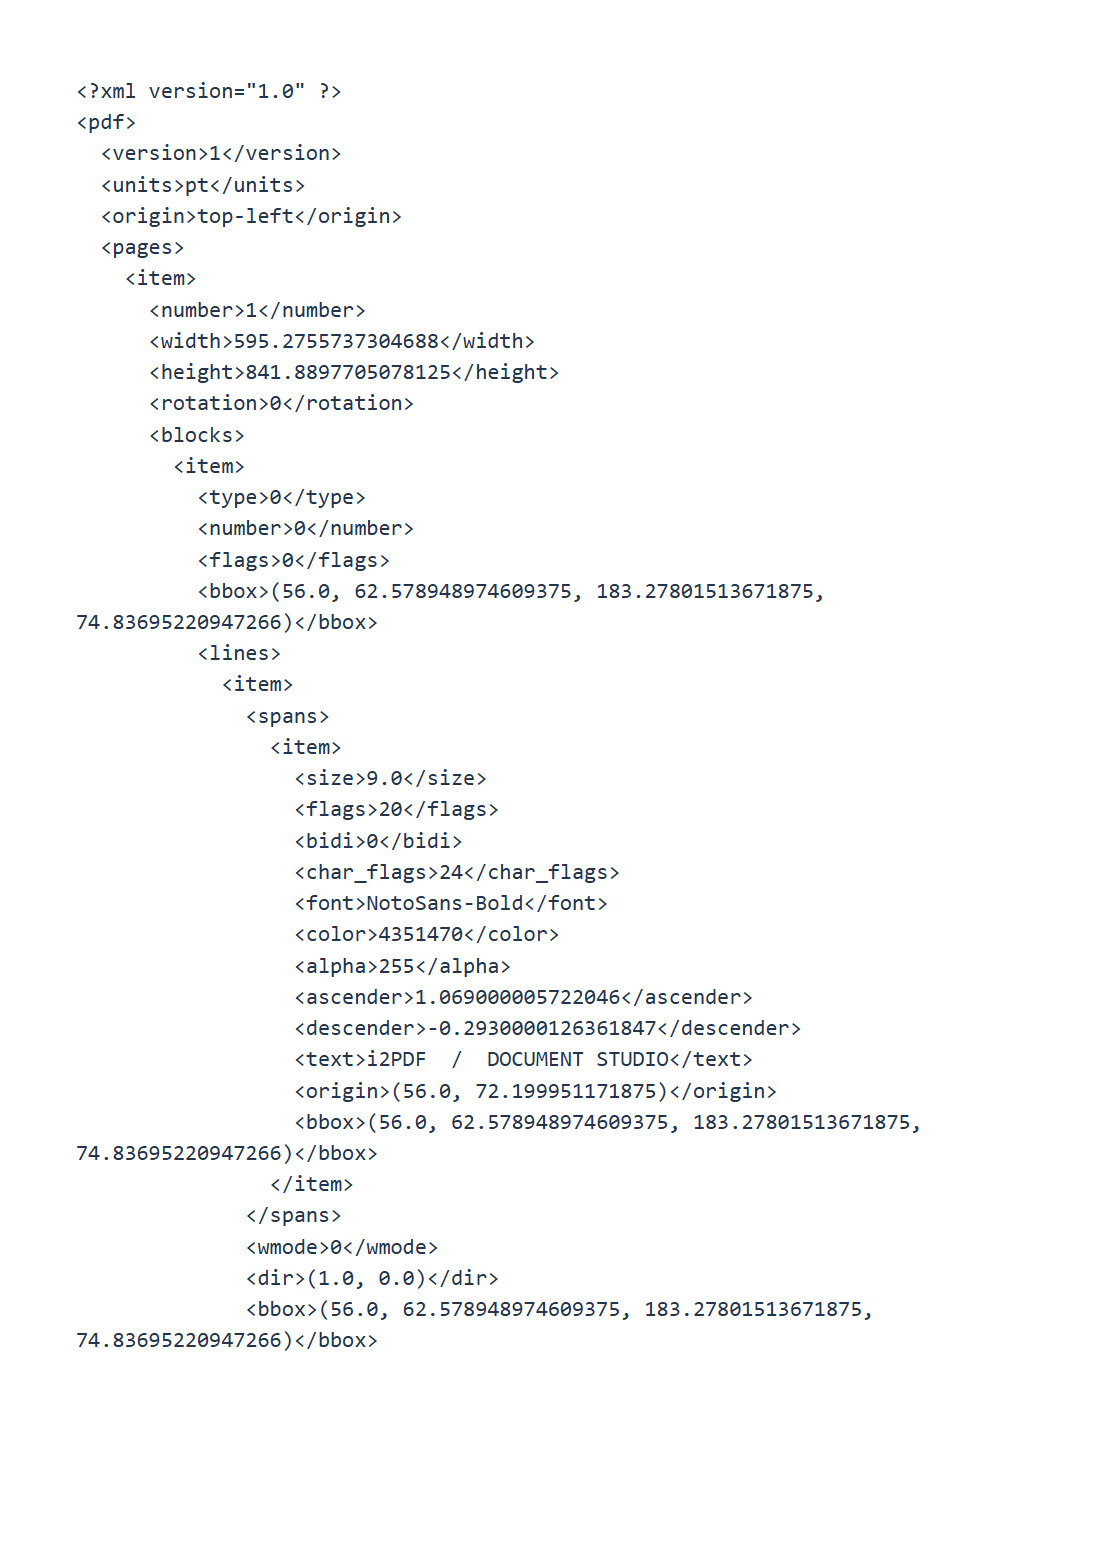

পৃষ্ঠার রেকর্ড, টেক্সট ব্লক এবং ড্রয়িং ডেটা এক্সপোর্ট করতে PDF to XML খুলুন। আমাদের চার পৃষ্ঠার PDF থেকে document.xml এবং ZIP-এর ভেতরে একটি রেফারেন্স করা PNG ছবি তৈরি হয়।
PDF পৃষ্ঠাগুলো নির্বাচন করুন
PDF লোড করুন এবং পুরো ডকুমেন্টের জন্য Pages খালি রাখুন, অথবা আপনার প্রয়োজনীয় সাবসেটটি লিখুন। আমাদের উদাহরণে চারটি পৃষ্ঠাই অন্তর্ভুক্ত রয়েছে।
এক্সপোর্ট করুন এবং অ্যাসেটগুলো একসাথে রাখুন
Start নির্বাচন করুন। ইমেজ অ্যাসেট সহ একটি এক্সপোর্ট ZIP হিসেবে ডাউনলোড হবে। পুরো আর্কাইভটি এক্সট্র্যাক্ট করুন এবং document.xml-এর পাশে images ডিরেক্টরিটি রাখুন।
নমুনাটিতে images/page-001-image-005.png অন্তর্ভুক্ত রয়েছে। XML-এ বাইনারি ডেটা এমবেড করার পরিবর্তে ইমেজ রেফারেন্সগুলো অ্যাসেট পাথ নির্দেশ করে। ইমেজ অ্যাসেট ছাড়া এক্সপোর্ট সরাসরি .xml হিসেবে ডাউনলোড হতে পারে।
ডকুমেন্টের গঠন পড়ুন
নমুনাটিতে 1 ভার্সন, pt ইউনিট এবং একটি top-left অরিজিন ঘোষণা করা হয়েছে। পৃষ্ঠার রেকর্ডে সোর্স পৃষ্ঠার নম্বর, মাত্রা, রোটেশন, ব্লক এবং ড্রয়িং অন্তর্ভুক্ত থাকে। স্থানাঙ্কগুলো আনরোটেটেড পৃষ্ঠাকে বর্ণনা করে; ডেটা ওভারলে করার সময় রোটেশনের বিষয়টি বিবেচনায় রাখুন।
একটি XML পার্সার দিয়ে XML পার্স করুন। পুনরাবৃত্ত মানগুলো আইটেম এলিমেন্ট ব্যবহার করে; কিছু জ্যামিতিক টিউপল হলো টেক্সট ভ্যালু। DocBook-এর মতো পাবলিশিং স্কিমা অনুমান করার পরিবর্তে প্রকৃত গঠনটি পরীক্ষা করুন।
আপনার প্রসেসিং ওয়ার্কফ্লোতে ডেটা ব্যবহার করার আগে মূল PDF-এর সাথে রিডিং অর্ডার এবং ইমেজ রেফারেন্সগুলো মিলিয়ে দেখুন।
সাধারণ প্রশ্নাবলী
XML-এ কি সেমান্টিক চ্যাপ্টার থাকে?
এটি এক্সট্র্যাক্ট করা পৃষ্ঠার ডেটা বর্ণনা করে। শিরোনামের অর্থ, রিডিং অর্ডার এবং ডকুমেন্টের সেমান্টিক আপনার নিজস্ব ব্যাখ্যার প্রয়োজন হতে পারে।
আমি কেন একটি ZIP ফাইল পেয়েছি?
নমুনাটিতে একটি ছবি রয়েছে। ZIP ফাইলটি document.xml এবং রেফারেন্স করা অ্যাসেটকে একসাথে রাখে যাতে ছবিটি খুঁজে পাওয়া যায়।
আপনার ডকুমেন্ট দিয়ে চেষ্টা করুন
ফলাফলটি পর্যালোচনা করুন, তারপর আপনার প্রয়োজনীয় ভার্সনটি সেভ করুন।