
पेज रिकॉर्ड, टेक्स्ट ब्लॉक और ड्राइंग डेटा एक्सपोर्ट करने के लिए PDF to XML खोलें। हमारी चार-पेज वाली PDF document.xml और ZIP के अंदर एक संदर्भित PNG छवि बनाती है।
PDF पेज चुनें
PDF लोड करें और पूरे दस्तावेज़ के लिए Pages को खाली छोड़ दें, या अपनी आवश्यकतानुसार सबसेट दर्ज करें। हमारे उदाहरण में सभी चार पेज शामिल हैं।
एक्सपोर्ट करें और एसेट को एक साथ रखें
Start चुनें। छवि एसेट के साथ एक एक्सपोर्ट ZIP के रूप में डाउनलोड होता है। पूरे आर्काइव को निकालें और images डायरेक्टरी को document.xml के साथ रखें।
नमूने में images/page-001-image-005.png शामिल है। छवि संदर्भ XML में बाइनरी डेटा एम्बेड करने के बजाय एसेट पथ की ओर इशारा करते हैं। बिना छवि एसेट वाला एक्सपोर्ट सीधे .xml के रूप में डाउनलोड हो सकता है।
दस्तावेज़ संरचना पढ़ें
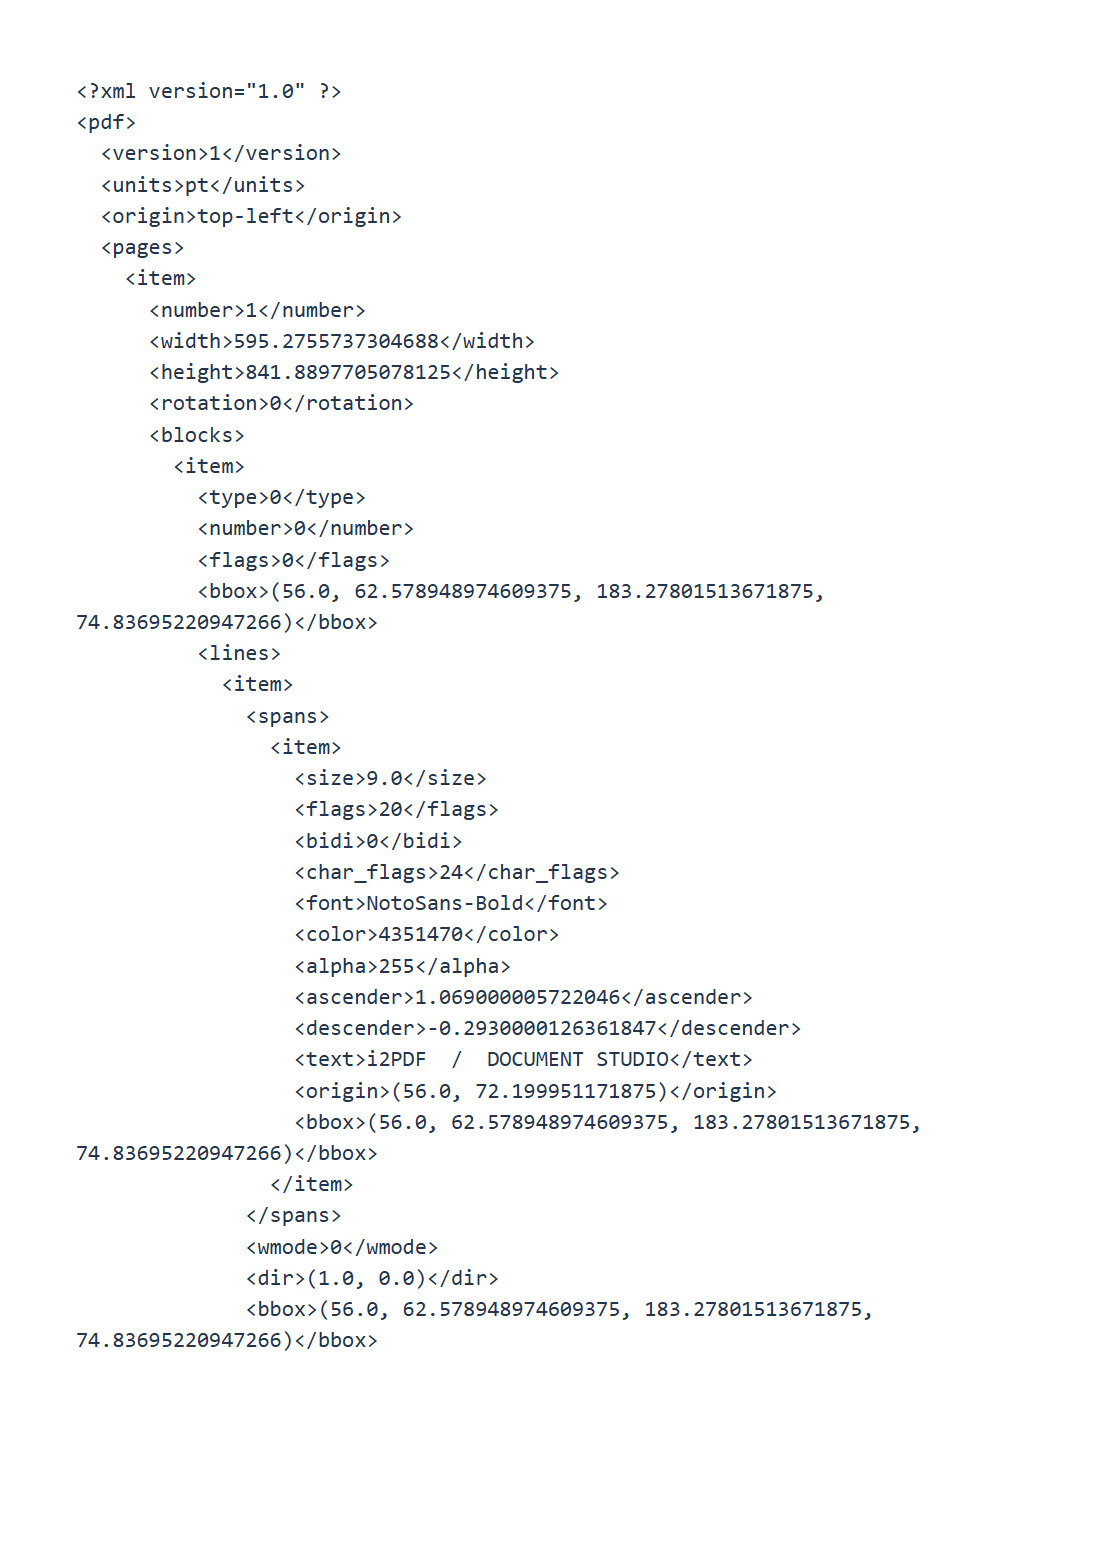
नमूना संस्करण 1, इकाइयाँ pt और एक top-left मूल घोषित करता है। पेज रिकॉर्ड में स्रोत पेज संख्या, आयाम, रोटेशन, ब्लॉक और ड्राइंग शामिल हैं। निर्देशांक बिना रोटेट किए पेज का वर्णन करते हैं; डेटा को ओवरले करते समय रोटेशन का ध्यान रखें।
XML पार्सर के साथ XML को पार्स करें। दोहराए गए मान आइटम तत्वों का उपयोग करते हैं; कुछ ज्यामितीय टुपल्स टेक्स्ट मान हैं। DocBook जैसे प्रकाशन स्कीमा को मानने के बजाय वास्तविक संरचना का निरीक्षण करें।
अपने प्रोसेसिंग वर्कफ़्लो में डेटा का उपयोग करने से पहले मूल PDF के विरुद्ध पढ़ने के क्रम और छवि संदर्भों की जाँच करें।
सामान्य प्रश्न
क्या XML में शब्दार्थ अध्याय शामिल हैं?
यह निकाले गए पेज डेटा का वर्णन करता है। हेडिंग का अर्थ, पढ़ने का क्रम और दस्तावेज़ शब्दार्थ को आपकी अपनी व्याख्या की आवश्यकता हो सकती है।
मुझे ZIP क्यों प्राप्त हुआ?
नमूने में एक छवि है। ZIP document.xml और संदर्भित एसेट को एक साथ रखता है ताकि छवि का पता लगाया जा सके।
इसे अपने दस्तावेज़ के साथ आज़माएँ
परिणाम की समीक्षा करें, फिर अपनी आवश्यकतानुसार संस्करण सहेजें।