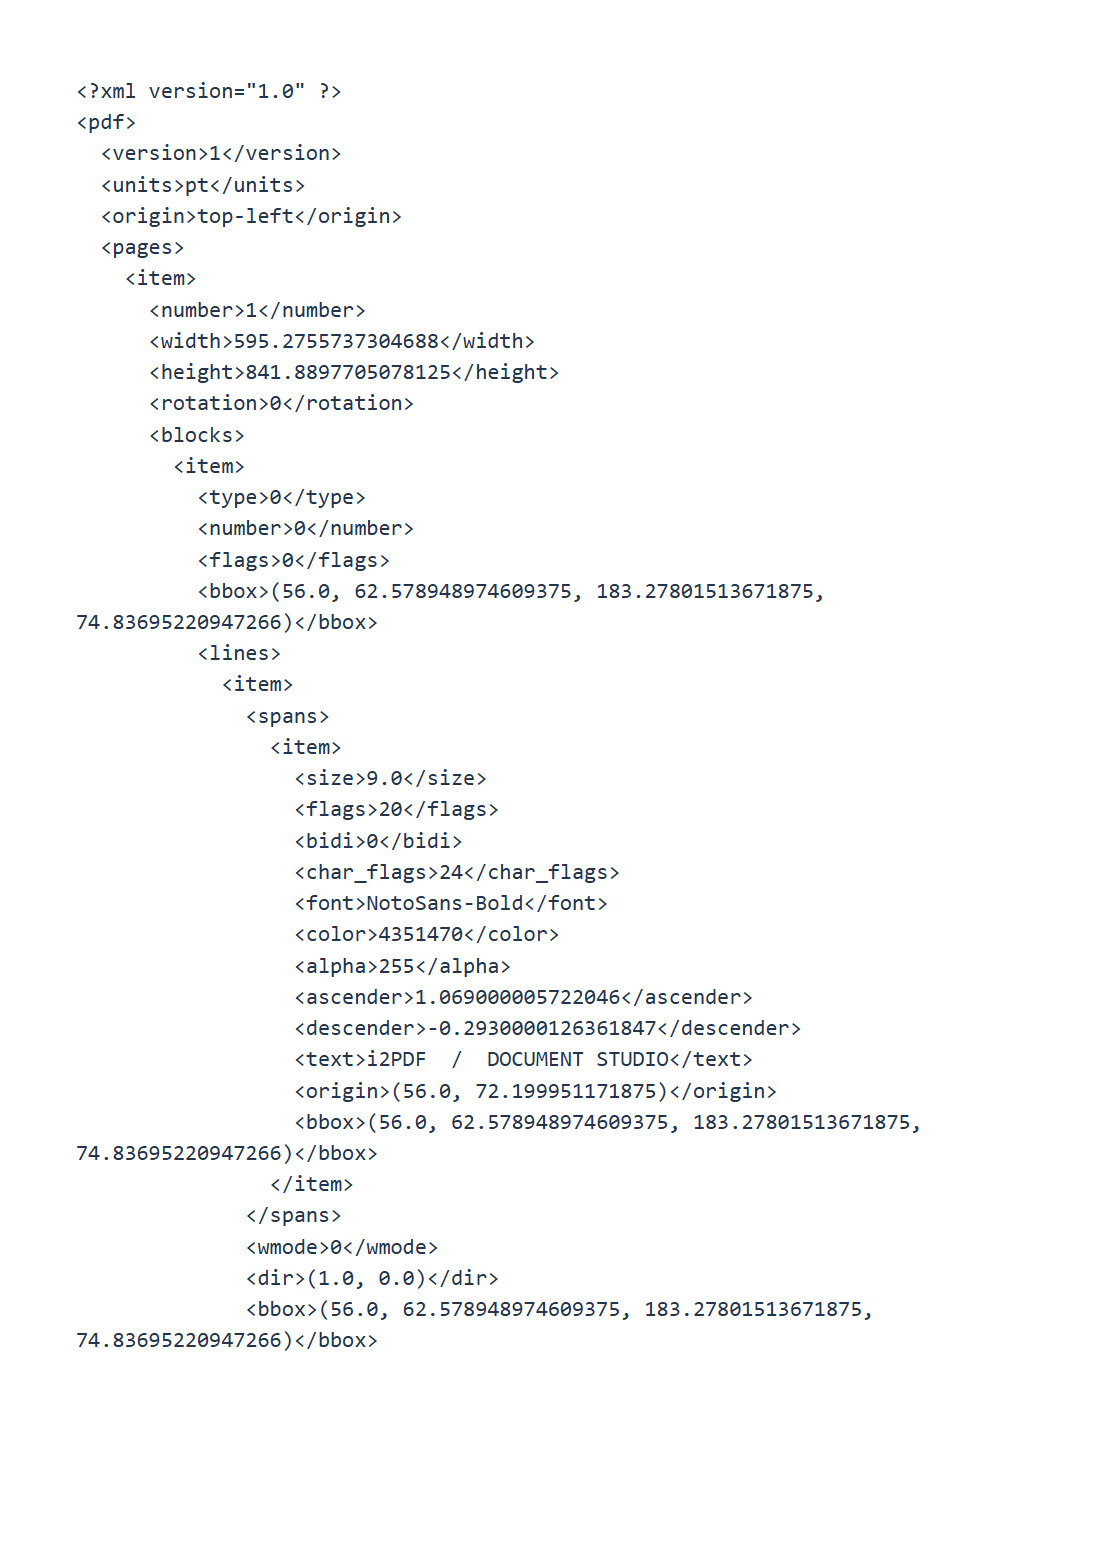

Відкрийте PDF у XML, щоб експортувати записи сторінок, текстові блоки та дані креслень. Наш чотиристорінковий PDF створює document.xml плюс одне посилане PNG-зображення всередині ZIP.
Виберіть сторінки PDF
Завантажте PDF і залиште Сторінки порожніми для всього документа або введіть потрібний піднабір. Наш приклад включає всі чотири сторінки.
Експортуйте та тримайте ресурси разом
Виберіть Початок. Експорт із графічними ресурсами завантажується як ZIP. Розпакуйте весь архів і тримайте каталог images поруч із document.xml.
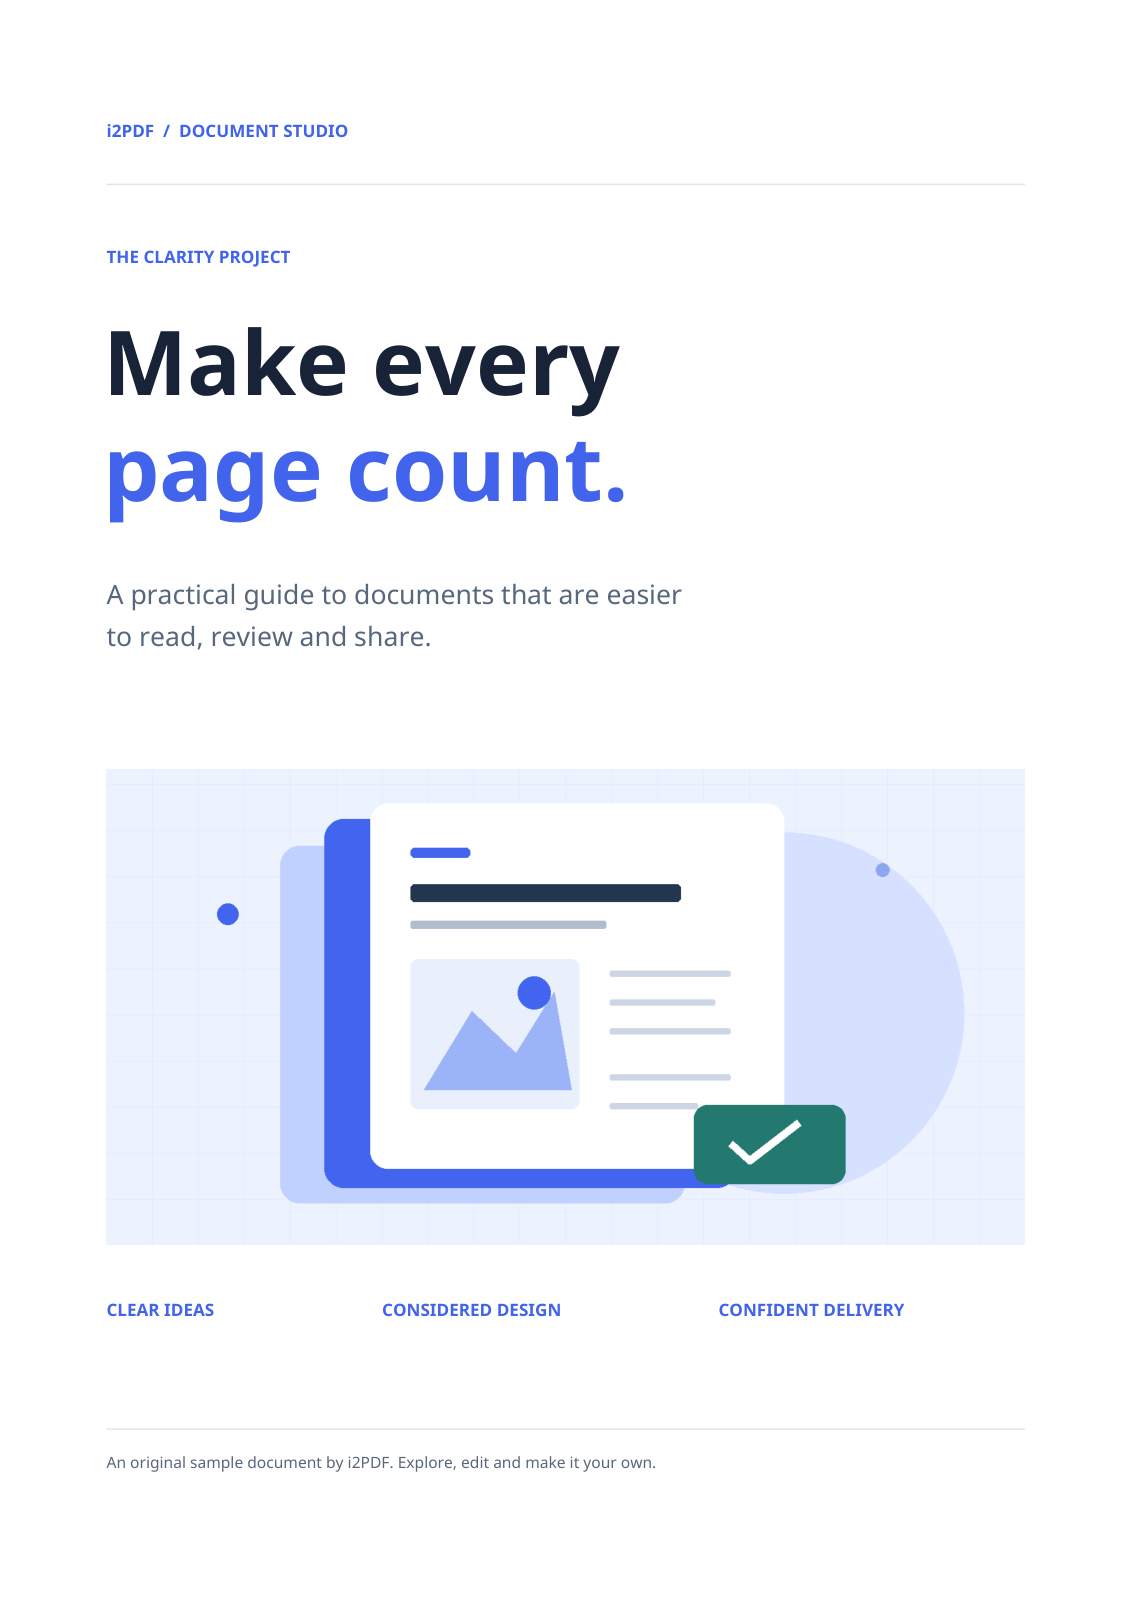
Зразок містить images/page-001-image-005.png. Посилання на зображення вказують на шляхи до ресурсів, а не вбудовують бінарні дані в XML. Експорт без графічних ресурсів можна завантажити безпосередньо як .xml.
Прочитайте структуру документа
Зразок оголошує версію 1, одиниці виміру pt та початок координат top-left. Записи сторінок включають номер вихідної сторінки, розміри, поворот, блоки та креслення. Координати описують сторінку без повороту; враховуйте поворот при накладанні даних.
Проаналізуйте XML за допомогою парсера XML. Повторювані значення використовують елементи item; деякі геометричні кортежі є текстовими значеннями. Перевірте фактичну структуру, замість того щоб припускати схему публікації, таку як DocBook.
Перевірте порядок читання та посилання на зображення відносно оригінального PDF перед використанням даних у вашому робочому процесі обробки.
Поширені запитання
Чи містить XML семантичні розділи?
Він описує вилучені дані сторінки. Значення заголовків, порядок читання та семантика документа можуть потребувати вашої власної інтерпретації.
Чому я отримав ZIP?
Зразок містить зображення. ZIP зберігає document.xml та посиланий ресурс разом, щоб зображення можна було знайти.
Спробуйте з вашим документом
Перегляньте результат, а потім збережіть потрібну версію.