

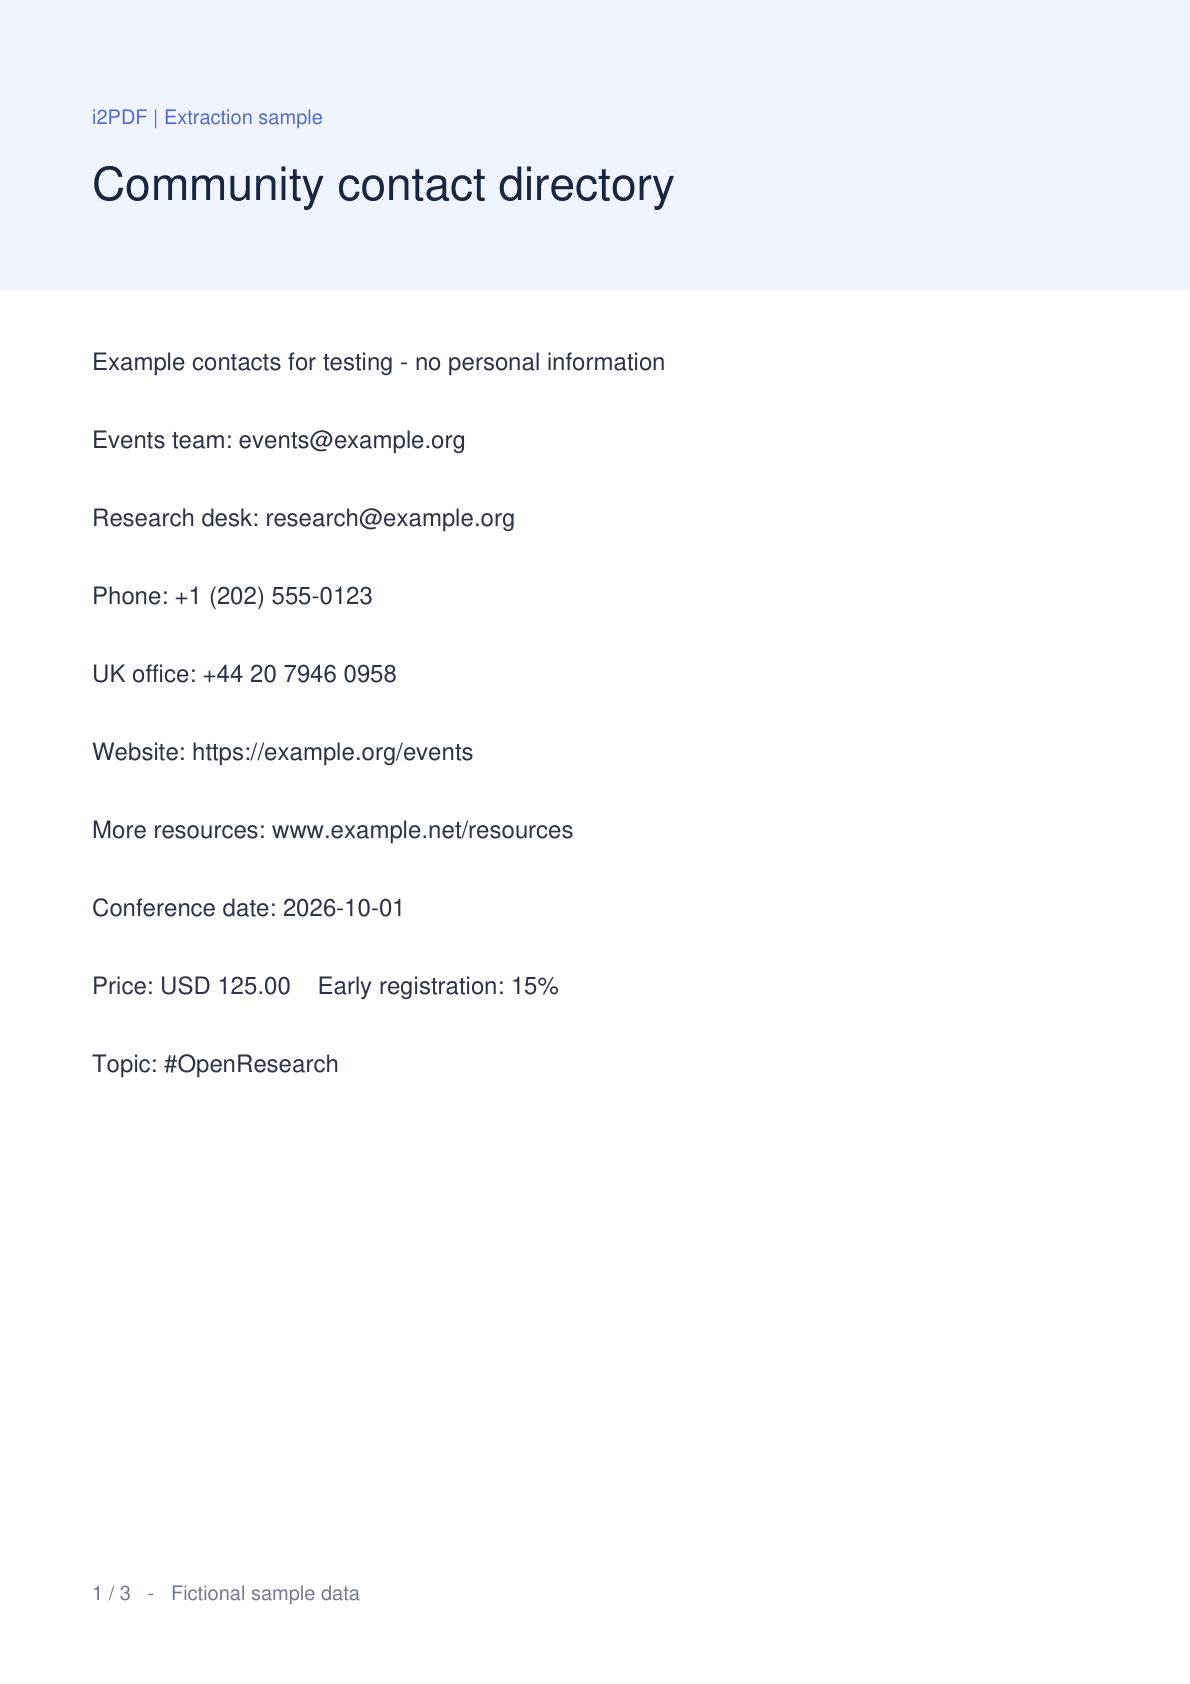
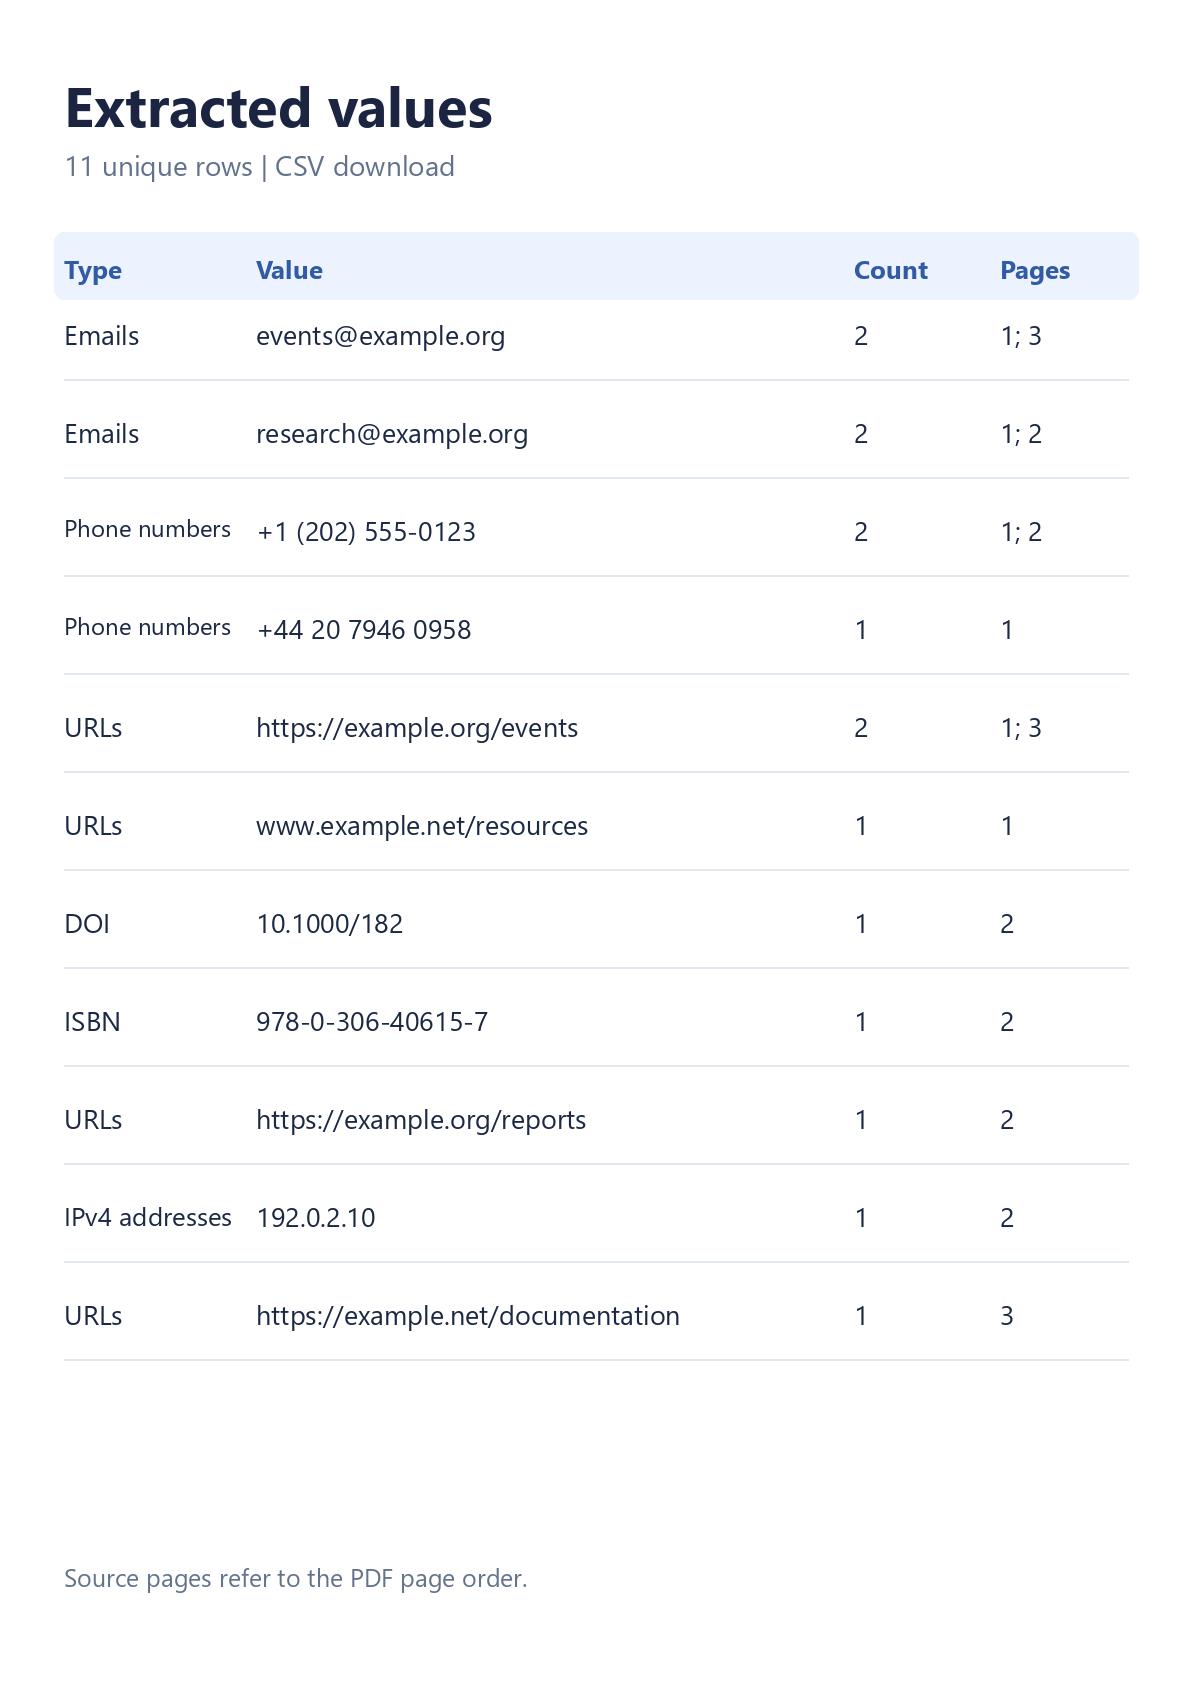

เปิด ดึงข้อมูลจาก PDF เพื่อรวบรวมค่าจากไฟล์ PDF หนึ่งไฟล์โดยไม่ต้องคัดลอกทีละบรรทัด การเปรียบเทียบนี้ใช้เอกสารตัวอย่างจริงและไฟล์ CSV ที่ดาวน์โหลดจากเครื่องมือ เมื่อเลือกอีเมล หมายเลขโทรศัพท์ URL, DOI, ISBN และ IPv4 ตัวอย่างสามหน้าจะสร้าง 11 แถวที่ไม่ซ้ำกันจาก 15 รายการที่พบ
เปิดไฟล์ PDF ของคุณ
อัปโหลดไฟล์ PDF หนึ่งไฟล์ หรือเลือก ลองใช้ตัวอย่าง เพื่อทำตามตัวอย่างนี้ การแสดงตัวอย่าง PDF และภาพขนาดย่อของหน้าจะปรากฏขึ้น ไฟล์ต้นฉบับของคุณจะไม่มีการเปลี่ยนแปลง และการดึงข้อมูลจะทำงานในเบราว์เซอร์ของคุณ
ไดเรกทอรี รายงาน เอกสารวิจัย หรือโบรชัวร์ที่เป็นข้อความคือจุดเริ่มต้นที่มีประโยชน์ การสแกนที่เป็นรูปภาพเท่านั้นจำเป็นต้องใช้ OCR ก่อนจึงจะสามารถจดจำข้อความที่พิมพ์ได้
เลือกตัวเลือกที่มีประโยชน์
บนโทรศัพท์ ให้เปิด การตั้งค่า บนเดสก์ท็อป ให้ใช้แผงการตั้งค่าข้างการแสดงตัวอย่าง
ภายใต้ สิ่งที่ต้องการดึงข้อมูล อีเมล หมายเลขโทรศัพท์ และ URL จะถูกเลือกไว้ล่วงหน้า เปิด ประเภทข้อมูลเพิ่มเติม และเลือก DOI, ISBN และ ที่อยู่ IPv4 เพิ่มเติม ปล่อยให้การลบรายการที่ซ้ำกันเปิดใช้งานอยู่และเลือก CSV
ดึงข้อมูลและตรวจสอบรายการที่ตรงกัน
เลือก ดึงข้อมูล เมื่อการประมวลผลเสร็จสิ้น แท็บ ผลลัพธ์ จะแสดงค่า จำนวนที่พบ และหน้าต้นฉบับ เลือกหมายเลขหน้าที่เป็นวงกลมเพื่อตรวจสอบตำแหน่งในตัวอย่าง PDF จากนั้นกลับไปที่ผลลัพธ์
ผลลัพธ์จะรวมรายการติดต่อเข้ากับ DOI 10.1000/182, ISBN 978-0-306-40615-7 และที่อยู่ IPv4 192.0.2.10 จากหน้า 2 คอลัมน์ประเภทจะระบุแต่ละค่า กรองคำหรือตัวระบุที่เกี่ยวข้องก่อนคัดลอกหรือดาวน์โหลดชุดข้อมูลย่อย
ใช้ กรองผลลัพธ์ เพื่อจำกัดรายการให้แคบลง การคัดลอกและการดาวน์โหลดจะรวมแถวที่ตรงกันทั้งหมด แม้ว่าตารางผลลัพธ์จะครอบคลุมหลายหน้าจอของแถวก็ตาม
ดาวน์โหลด CSV หรือ TXT
เลือก ดาวน์โหลด CSV จากนั้นใช้ปุ่ม ดาวน์โหลด หลักบนหน้าจอพร้อมใช้งาน CSV ประกอบด้วยคอลัมน์ประเภท ค่า จำนวน และหน้า TXT และ คัดลอกทั้งหมด จะมีหนึ่งค่าต่อบรรทัด
ค่า CSV ที่อาจถูกตีความว่าเป็นสูตรสเปรดชีตจะได้รับการป้องกันด้วยเครื่องหมายอะพอสทรอฟีนำหน้า ตัวอย่างเช่น หมายเลขโทรศัพท์ระหว่างประเทศจะขึ้นต้นด้วยเครื่องหมายบวก ใช้ TXT หากคุณต้องการรายการธรรมดาที่ไม่มีการป้องกันสเปรดชีต
คำถามที่พบบ่อย
เครื่องมือนี้ดึงตัวเลขหรือตัวระบุทุกตัวหรือไม่?
ไม่ แต่ละหมวดหมู่ที่เลือกมีกฎการจดจำของตัวเอง IPv6, เปอร์เซ็นต์, ราคา และหมายเลขบัตรชำระเงินจะไม่ถูกดึงออกมา ตรวจสอบการจับคู่กับแหล่งที่มา รูปแบบที่ถูกต้องไม่สามารถยืนยันได้ว่ามีผู้ติดต่อหรือตัวระบุนั้นอยู่จริง
ฉันควรทำอย่างไรกับ PDF ที่สแกนมา?
เรียกใช้ PDF OCR ก่อน จากนั้นโหลดสำเนาที่จดจำได้ลงในเครื่องมือนี้ ตรวจสอบผลลัพธ์ OCR อย่างระมัดระวัง: ตัวอักษรที่ผิดพลาดอาจเปลี่ยนที่อยู่หรือตัวระบุได้
ขีดจำกัดในการดึงข้อมูลคืออะไร?
ใช้ PDF หนึ่งไฟล์ที่มีขนาดสูงสุด 50 MiB และ 750 หน้า การดึงข้อมูลถูกจำกัดไว้ที่ 20,000 รายการโดยรวมและ 2,000 รายการต่อหน้า โดยมีงบประมาณการประมวลผล 90 วินาที ขีดจำกัดของข้อความและคำอธิบายประกอบก็มีผลเช่นกัน หากขีดจำกัดหรือหน้าที่อ่านไม่ได้ขัดจังหวะการสแกน เครื่องมือจะแสดงประกาศผลลัพธ์บางส่วนและทำเครื่องหมายชื่อไฟล์ส่งออกว่าเป็นบางส่วน
ลิงก์ใน PDF ของฉันจะถูกเปิดโดยอัตโนมัติหรือไม่?
ไม่ การดึงข้อมูลจะอ่านไฟล์ในเบราว์เซอร์และไม่เข้าชมปลายทางที่ดึงมา ปุ่มหน้าจะนำทางภายในตัวอย่าง PDF
เก็บค่าและบริบทของค่าเหล่านั้นไว้
ดึงรายการที่เน้น ตรวจสอบหน้าต้นฉบับ และดาวน์โหลดรูปแบบที่เหมาะสมกับขั้นตอนถัดไปของคุณ


