

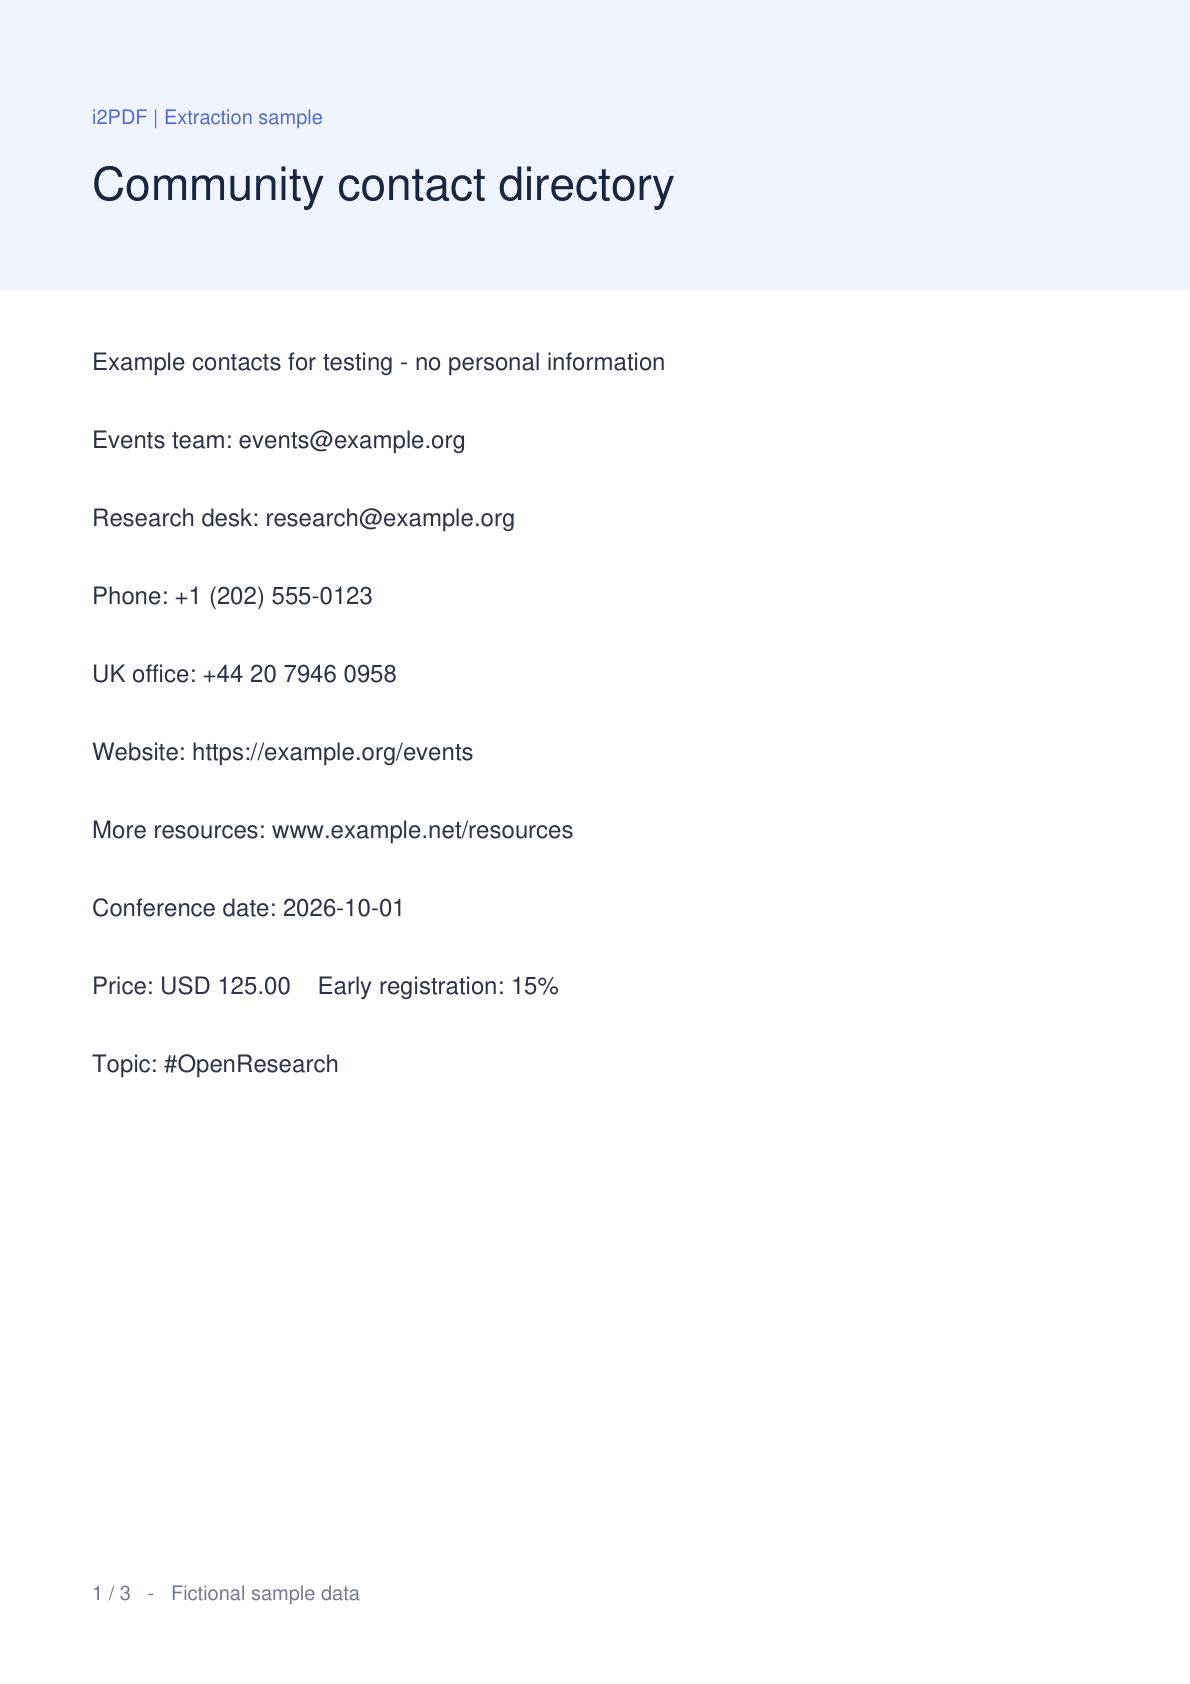
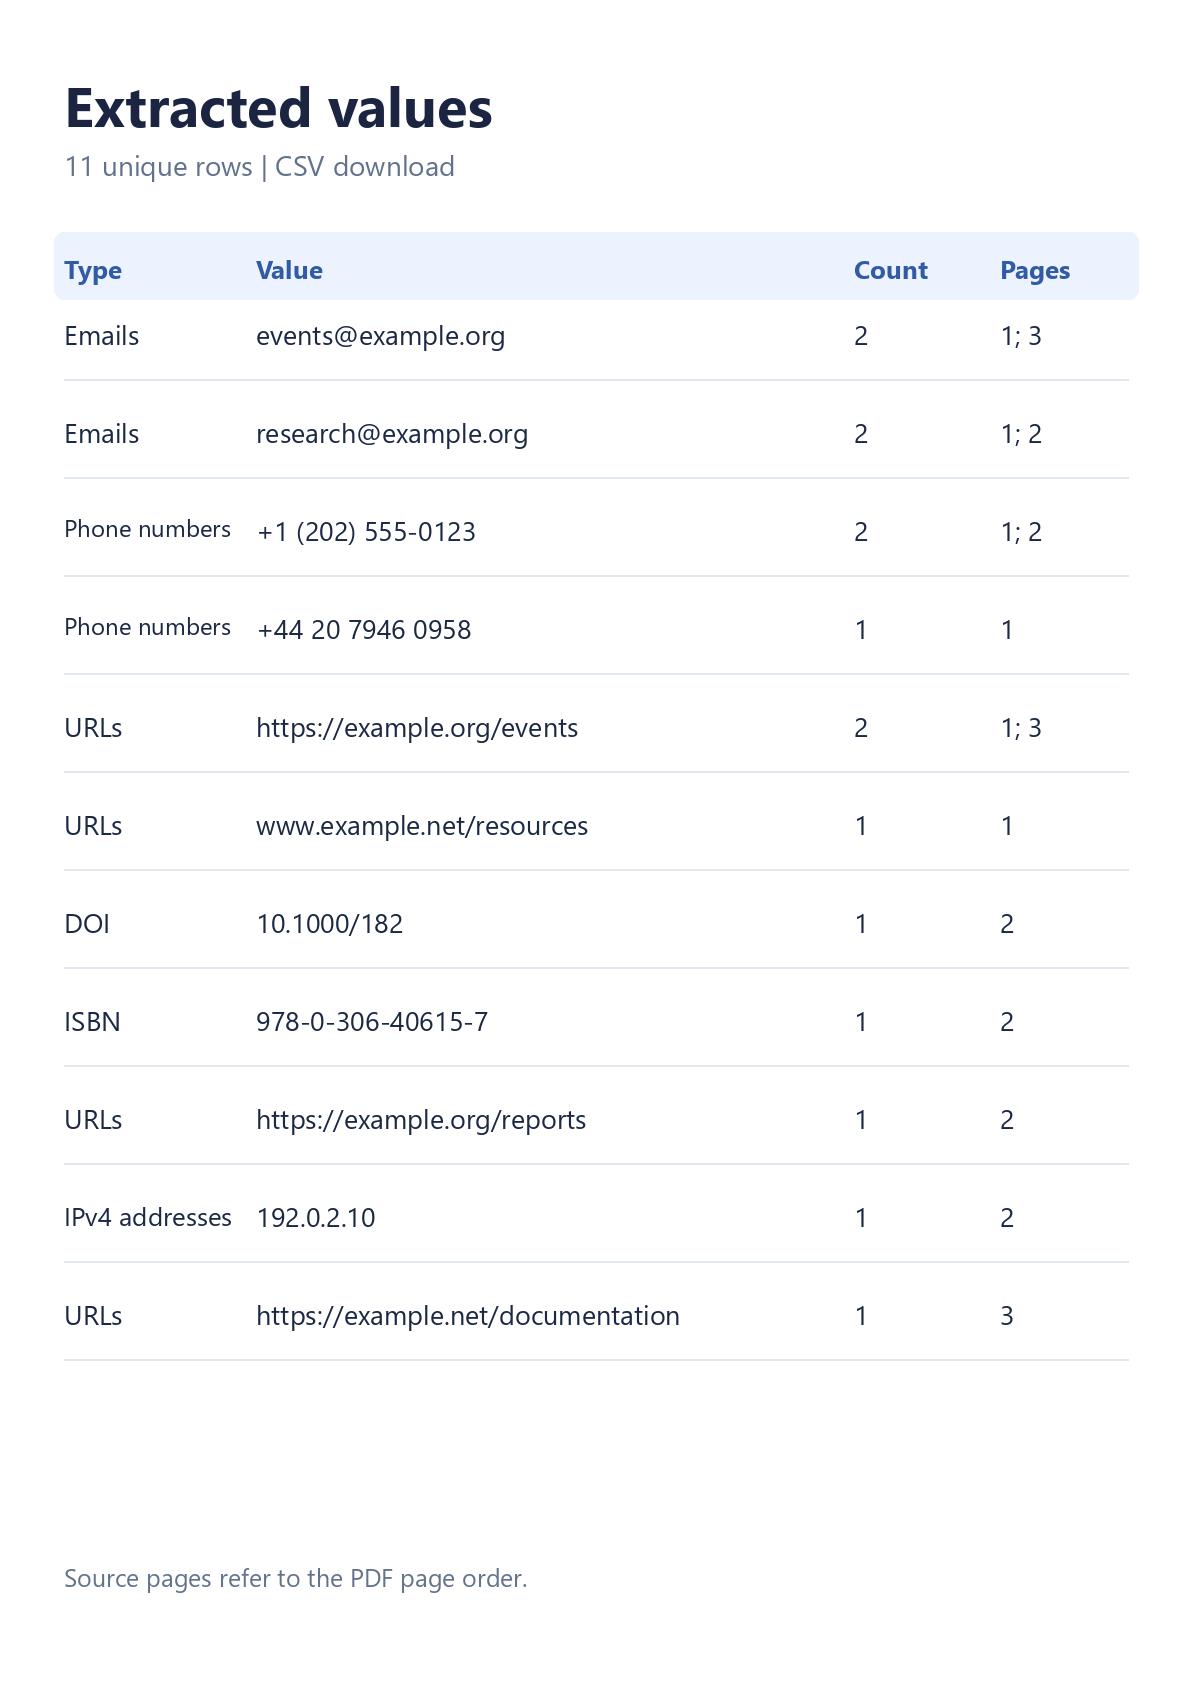

Öppna Extrahera data från PDF för att samla in värden från en PDF utan att kopiera dem rad för rad. Jämförelsen använder det faktiska exempeldokumentet och en CSV som laddats ner från verktyget. Med e-postadresser, telefonnummer, URL:er, DOI, ISBN och IPv4 valda, producerar det tresidiga exemplet 11 unika rader från 15 förekomster.
Öppna din PDF
Ladda upp en PDF, eller välj Prova exempel för att följa detta exempel. PDF-förhandsgranskningen och sidminiatyrer visas. Din originalfil förblir oförändrad och extraheringen körs i din webbläsare.
En textbaserad katalog, rapport, forskningsartikel eller broschyr är en användbar utgångspunkt. Skanningar som endast består av bilder behöver OCR innan deras tryckta text kan kännas igen.
Välj de användbara alternativen
På en telefon, öppna Inställningar. På dator, använd inställningspanelen bredvid förhandsgranskningen.
Under Vad som ska extraheras är e-postadresser, telefonnummer och URL:er förvalda. Öppna Fler datatyper och välj även DOI, ISBN och IPv4-adresser. Låt borttagning av dubbletter vara aktiverad och välj CSV.
Extrahera och kontrollera matchningarna
Välj Extrahera. När bearbetningen är klar visar fliken Resultat värdena, antal förekomster och källsidor. Välj ett cirkulärt sidnummer för att inspektera dess plats i PDF-förhandsgranskningen, och återgå sedan till Resultat.
Utdata kombinerar kontaktlistan med DOI 10.1000/182, ISBN 978-0-306-40615-7 och IPv4-adress 192.0.2.10 från sida 2. Kolumnen Typ identifierar varje värde. Filtrera till ett relevant ord eller identifierare innan du kopierar eller laddar ner en mindre delmängd.
Använd Filtrera resultat för att begränsa listan. Kopiering och nedladdning inkluderar alla matchande rader, även när resultattabellen sträcker sig över flera skärmar med rader.
Ladda ner CSV eller TXT
Välj Ladda ner CSV, använd sedan huvudknappen Ladda ner på skärmen för färdigställande. CSV innehåller kolumnerna Typ, Värde, Antal och Sidor. TXT och Kopiera alla innehåller ett värde per rad.
CSV-värden som kan tolkas som kalkylbladsformler skyddas med en inledande apostrof. Till exempel börjar ett internationellt telefonnummer med ett plustecken. Använd TXT om du behöver en enkel lista utan kalkylbladsskydd.
Vanliga frågor
Extraherar detta vilket nummer eller varje identifierare som helst?
Nej. Varje vald kategori har sina egna igenkänningsregler. IPv6, procentsatser, priser och betalkortsnummer extraheras inte. Granska matchningar mot källan; giltig formatering kan inte bekräfta att en kontakt eller identifierare existerar.
Vad ska jag göra med en skannad PDF?
Kör PDF-OCR först, ladda sedan in den igenkända kopian i detta verktyg. Kontrollera OCR-utdata noggrant: ett felaktigt tecken kan ändra en adress eller identifierare.
Vilka är extraheringsgränserna?
Använd en PDF på upp till 50 MiB och 750 sidor. Extrahering är begränsad till totalt 20 000 matchningar och 2 000 per sida, med en bearbetningsbudget på 90 sekunder. Gränser för text och anteckningar gäller också. Om en gräns eller en oläsbar sida avbryter skanningen, visar verktyget ett meddelande om partiella resultat och markerar exportfilnamnet som partiellt.
Öppnas mina PDF-länkar automatiskt?
Nej. Extrahering läser filen i webbläsaren och besöker inte extraherade destinationer. Sidknappar navigerar inom PDF-förhandsgranskningen.
Behåll värdena och deras sammanhang
Extrahera en fokuserad lista, kontrollera källsidorna och ladda ner det format som passar ditt nästa steg.


