

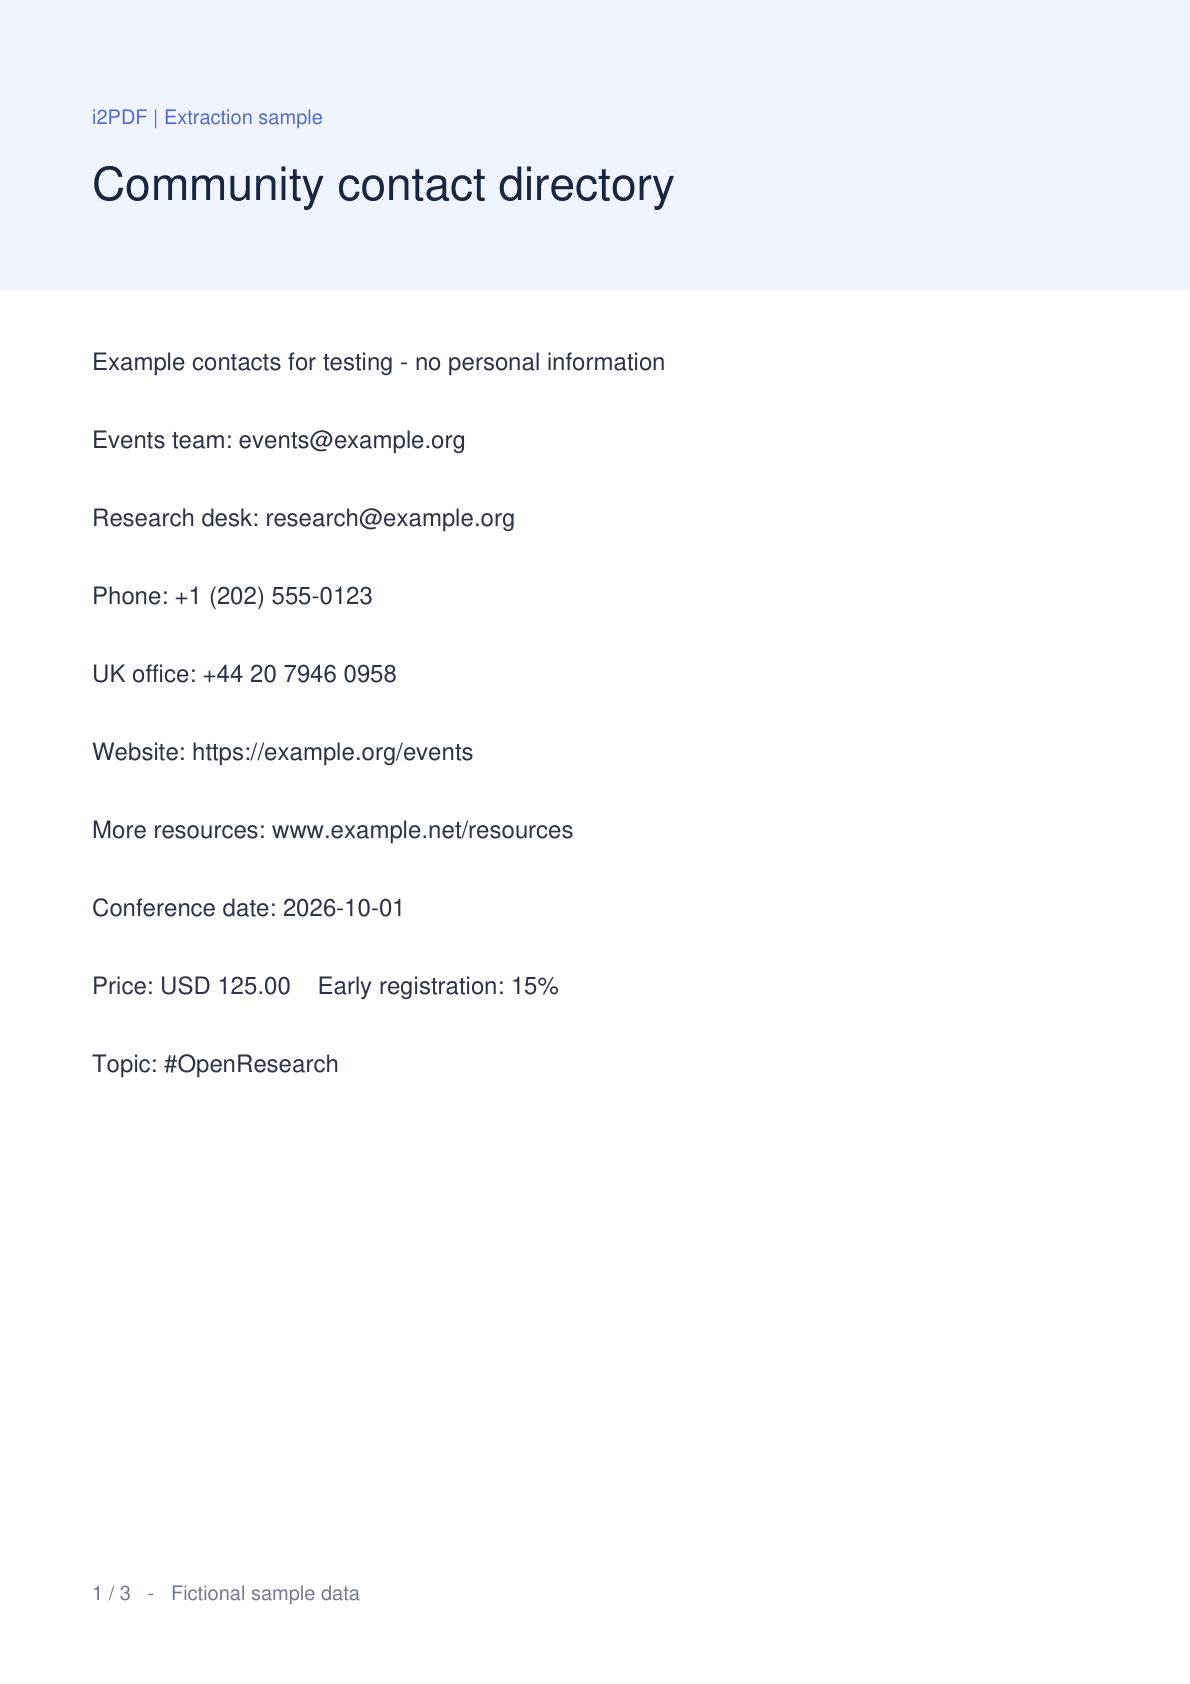
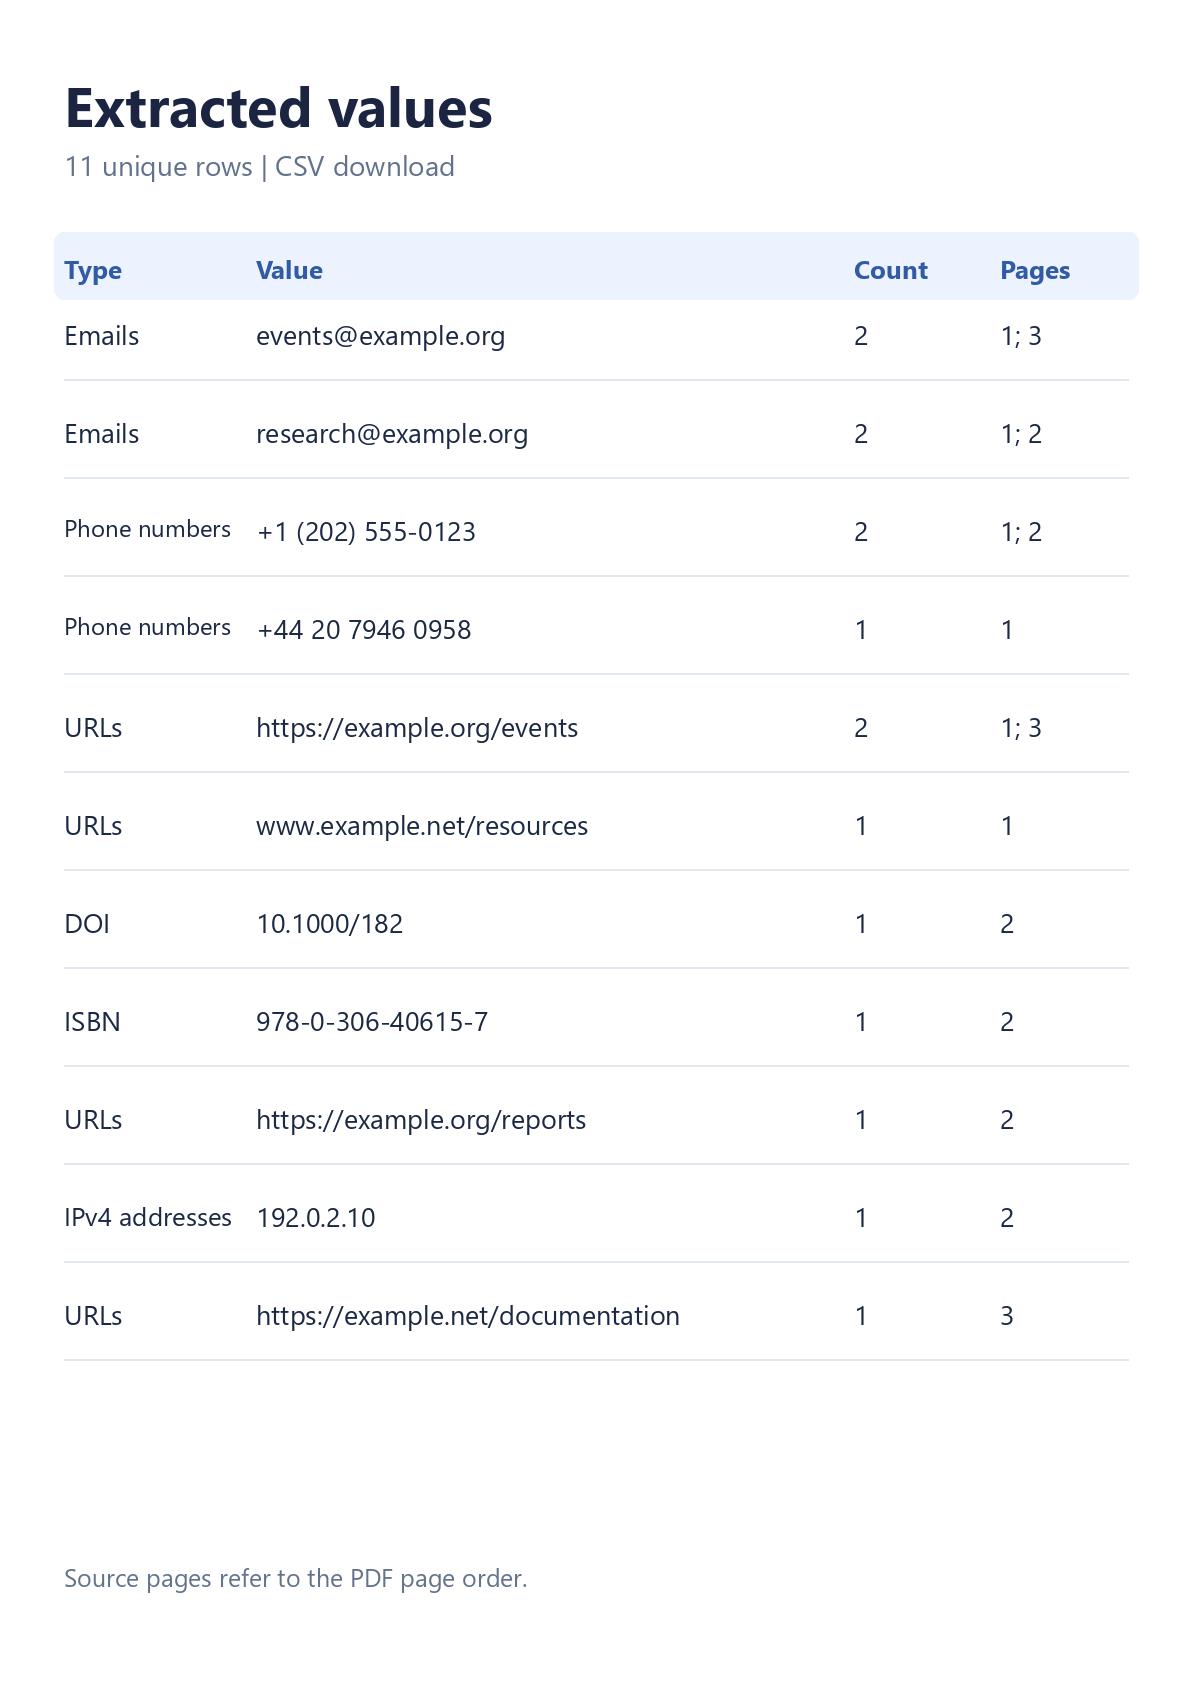

Otevřete Extrakce dat z PDF pro sběr hodnot z jednoho PDF bez nutnosti kopírování řádek po řádku. Porovnání využívá skutečný vzorový dokument a CSV stažené z nástroje. S vybranými e-maily, telefony, URL, DOI, ISBN a IPv4 vytvoří třístránková ukázka 11 unikátních řádků z 15 výskytů.
Otevřete své PDF
Nahrajte jedno PDF nebo vyberte Vyzkoušet ukázku pro sledování tohoto příkladu. Zobrazí se náhled PDF a miniatury stran. Váš původní soubor zůstane nezměněn a extrakce proběhne ve vašem prohlížeči.
Textový adresář, zpráva, výzkumná práce nebo brožura jsou užitečným výchozím bodem. Skenované dokumenty obsahující pouze obrázky vyžadují před rozpoznáním tištěného textu OCR.
Zvolte užitečné možnosti
Na telefonu otevřete Nastavení. Na počítači použijte panel nastavení vedle náhledu.
V sekci Co extrahovat jsou e-maily, telefonní čísla a URL adresy vybrány automaticky. Otevřete Další datové typy a vyberte také DOI, ISBN a IPv4 adresy. Ponechte zapnuté odstranění duplicit a zvolte CSV.
Extrahujte a zkontrolujte shody
Vyberte Extrahovat. Po dokončení zpracování zobrazí karta Výsledky hodnoty, počty výskytů a zdrojové strany. Vyberte číslo strany v kroužku pro kontrolu jejího umístění v náhledu PDF, poté se vraťte k výsledkům.
Výstup kombinuje seznam kontaktů s DOI 10.1000/182, ISBN 978-0-306-40615-7 a IPv4 adresou 192.0.2.10 ze strany 2. Sloupec Typ identifikuje každou hodnotu. Před kopírováním nebo stažením menší podmnožiny filtrujte podle relevantního slova nebo identifikátoru.
Použijte Filtrovat výsledky pro zúžení seznamu. Kopírování a stahování zahrnuje všechny odpovídající řádky, i když tabulka výsledků přesahuje několik obrazovek.
Stáhněte CSV nebo TXT
Vyberte Stáhnout CSV, poté použijte hlavní tlačítko Stažení na obrazovce připravenosti. CSV obsahuje sloupce Typ, Hodnota, Počet a Stránky. TXT a Kopírovat vše obsahují jednu hodnotu na řádek.
Hodnoty v CSV, které by mohly být interpretovány jako vzorce tabulkového procesoru, jsou chráněny úvodním apostrofem. Například mezinárodní telefonní číslo začíná znakem plus. Pokud potřebujete prostý seznam bez ochrany tabulkového procesoru, použijte TXT.
Časté dotazy
Extrahuje to jakékoliv číslo nebo každý identifikátor?
Ne. Každá vybraná kategorie má svá vlastní pravidla rozpoznávání. IPv6, procenta, ceny a čísla platebních karet nejsou extrahovány. Shody porovnejte se zdrojem; platný formát nemůže potvrdit, že kontakt nebo identifikátor skutečně existuje.
Co mám dělat se skenovaným PDF?
Nejprve spusťte PDF OCR, poté načtěte rozpoznanou kopii do tohoto nástroje. Výstup OCR pečlivě zkontrolujte: chybný znak může změnit adresu nebo identifikátor.
Jaké jsou limity extrakce?
Použijte jedno PDF do velikosti 50 MiB a 750 stran. Extrakce je omezena na 20 000 celkových shod a 2 000 shod na stranu, s rozpočtem zpracování 90 sekund. Platí také limity pro text a anotace. Pokud limit nebo nečitelná strana přeruší skenování, nástroj zobrazí upozornění na částečné výsledky a označí název exportovaného souboru jako částečný.
Otevírají se mé PDF odkazy automaticky?
Ne. Extrakce čte soubor v prohlížeči a nenavštěvuje extrahované cíle. Tlačítka stran slouží k navigaci v náhledu PDF.
Ponechte si hodnoty a jejich kontext
Extrahujte cílený seznam, zkontrolujte zdrojové strany a stáhněte formát, který vyhovuje vašemu dalšímu kroku.


